

brave أو google أو exa. وتكلّف جميعها المبلغ نفسه، $0.01 لكل عملية بحث، لذا فالسؤال البديهي هو: أيّها يجب أن تستخدم فعلًا؟
في هذا المقال سنكتشف ذلك. بنينا اختبارًا معياريًا يرسل الأسئلة الـ 162 نفسها إلى كل موفّر، ويجعل النموذج نفسه يجيب من نتائج كل موفّر، ثم يقيّم النتائج والإجابات معًا. سنستعرض كيف اخترنا الأسئلة، وما الذي وجدناه، وكيف يمكنك تشغيله بنفسك.
هل تريد الشيفرة الكاملة؟ اطّلع على مستودع GitHub. يحتوي أيضًا على كل إجابة وقائمة نتائج كل موفّر من هذا التشغيل، لتتمكن من التحقق من عملنا دون دفع تكلفة تشغيل.
ما الذي قسناه
هناك أمران مختلفان يمكن أن يتفوق فيهما موفّر البحث، ولا يتوافقان دائمًا:- الاسترجاع: هل النتائج ذات صلة، وهل تحتوي فعلًا على الإجابة؟
- الإجابات: عندما تمرّر تلك النتائج إلى نموذج، هل يجيب إجابة صحيحة؟
POST /augment/search مرة واحدة لكل موفّر، مع ضبط limit على 10. ثم يجيب zai-org-glm-5-2 من نتائج كل موفّر، ويقيّم grok-4-7 كل شيء عند درجة حرارة 0. ويجيب النموذج أيضًا دون أي بحث، كخط أساس.
لاحظ أن الموفّرين لا يعيدون الكمية نفسها من النص، ولا حتى النوع نفسه. في تشغيلنا، أعاد Exa عشر نتائج لكل عملية بحث وأعاد Brave ما بين 7 و10، وكلها مقاطع مطابقة للسؤال بطول يتراوح بين 1,500 و1,700 حرف تقريبًا لكل منها. وأعاد Google خمس نتائج، وهو ما تعيده واجهة Venice لـ google مهما كانت قيمة limit. كان معظمها النص الكامل للصفحة بدءًا من أعلاها: قوائم التنقل وأشرطة ملفات تعريف الارتباط وكل شيء. لكن ليس جميعها: فعندما يحظر موقع ما الاستخراج، مثل Reddit أو Facebook أو Stack Overflow أو YouTube، تكون النتيجة مقتطف البحث فقط. في إعادة تشغيل بتاريخ 11 نوفمبر، كان ربع أفضل 5 نتائج من Google يحتوي على أقل من 300 حرف من النص. وبلغ ذلك نحو 9,700 حرف لكل نتيجة، أو 48,000 لكل عملية بحث، مقابل نحو 14,000 لكل من Brave وExa. قد يعني النص الأكثر إجابات أفضل، لكنه يعني أيضًا رموز إدخال أكثر في كل طلب. ولمعرفة مدى أهمية الحجم، يجيب النموذج من نتائج كل موفّر بثلاث طرق:
في الحالتين المحددتين بميزانية، يحصل كل موفّر على العدد نفسه من النتائج والمساحة نفسها. وبما أن الأداة تحتفظ ببداية كل نتيجة، فإنهما تختبران أيضًا مدى صمود نتائج كل موفّر عند اقتطاعها، وهو ما تفعله كثير من خطوط الأنابيب الحقيقية.
الأسئلة
كانت النسخة الأولى من هذا الاختبار تعاني من مشكلة: فبدون بحث، كان النموذج يجيب بالفعل عن 72% من الأسئلة التي استطعنا تقييمها، فبدت الموفّرات الثلاثة متقاربة تقريبًا. إذا كان النموذج يعرف الإجابة مسبقًا، فلن يُحدث البحث فرقًا كبيرًا، ولن يخبرك أيّ موفّر أفضل. لذلك جمعنا في هذا التشغيل 156 سؤالًا ذات إجابات مرجعية، يجب أن تأتي إجابتها من بحث:
تأتي الأسئلة البرمجية بأنماط مختلفة، من رسائل خطأ ملصوقة إلى أسئلة مرتبطة بإصدار محدد مثل “Which ripgrep version started respecting the GIT_CONFIG_GLOBAL environment variable?”. هذا مقصود: فمحرك البحث البارع في اللغة الطبيعية قد يتعثر مع سلسلة خطأ. وهناك أيضًا 6 أسئلة عامة بلا إجابة مرجعية، مثل الأسئلة الحوارية الطويلة، وسنعود إليها لاحقًا.
مرّ كل سؤال ذي إجابة مرجعية بالفحوص نفسها قبل قبوله. صغنا كل سؤال باستخدام وكلاء ذكاء اصطناعي من مصدر أولي، مثل ملاحظة إصدار أو بيان صحفي رسمي، وجلب نص برمجي كل مصدر للتأكد من أن الاقتباس الذي تستند إليه الإجابة المرجعية موجود فعلًا في الصفحة. ثم أجاب النموذج عن كل سؤال مرتين دون بحث، واستبعدنا أي سؤال أجاب عنه بشكل صحيح في أيٍّ من المرتين.
بالنسبة لأسئلة الأخبار والموضوعات الحساسة، أعطينا النموذج أيضًا اقتباسات المصدر كنتائج بحث، ولم نحتفظ بالسؤال إلا إذا أجاب عنه بشكل صحيح في المرتين. يكشف هذا الأسئلة الغامضة، ويتحقق من أن النموذج سيجيب عن سؤال حساس عندما يتوفر لديه المصدر. وأخيرًا، راجع وكيل آخر كل سؤال وإجابة مرجعية مقابل المصادر، ما أدى إلى 47 تعديلًا واستبعاد 3 أسئلة أخرى، وأُعيد كل سؤال معدّل إلى فحص عدم البحث.
لاحظ أن هذا يجعل خط الأساس بدون بحث قريبًا من الصفر عن قصد، لذا فهو لا يخبرك بعدد المرات التي يساعد فيها البحث عمومًا. ما يخبرك به هو أن كل سؤال في المجموعة يحتاج إلى بحث، وهذا بالضبط ما نريده عند مقارنة موفّري البحث.
المقاييس
تأتي الدقة مع فاصل ثقة 95%، وتأتي الفروق بين الموفّرين من مقارنات مزدوجة على الأسئلة نفسها: فاصل bootstrap واختبار McNemar الدقيق. مع 156 إجابة مرجعية، يساوي كل سؤال نحو 0.6 نقطة مئوية، وتصل فواصل الدقة إلى نحو ±7 نقاط، لذا من المفيد مراجعة المقارنات المزدوجة قبل استخلاص الكثير من فارق صغير.
النتائج
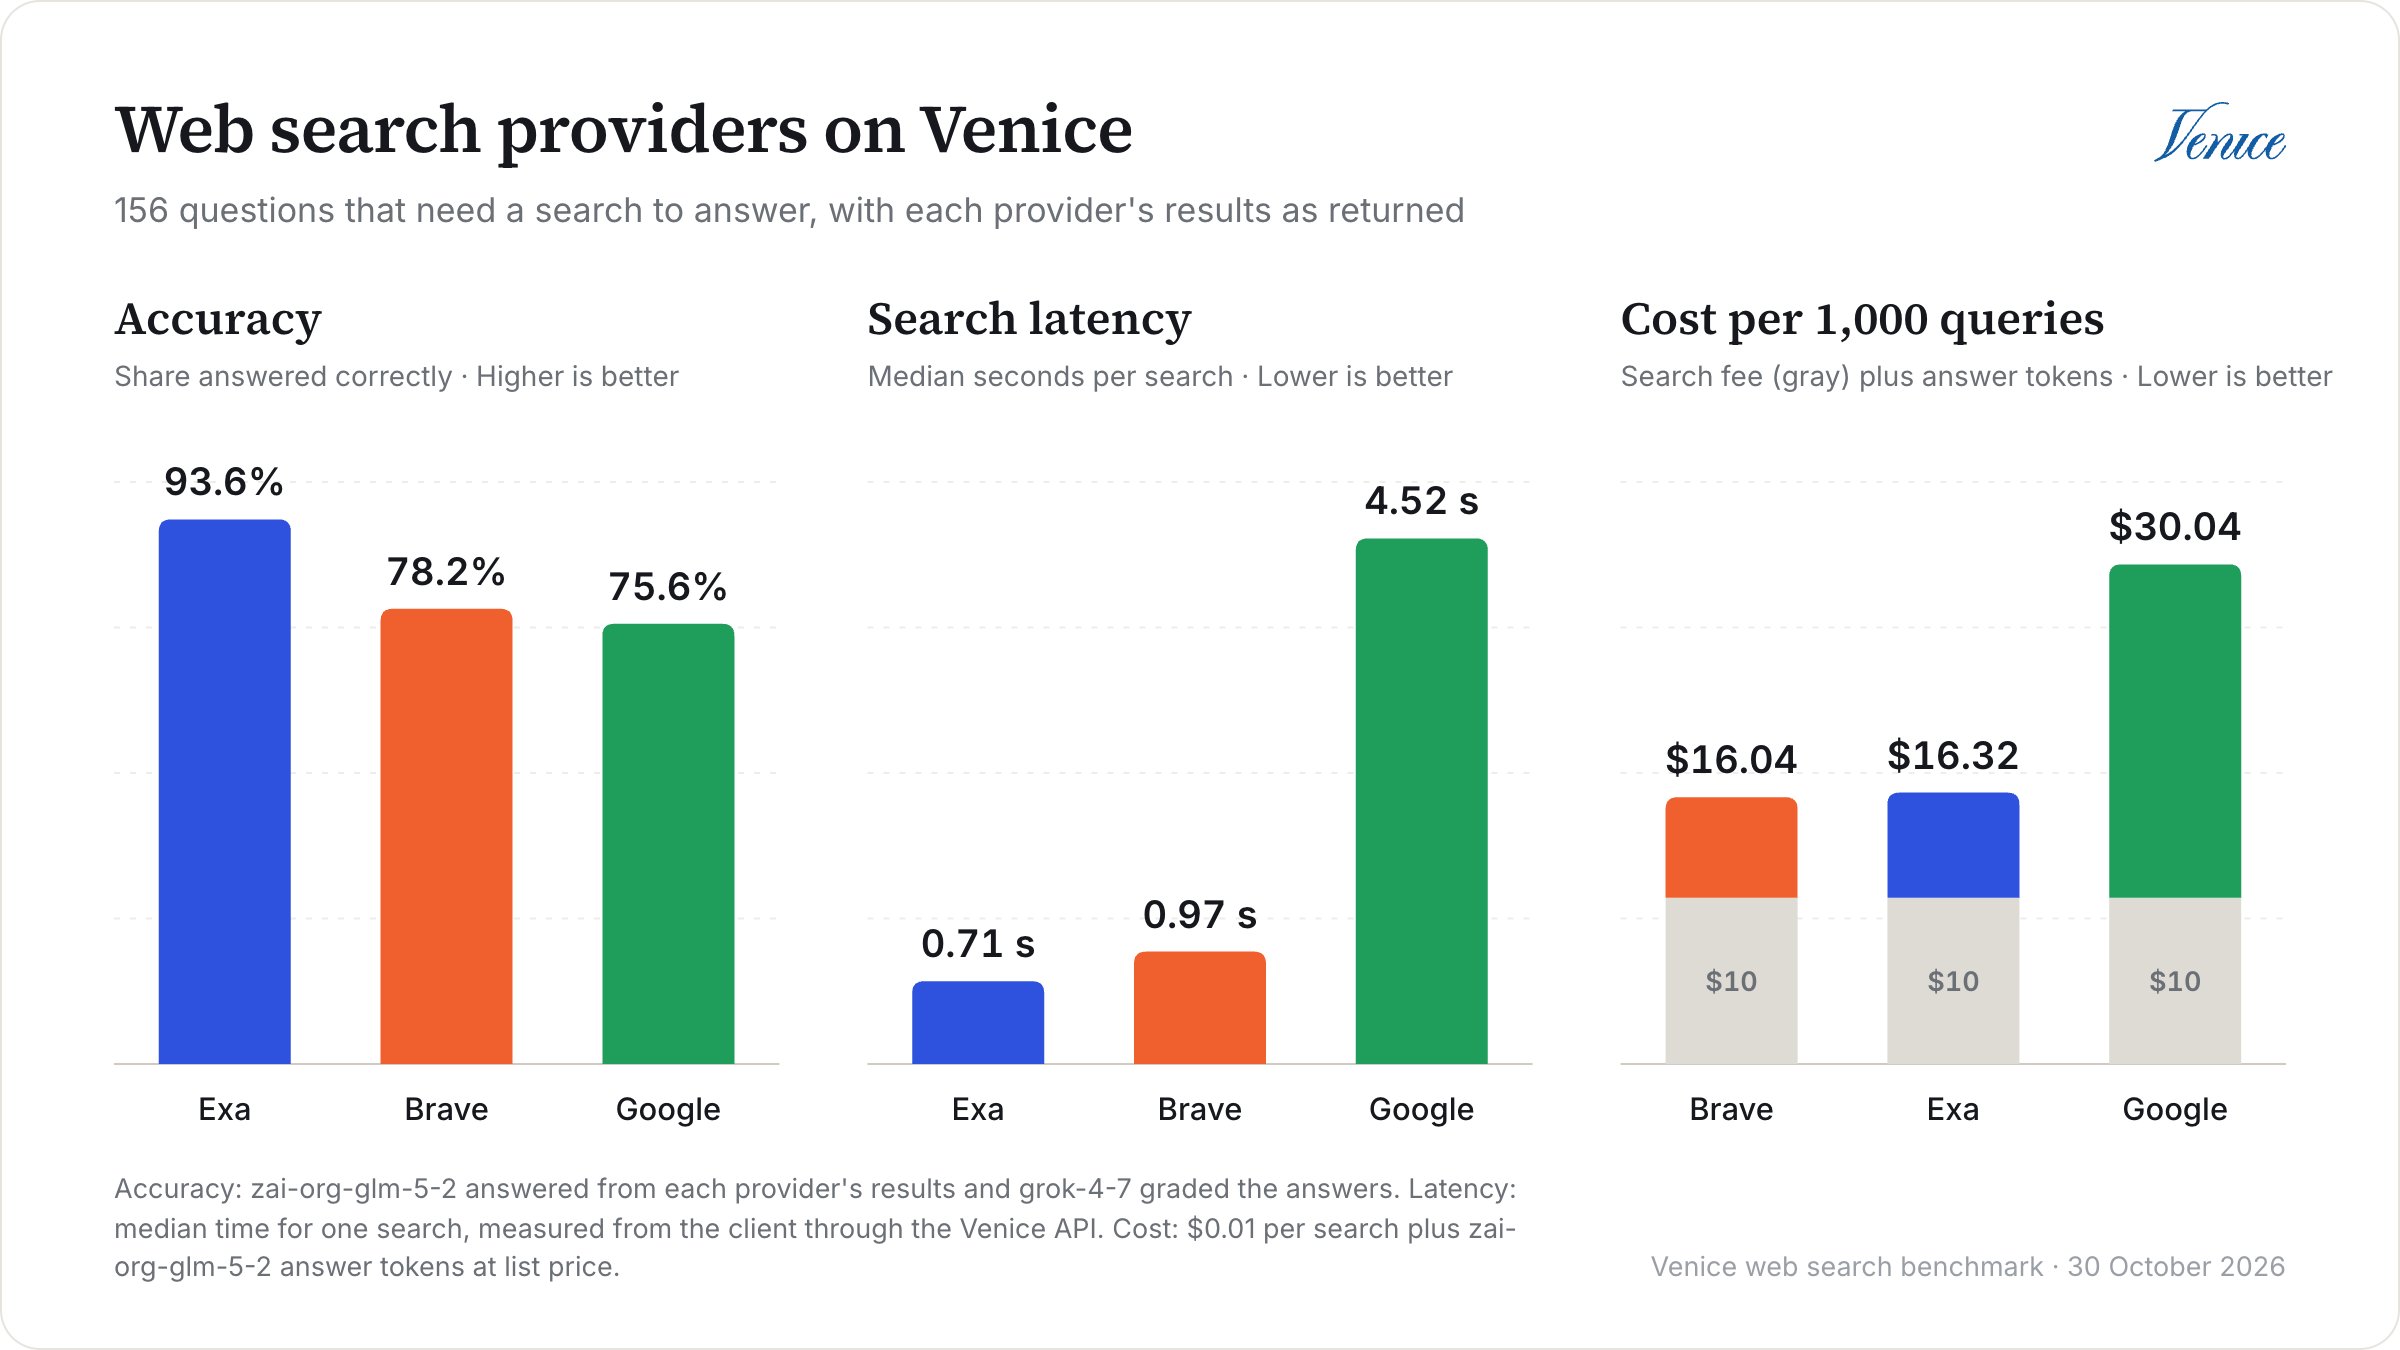
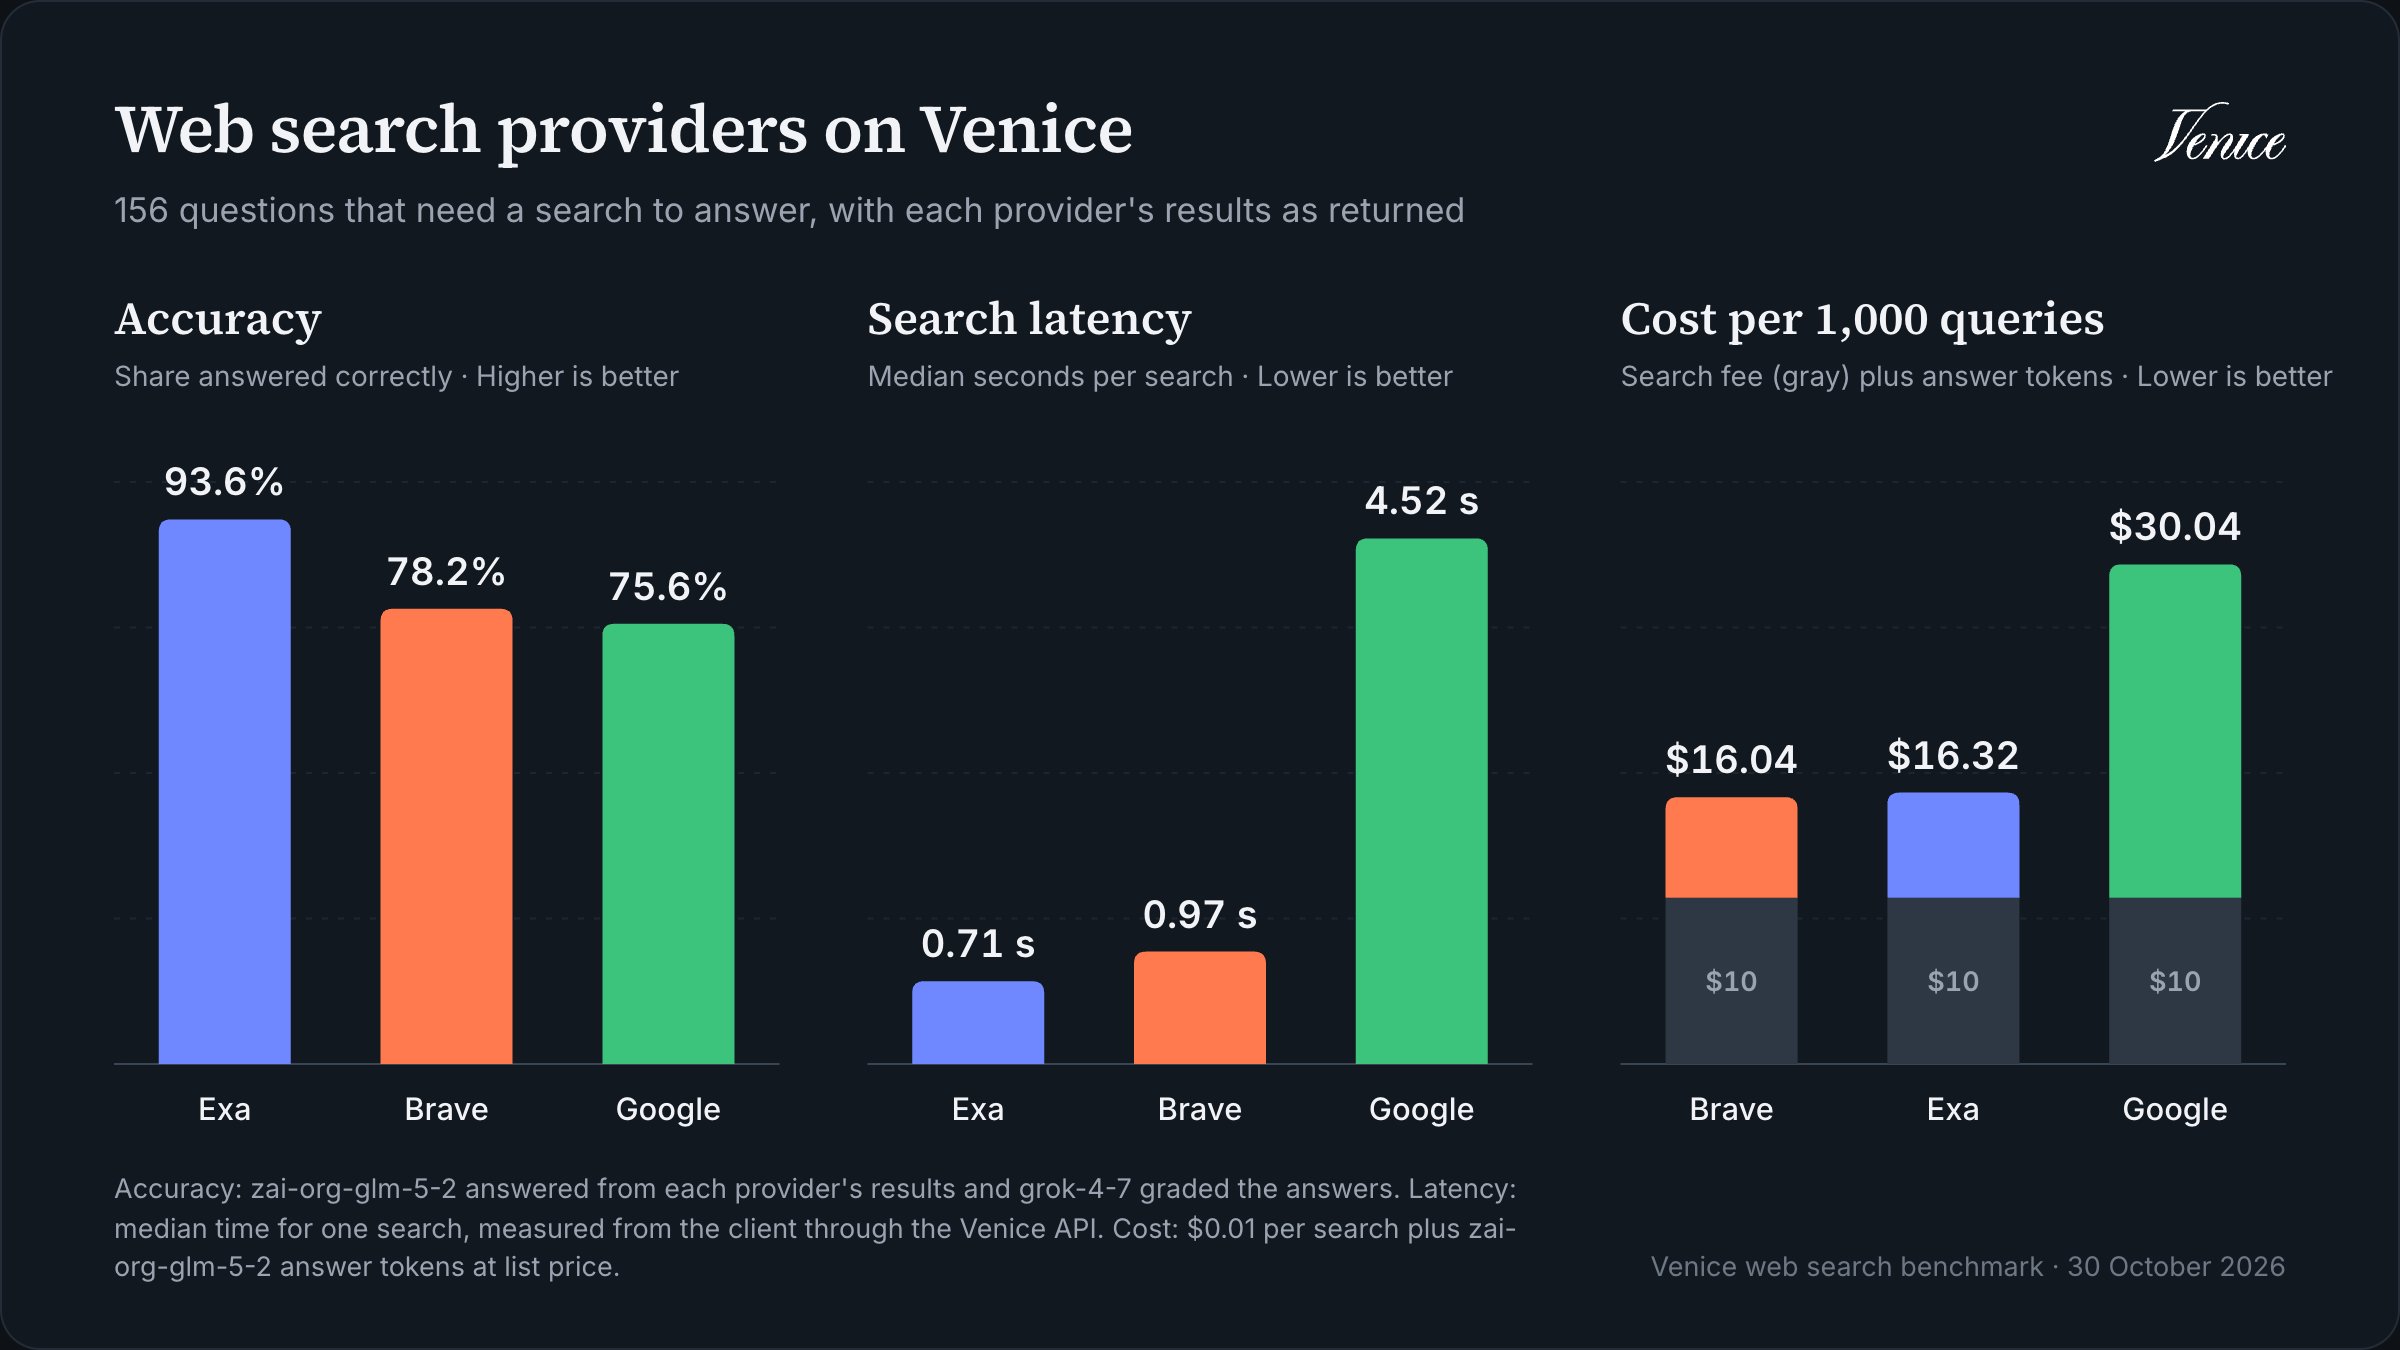
أجاب Exa عن أكبر عدد من الأسئلة بشكل صحيح
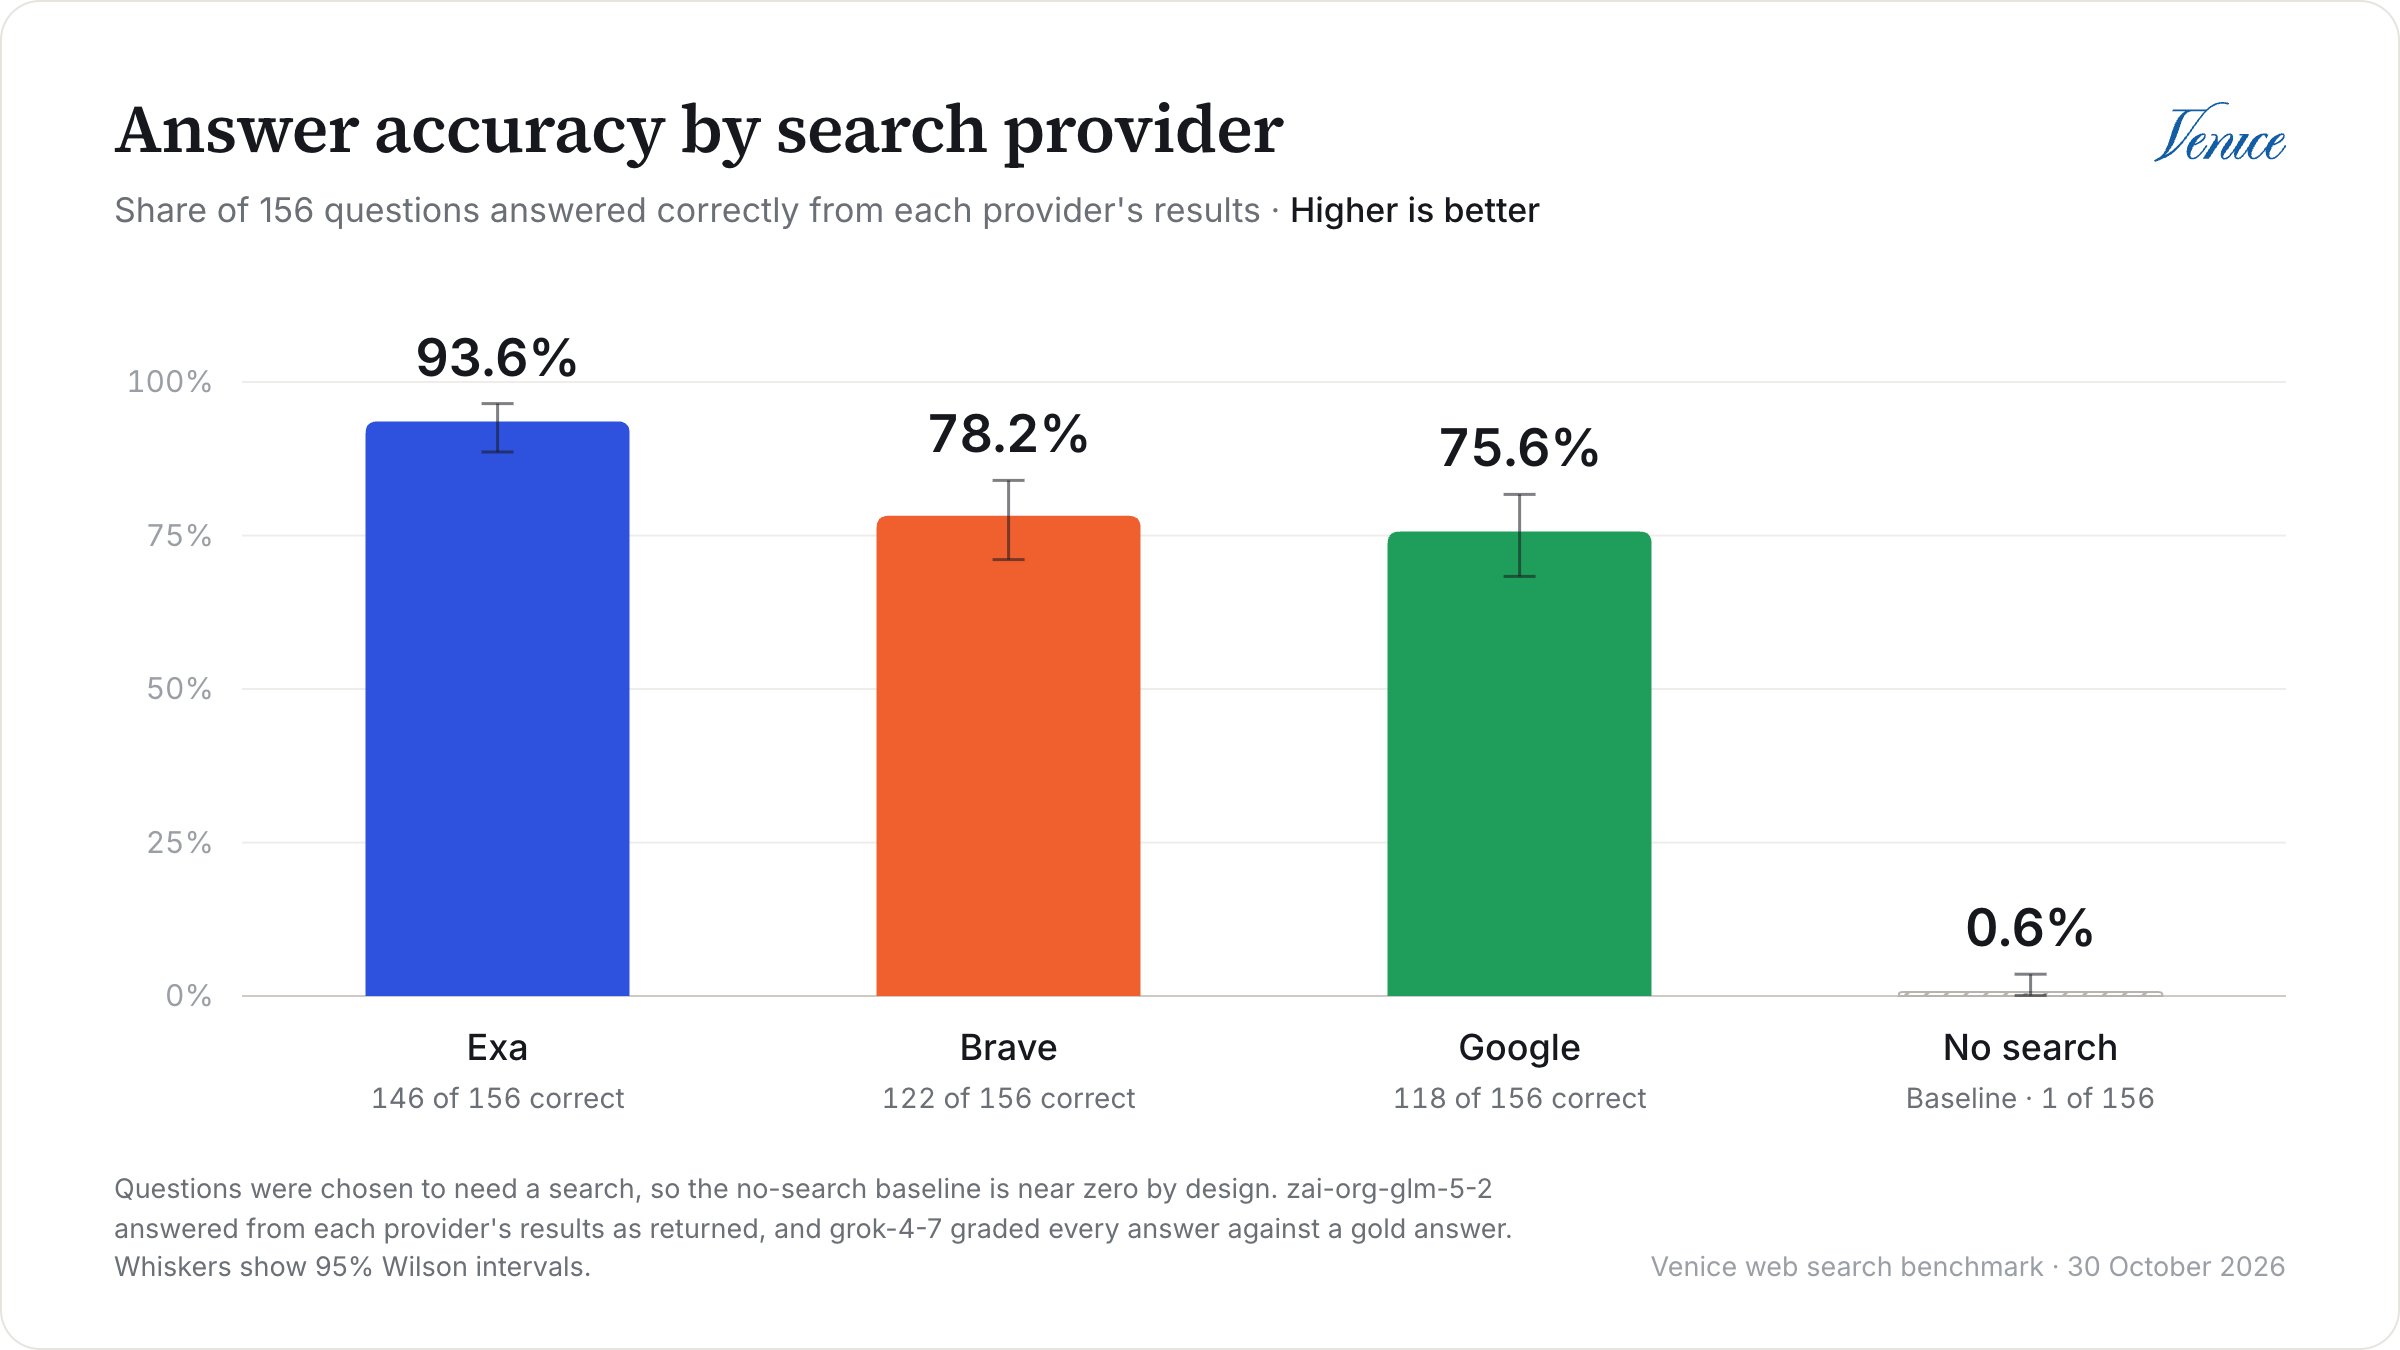
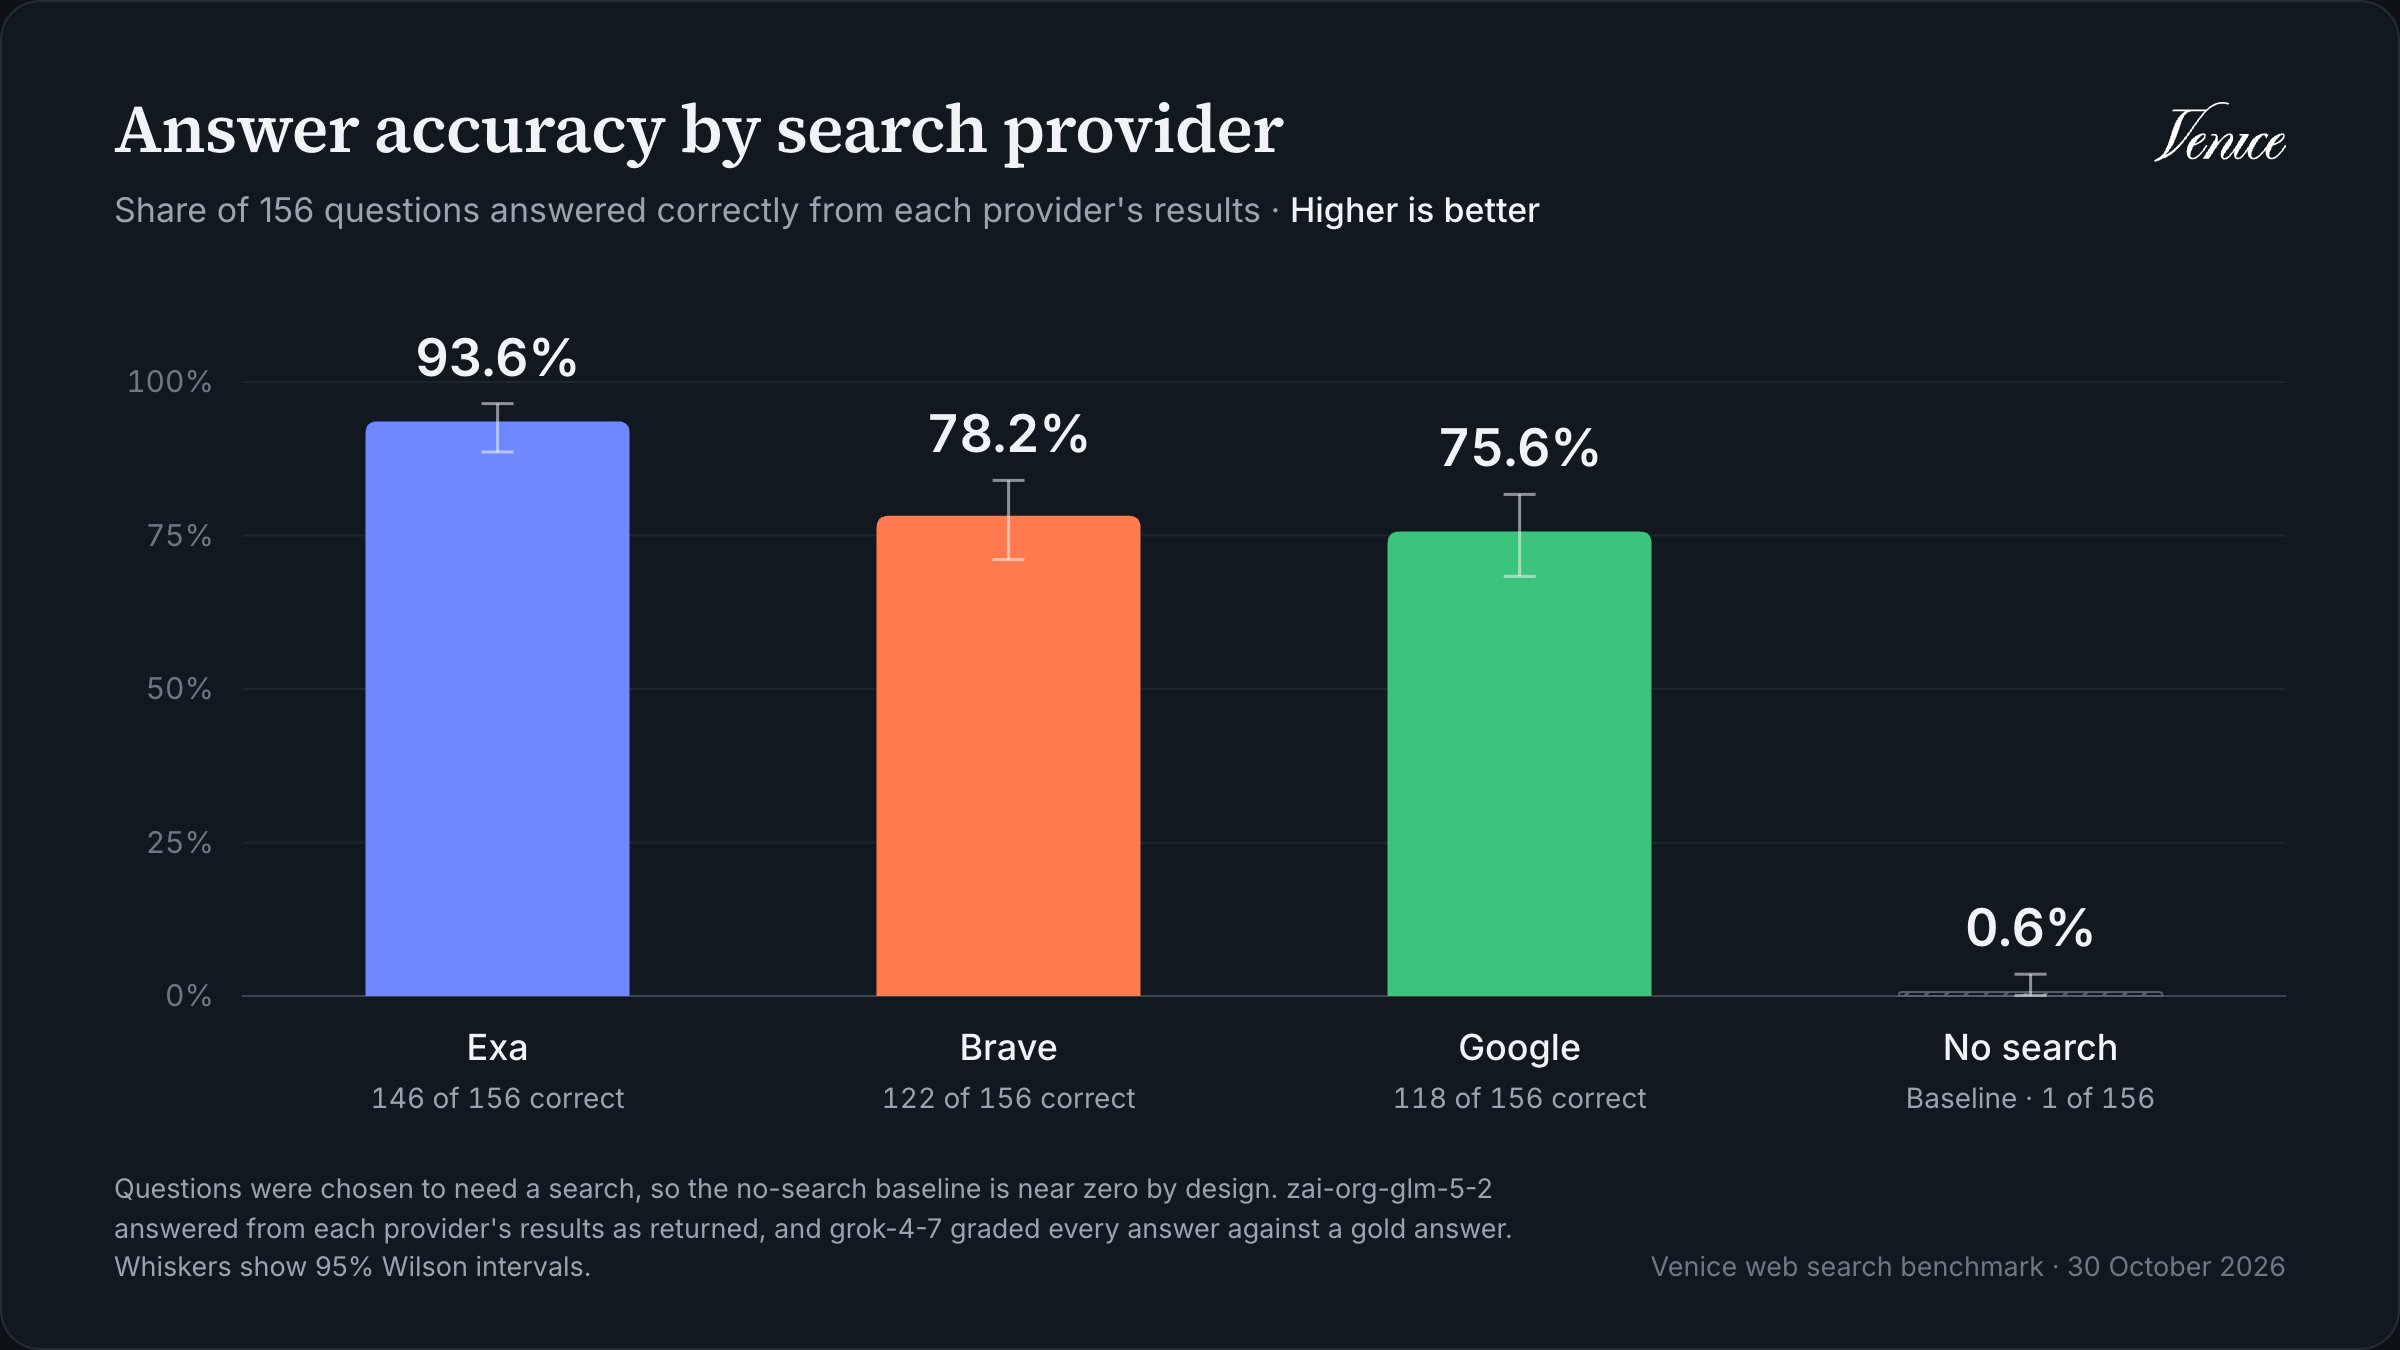
مع كل النتائج كما أُعيدت، أجاب Exa بشكل صحيح عن 93.6% من الأسئلة، متقدمًا بنحو 15 نقطة على Brave و18 نقطة على Google. هذه المرة الفارق واضح: أجاب Exa بشكل صحيح عن 28 سؤالًا أخطأ فيها Brave، مقابل 4 فقط في الاتجاه المعاكس، وعن 33 سؤالًا أخطأ فيها Google، مقابل 5 (McNemar p < 0.001 في الحالتين).
وللتحقق من أن هذا لم يكن مصادفة، أعدنا تشغيل الاختبار كاملًا في 11 نوفمبر بالإعدادات نفسها، ونتائجه موجودة في المستودع أيضًا. جاء Exa في المقدمة مجددًا، بنسبة 93.6% مقابل 81.4% لـ Brave و72.4% لـ Google، وتقدّم على Brave بـ 12.2 نقطة (24 سؤالًا مقابل 5، p = 0.001).
أما المقارنة بين Brave وGoogle فهي أقل حسمًا. في هذا التشغيل كانا متعادلين، 22 سؤالًا مقابل 18، وهو ضمن هامش الضوضاء بوضوح. وفي إعادة التشغيل تقدّم Brave، 29 سؤالًا مقابل 15 (9.0 نقاط، p = 0.049). لذا كان Brave متعادلًا مع Google أو متقدمًا عليه بحسب التشغيل.
أردنا أيضًا معرفة ما إذا كان تقدّم Exa يعود إلى صياغة الأسئلة، لأننا بحثنا عنها كما هي مكتوبة، بينما تعيد التطبيقات الحقيقية عادةً صياغتها كاستعلامات بحث أولًا. لذلك في إعادة تشغيل أخرى بتاريخ 10 نوفمبر، جعلنا النموذج يعيد صياغة كل سؤال مرة واحدة كاستعلام لمحرك بحث، وأرسلنا الاستعلام نفسه إلى الموفّرين الثلاثة، وقيّمنا الإجابات عن السؤال الأصلي. ظل Exa متقدمًا على Brave بـ 13.5 نقطة (24 سؤالًا مقابل 3)، ولم تتغير درجة أي موفّر تغيّرًا ملحوظًا، لذا فالصياغة لا تفسّر تقدّم Exa.
إجابات عدم البحث تستحق نظرة أيضًا. بدون بحث، أخبرنا النموذج بقراءة ترويسة
Retry-After بعد خطأ 429 بدلًا من x-ratelimit-reset-requests الخاصة بـ Venice، واخترع لاحقة -web-search لتفعيل البحث في الويب عبر اسم النموذج، وذكر موفّر بحث باسم venice غير موجود. إذا كان مستخدموك يسألون عن واجهات برمجة جديدة أو متخصصة، فلن تكفي معرفة النموذج الذاتية.
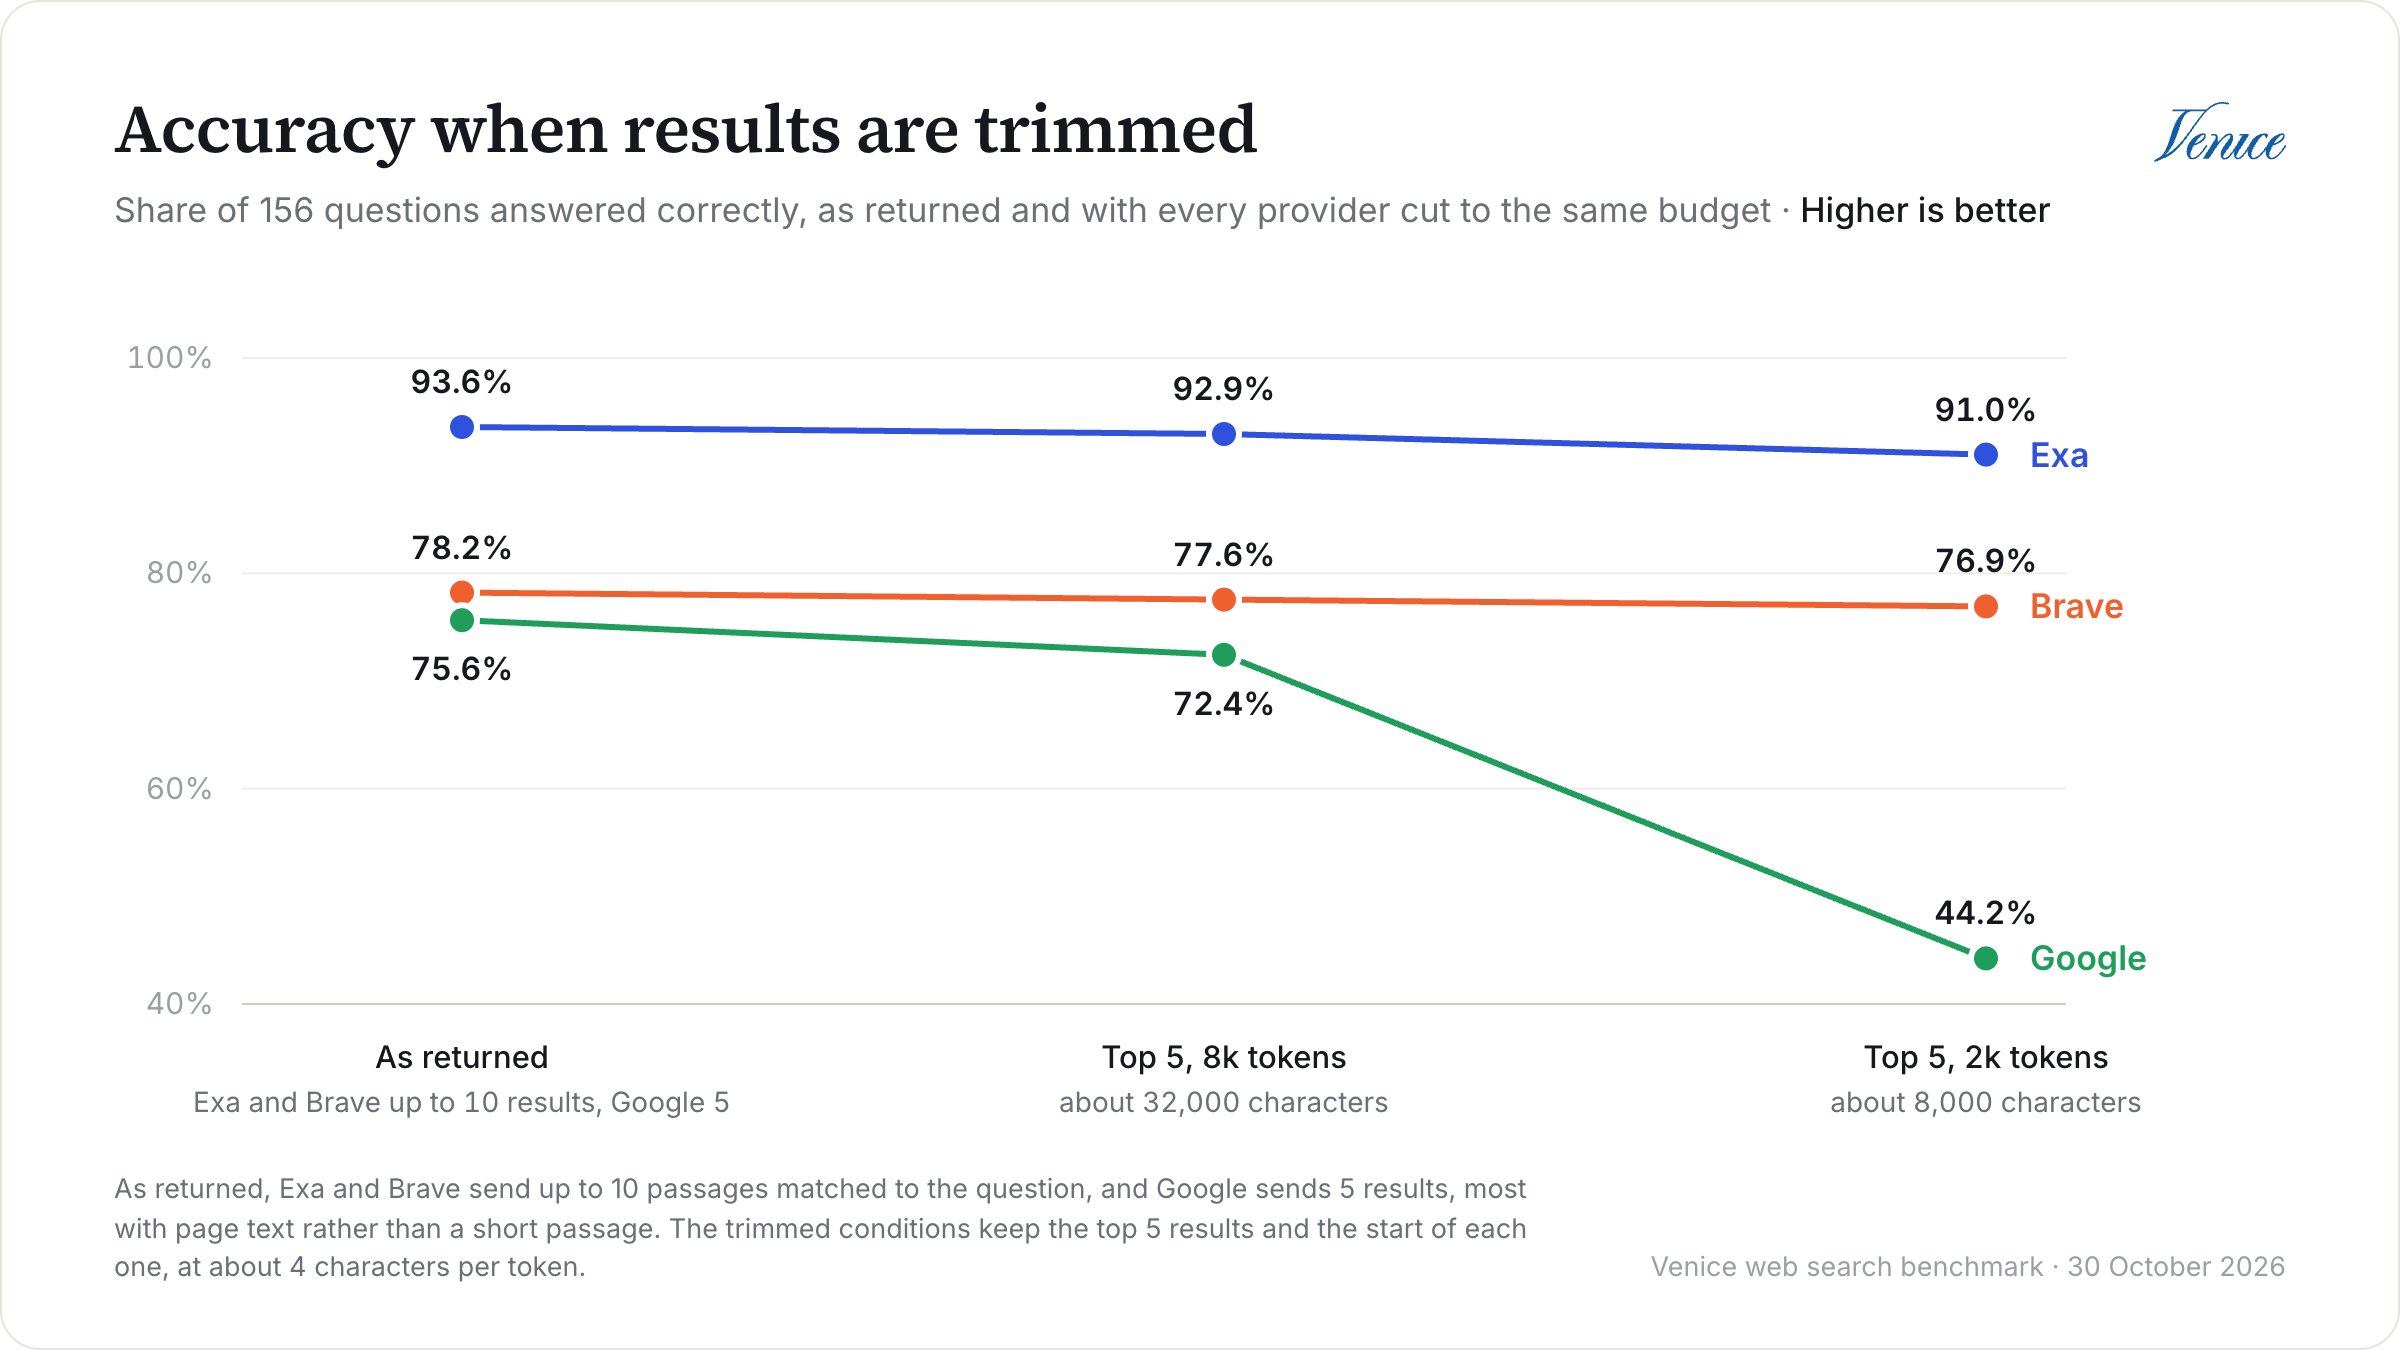
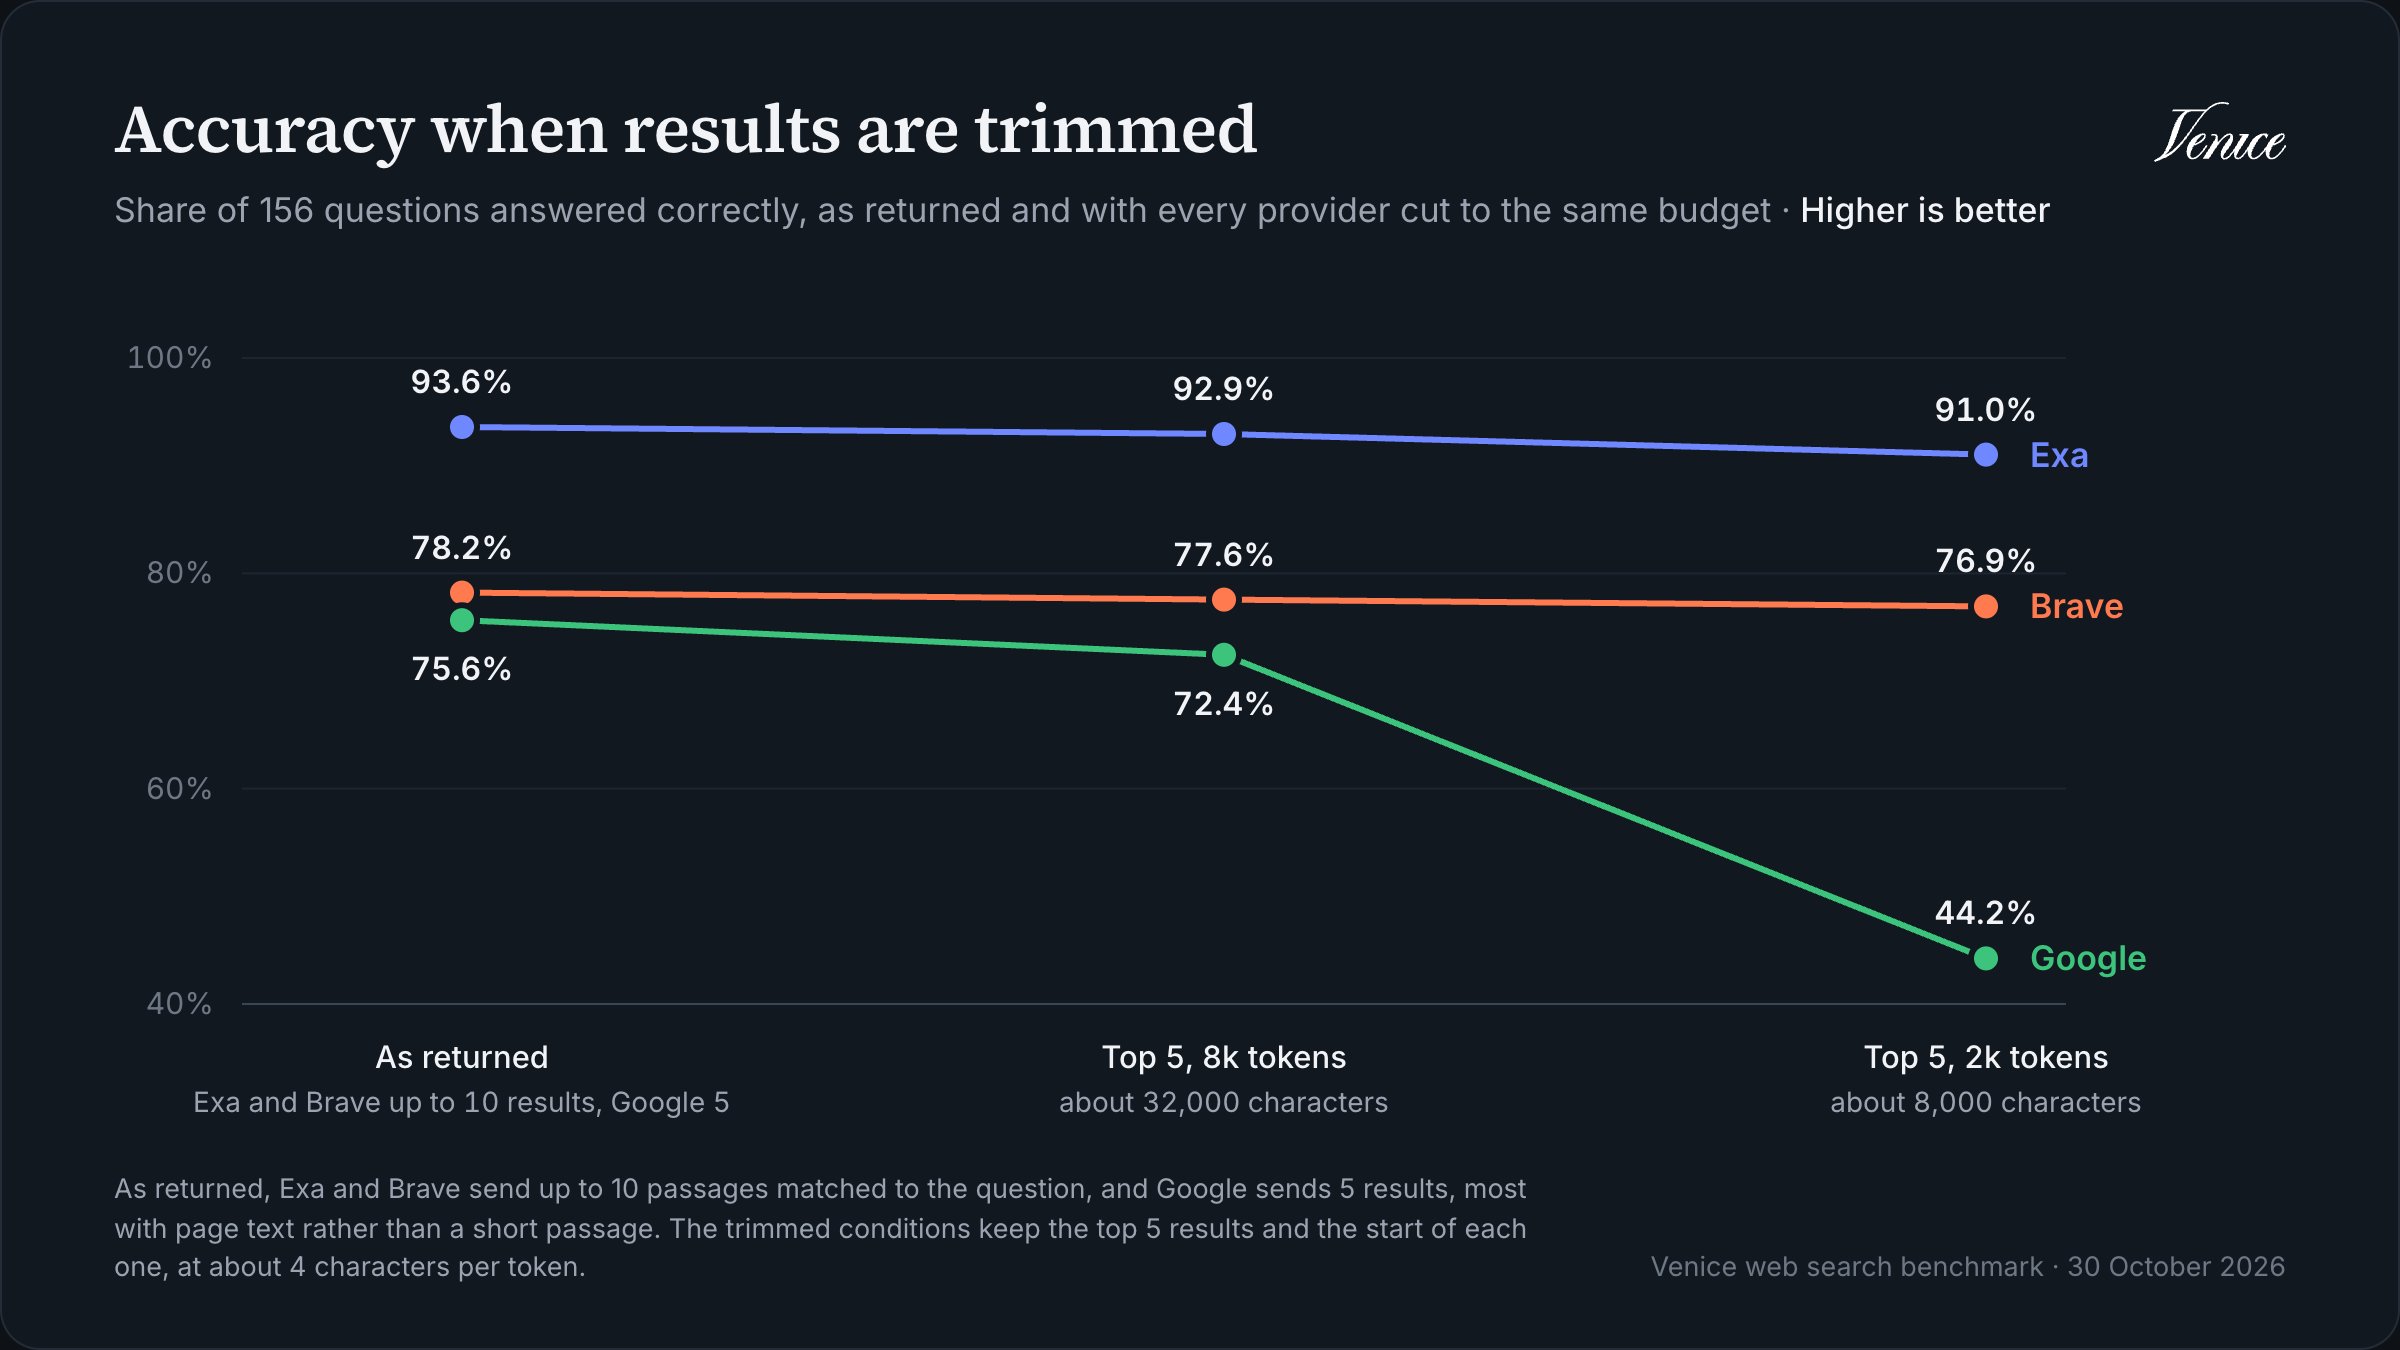
الحالات المحددة بميزانية هي حيث يتعثر Google. عند 2,000 رمز انخفضت دقته إلى 44.2%، ولم يجد النموذج إجابة لـ 30% من الأسئلة، مقارنةً بـ 10% عندما كانت لديه نتائج Google الكاملة. وبما أن نتائج Google تبدأ من أعلى الصفحة، فإن اقتطاعها لتتسع أبقى على قوائم التنقل والأشرطة وحذف الجزء الذي يجيب عن السؤال. أما نتائج Brave وExa فهي بالفعل مقاطع مطابقة للسؤال، لذا لم يُحدث اقتطاعها فرقًا يُذكر. وعند 8,000 رمز، استعاد Google معظم ما فقده، ليصل إلى 72.4%.
من أين يأتي تقدّم Exa
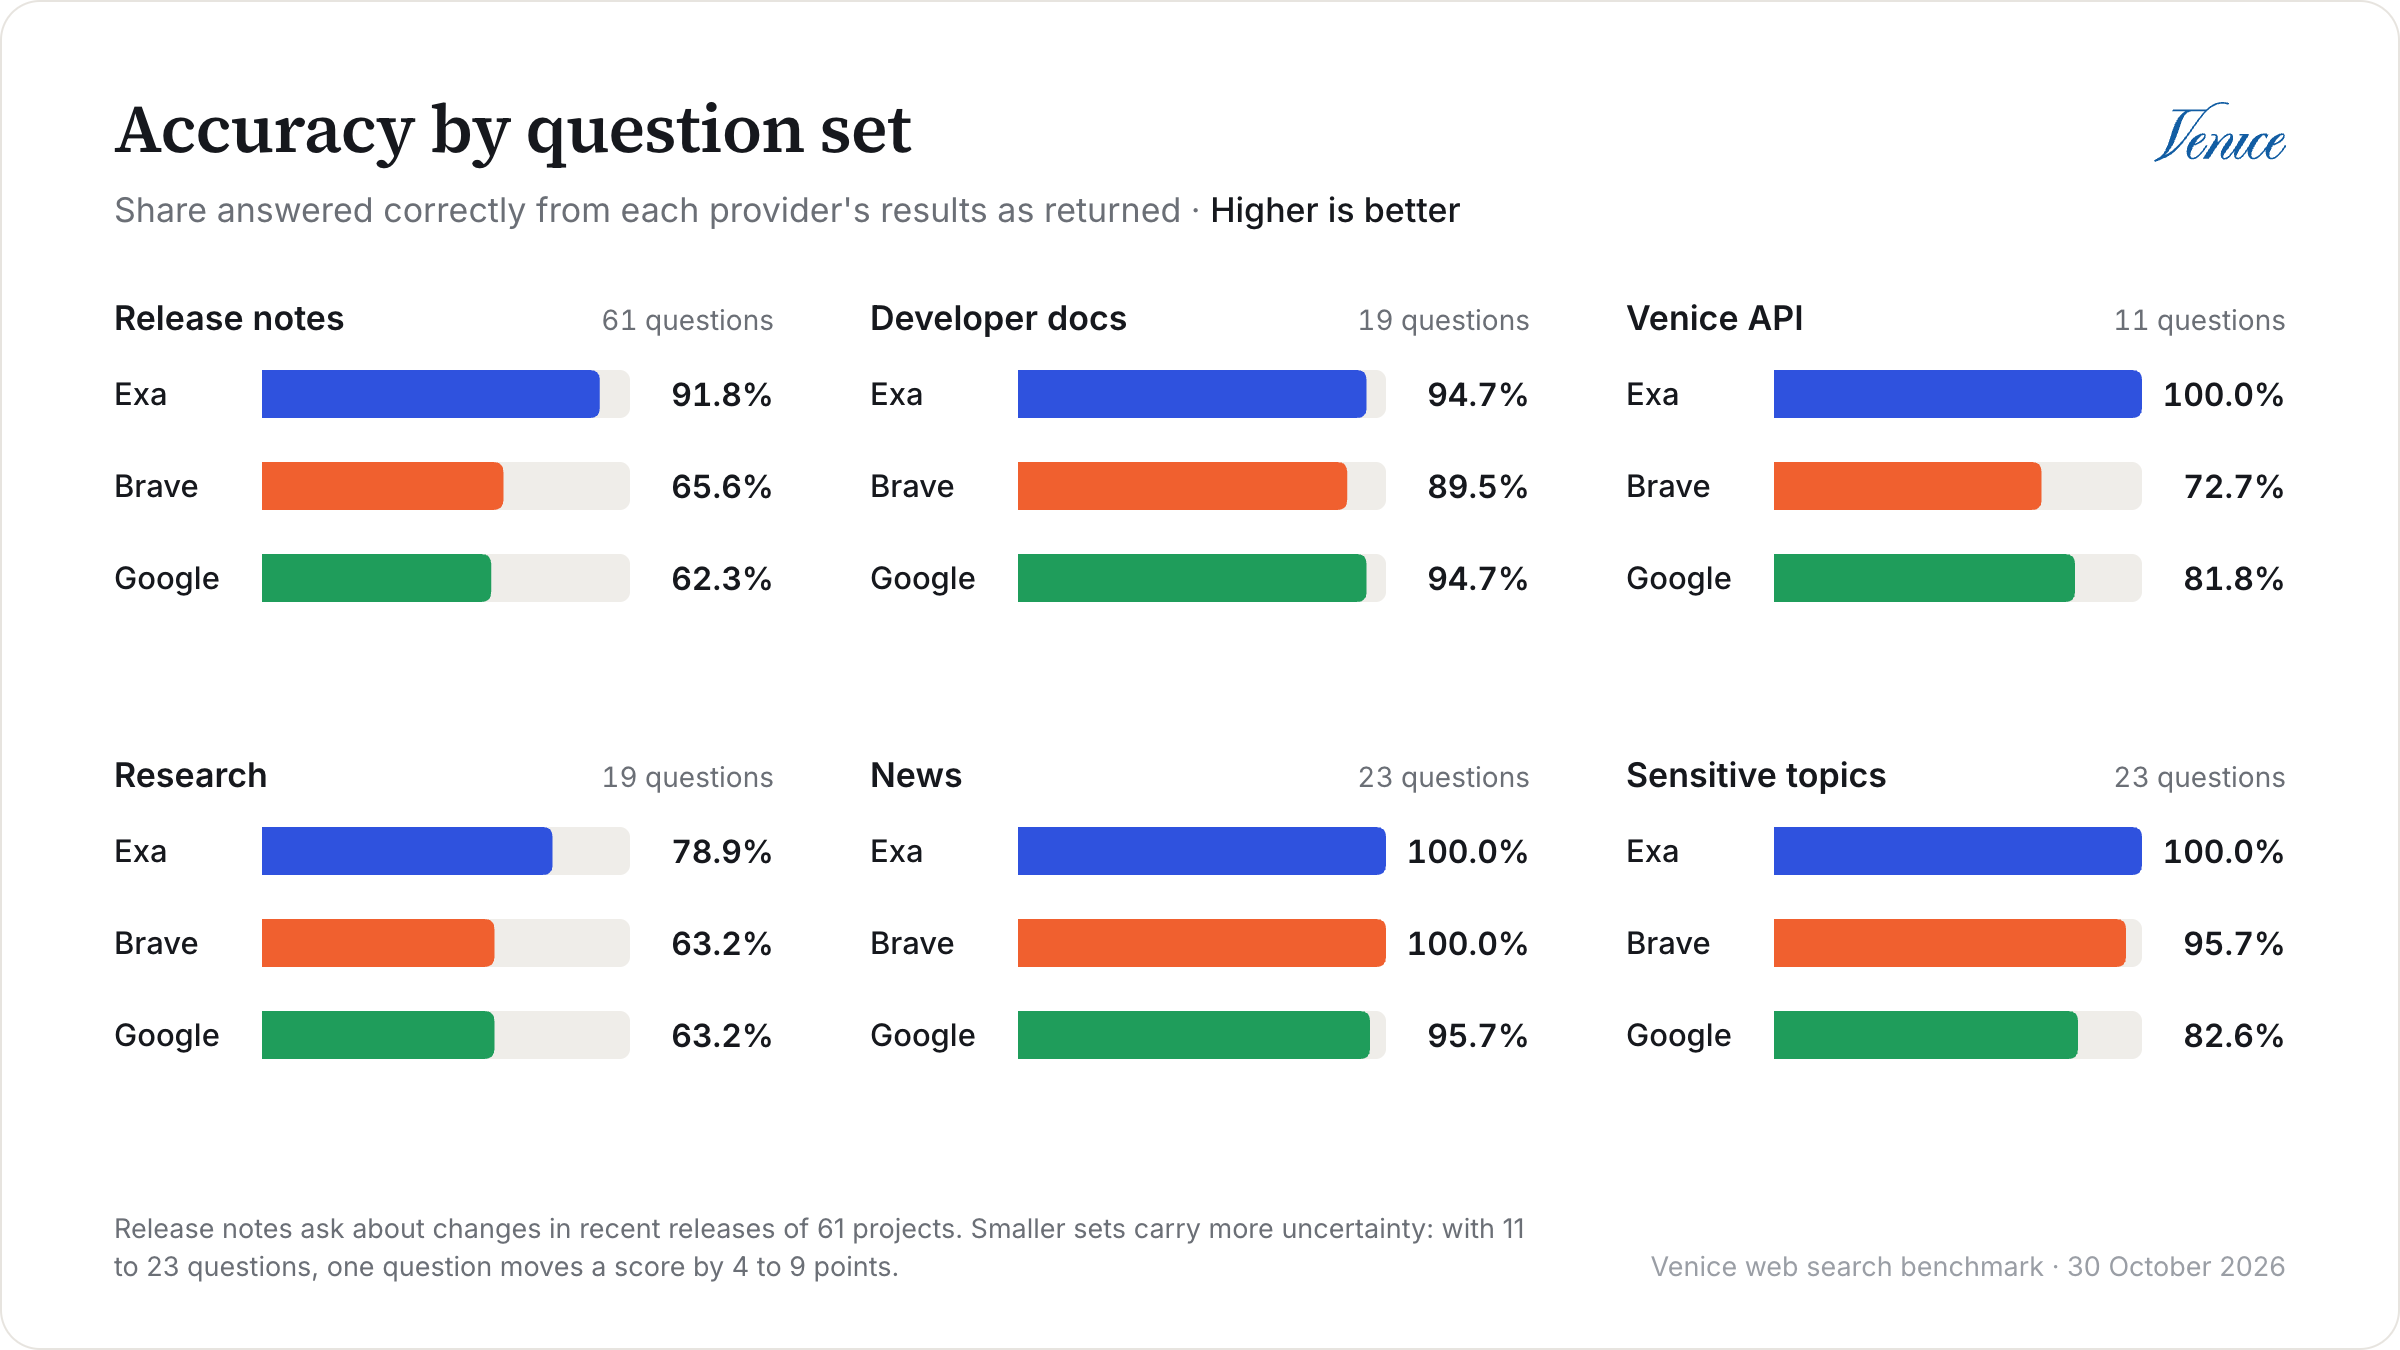
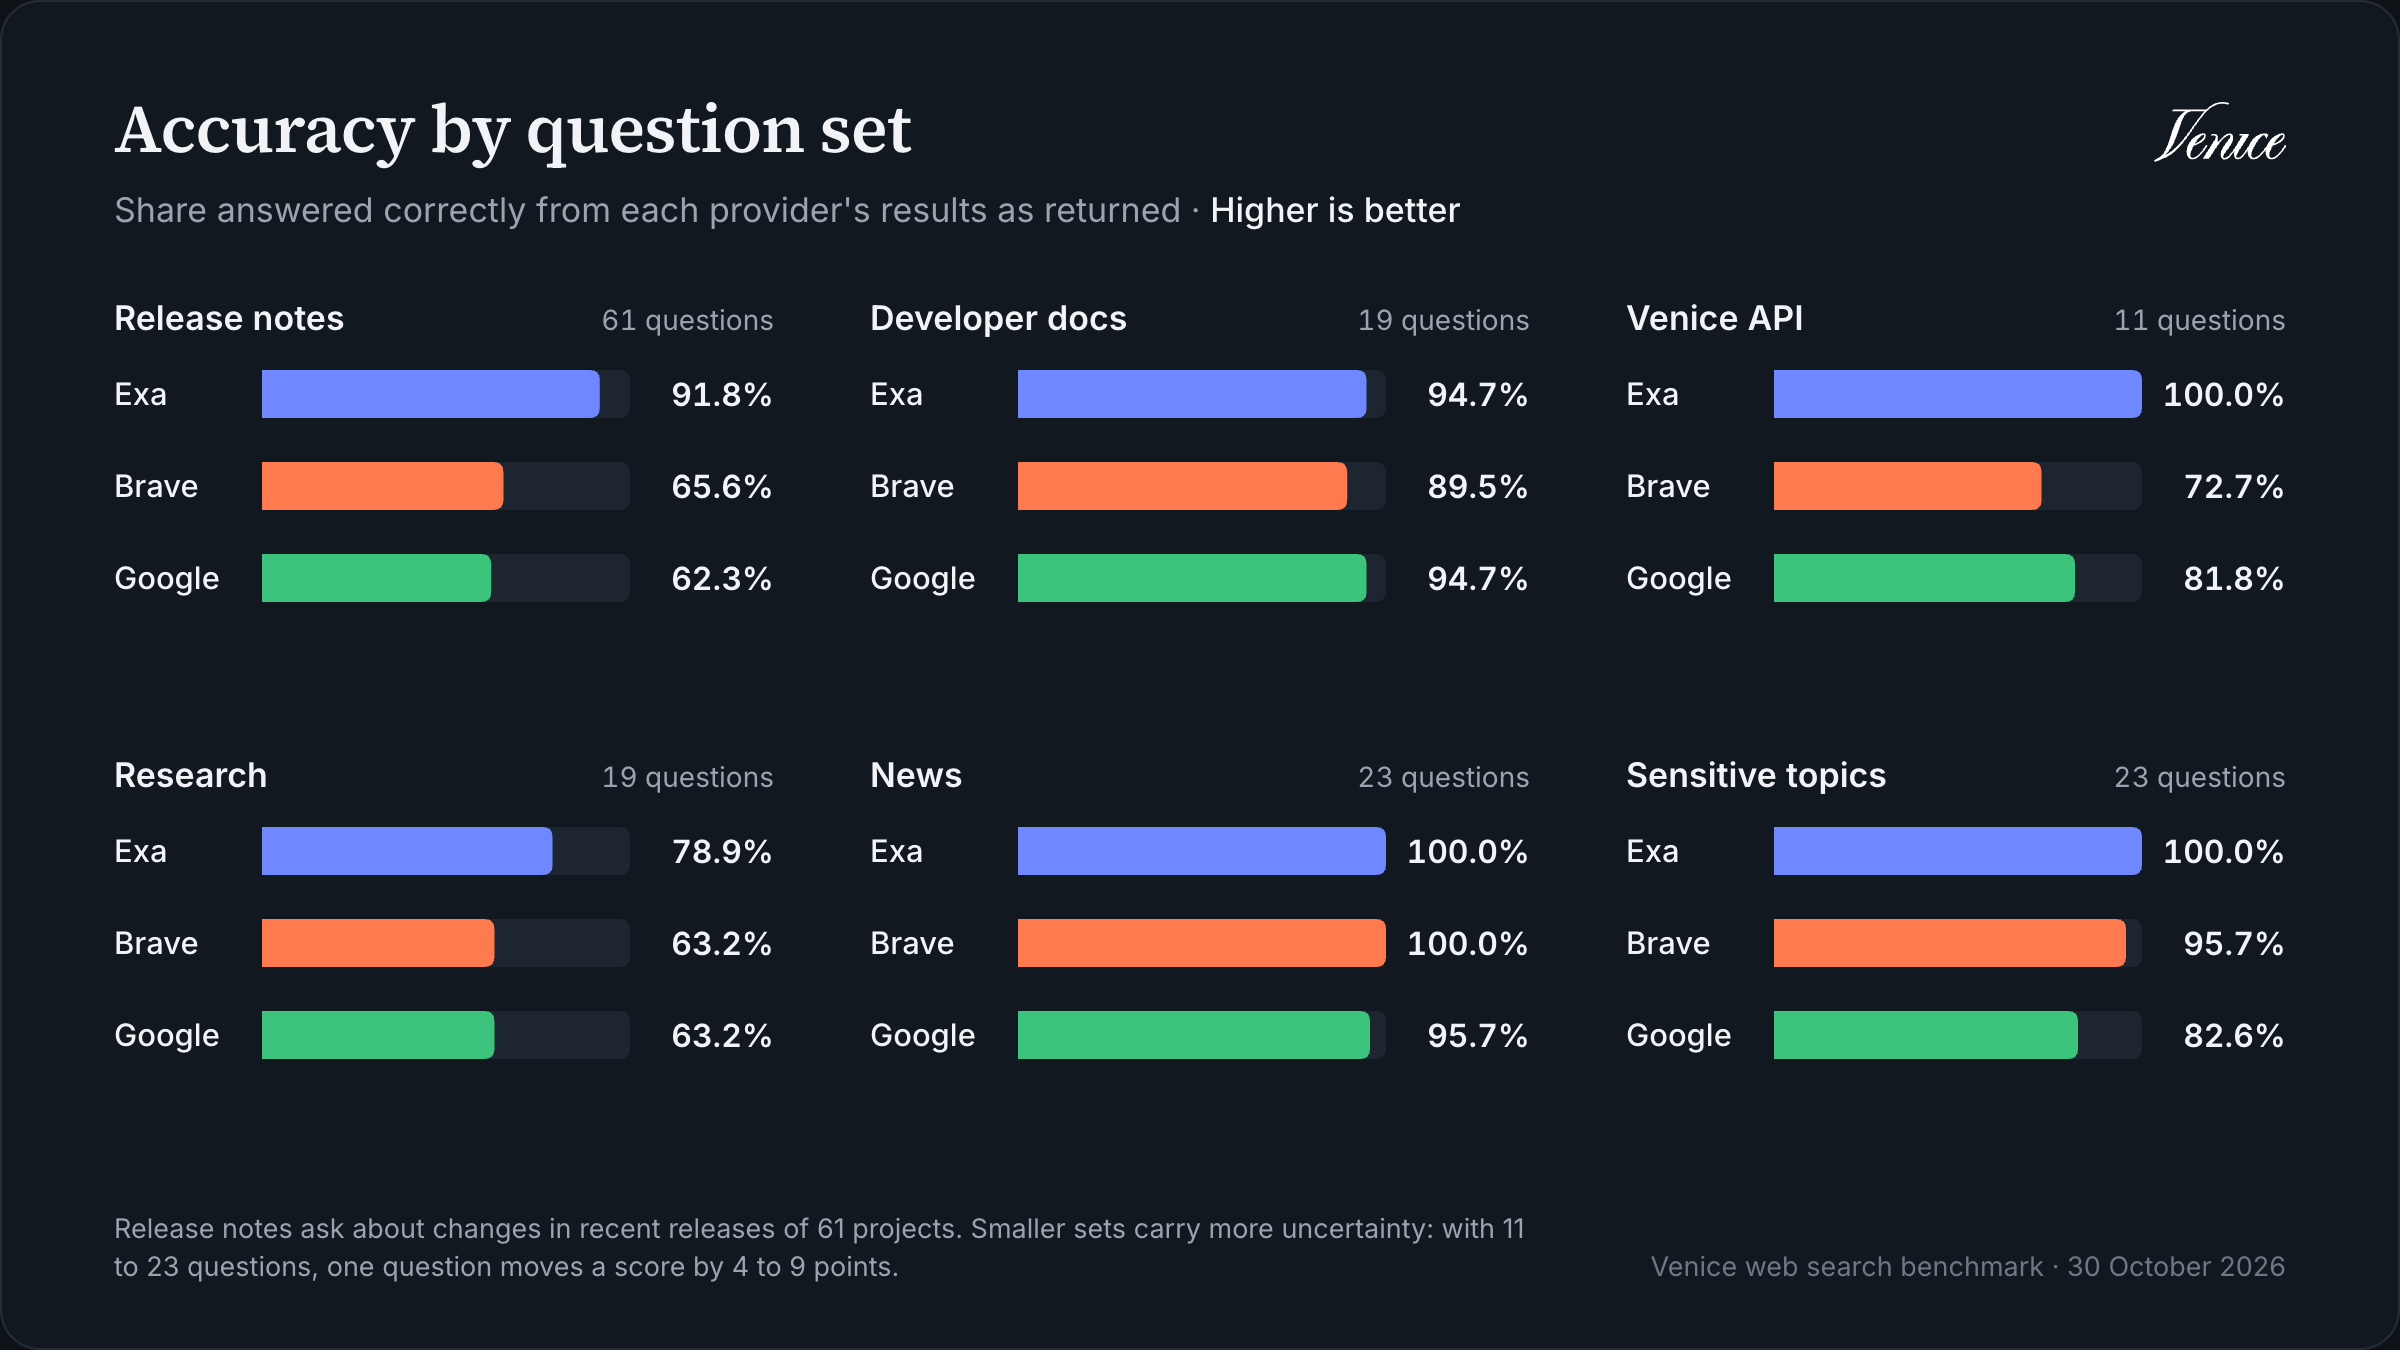
يأتي معظم الفارق من مكان واحد: ملاحظات الإصدار. أجاب Exa بشكل صحيح عن 56 من أسئلة الإصدارات الـ 61، مقارنةً بـ 40 لـ Brave و38 لـ Google. عادةً ما تكون إجابة هذه الأسئلة في سطر واحد من سجل التغييرات، وكانت نتائج Exa أكثر احتمالًا بكثير لتضمينه. وفي أسئلة الإصدارات التي تتضمن معرّفًا معروفًا، مثل flag أو متغير بيئة، احتوت نتائج Exa على 97% منها حرفيًا، مقابل 76% لـ Brave و68% لـ Google. وفي الأسئلة المرتبطة بإصدار محدد عبر جميع المجموعات البرمجية، أجاب Exa بشكل صحيح عن 95% وأجاب الآخران عن 55%.
كانت أسئلة البحث الأصعب على الجميع، لأنها تحتاج إلى حقيقتين من صفحتين مختلفتين، وحتى Exa لم يُجب بشكل صحيح إلا عن 15 من 19. أما في الأخبار ووثائق المطورين، فقد أجابت الموفّرات الثلاثة عن كل شيء تقريبًا. إذا كانت أسئلة مستخدميك تشبه هذه، فإن الموفّر الذي تختاره يصبح أقل أهمية بكثير.
ماذا عن الموضوعات الحساسة؟
تفلتر بعض خدمات البحث النتائج المتعلقة بالموضوعات الحساسة أو تدفنها، لذا أضفنا 23 سؤالًا للتحقق مما إذا كان أيٌّ من الموفّرين الثلاثة يفعل ذلك. تغطي موضوعات مثل قوانين المخدرات والإجهاض والعمل الجنسي والأسلحة النارية والمراقبة وقطع الإنترنت، ولكل منها إجابة واقعية من مصدر رسمي، مثل حكم قضائي أو إشعار حكومي. لم يُعِد أي موفّر نتيجة فارغة أو خطأ في أيٍّ منها، ولم يرفض النموذج الإجابة عن أي سؤال بسبب موضوعه. أجاب Exa بشكل صحيح عن الأسئلة الـ 23 كلها، وBrave عن 22، وGoogle عن 19. كانت الإخفاقات إخفاقات بحث عادية، حيث لم تتضمن النتائج المعلومة أو تضمنت تاريخًا مختلفًا، باستثناء إجابة واحدة من Google كانت متحفظة لكنها أعطت التاريخ الصحيح، وكان الحَكَم صارمًا أكثر من اللازم معها. لاحظ أن 23 سؤالًا لا يمكنها إلا أن تُظهر أننا لم نرَ أي فلترة، وليس أنه لا توجد فلترة في أي مكان.أعاد Exa النص الأكثر فائدة
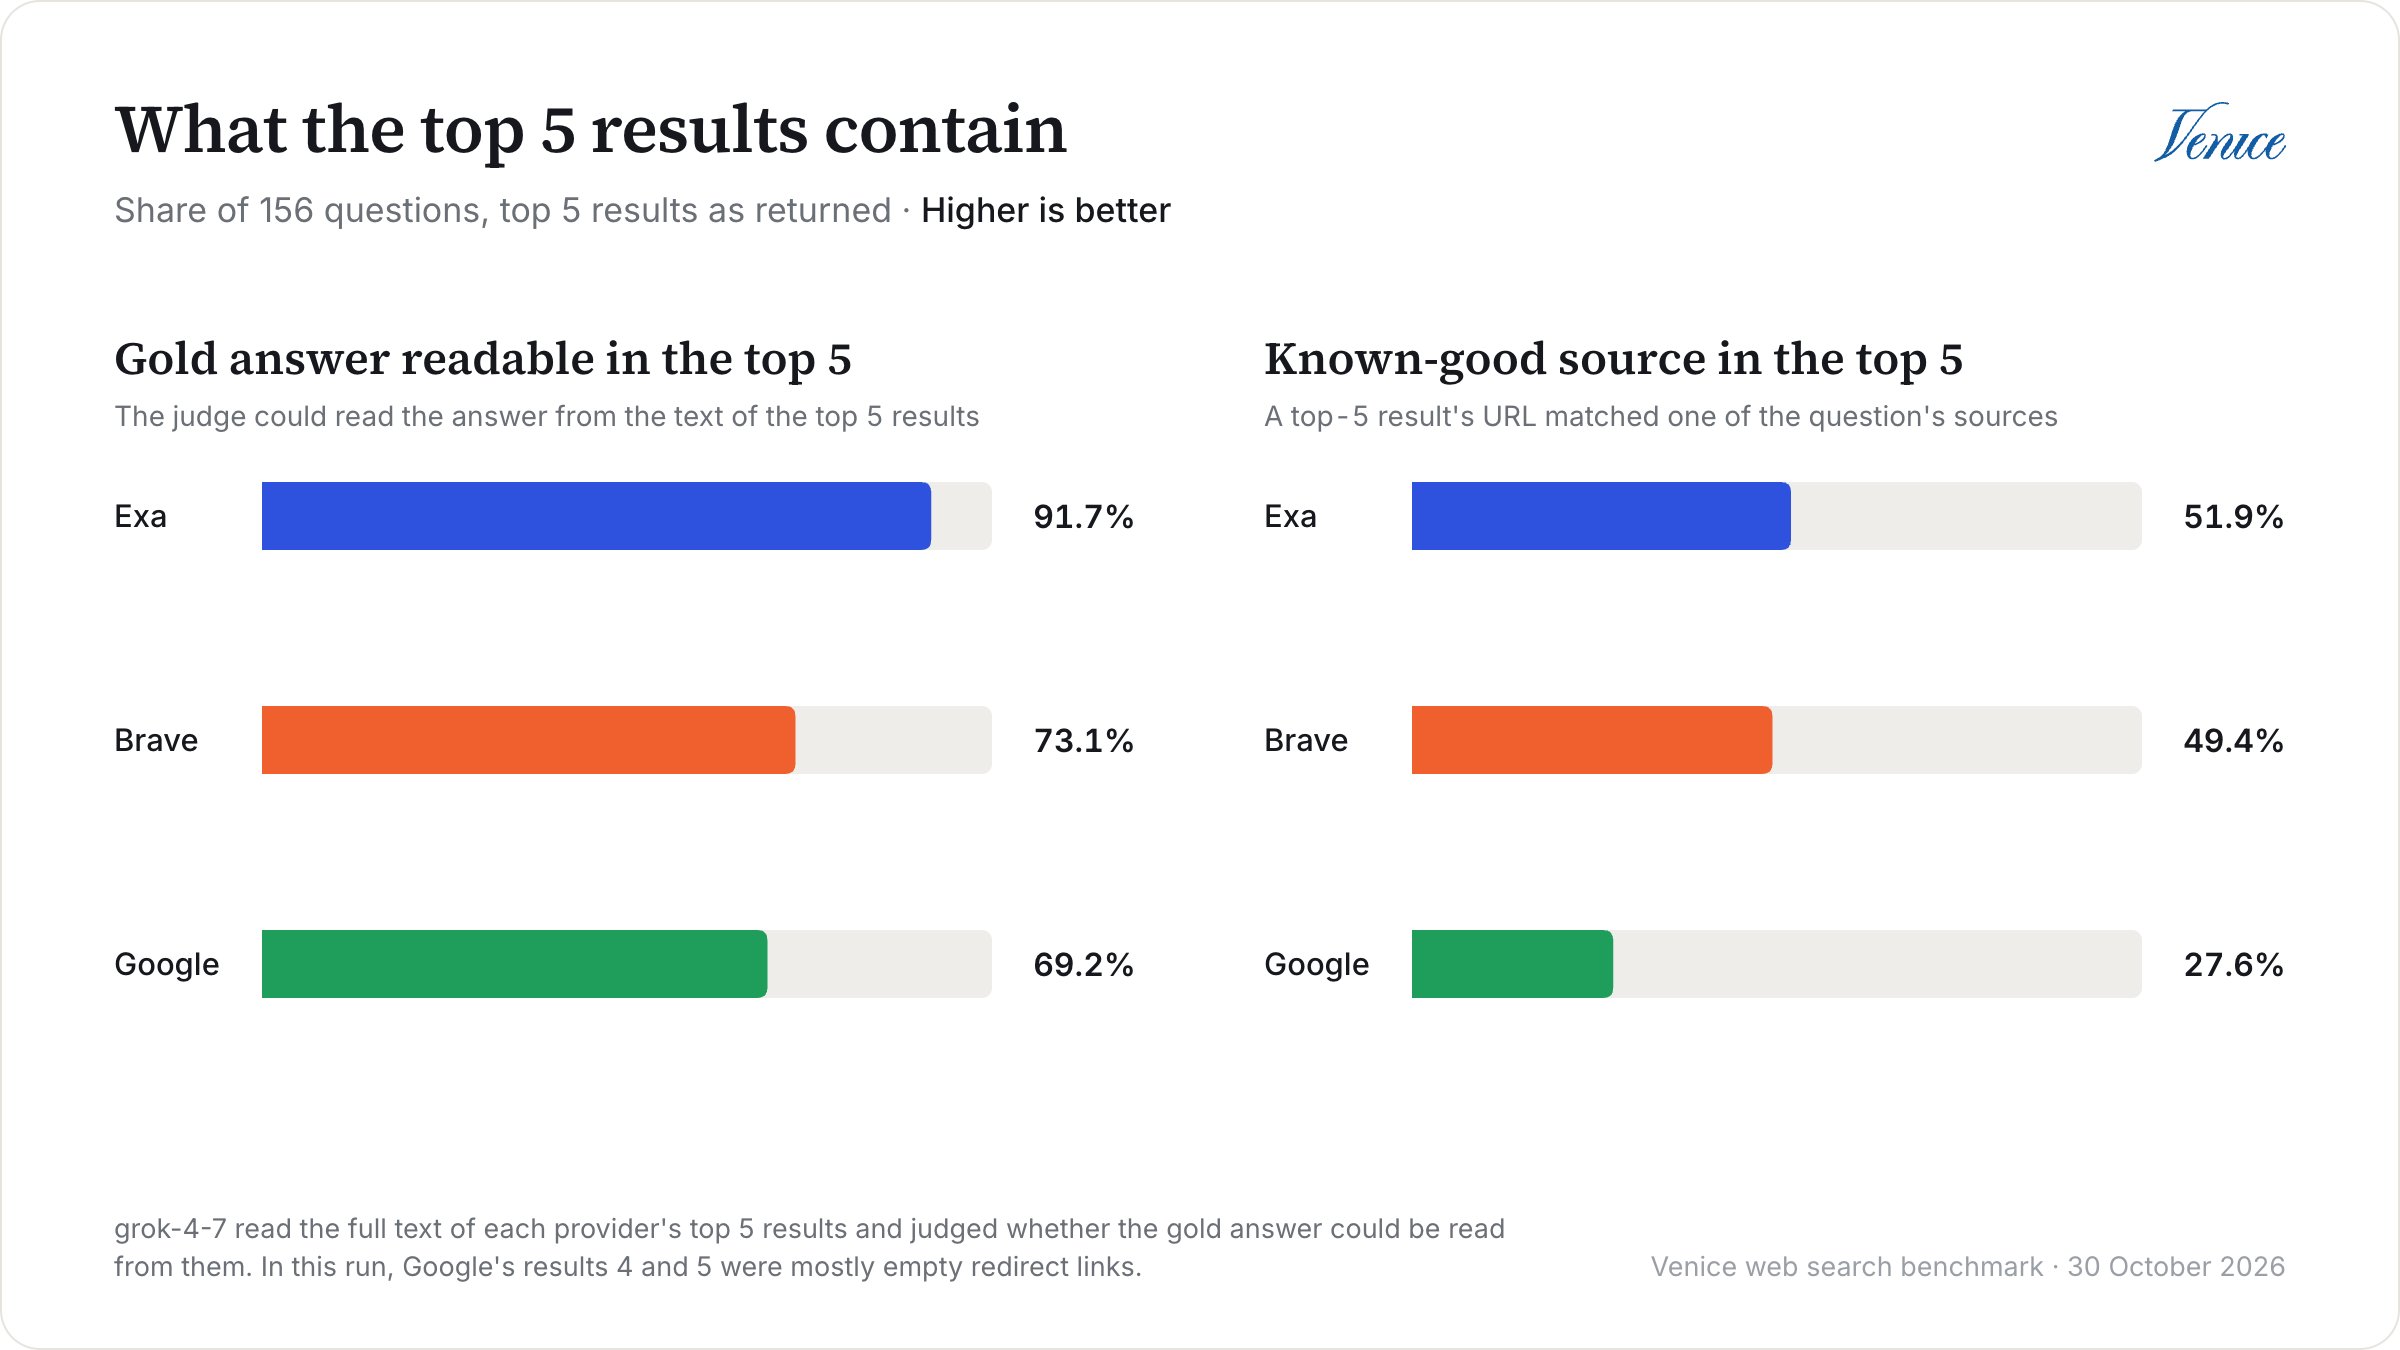
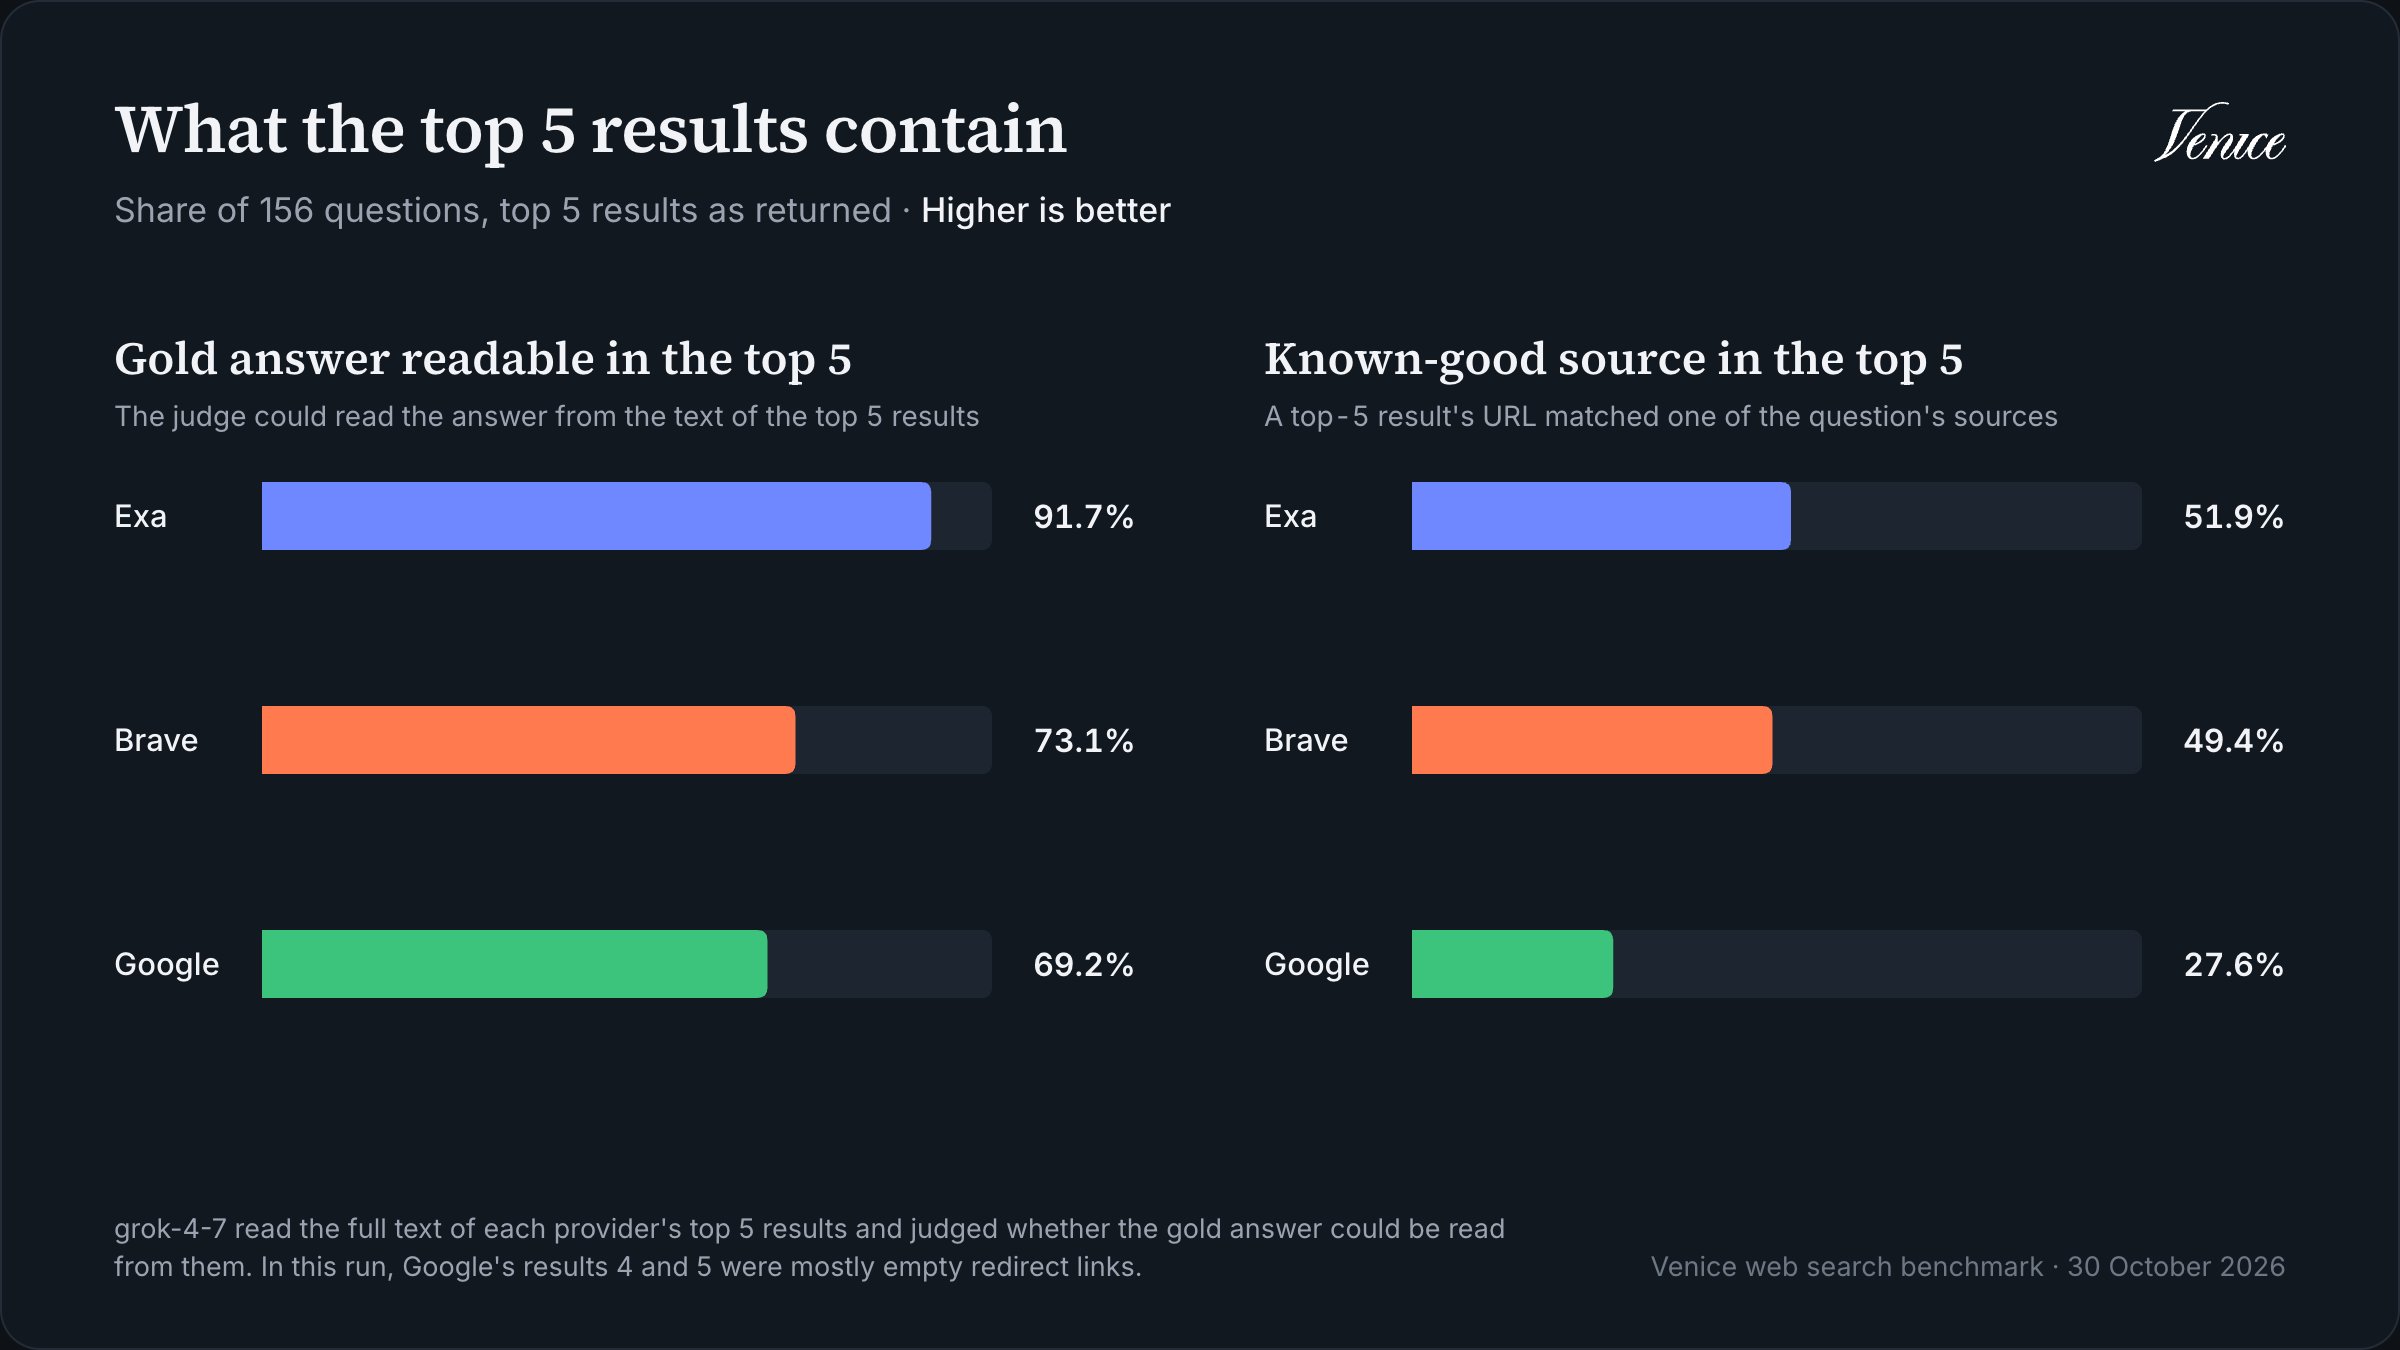
كانت نتائج Exa أيضًا الأكثر صلة. فقد كان مقياس nDCG@5 الخاص به أعلى بـ 0.15 من Brave (فاصل ثقة 95%: 0.11 إلى 0.19) وأعلى بـ 0.32 من Google (فاصل ثقة 95%: 0.28 إلى 0.36)، وتقدّم Brave على Google بـ 0.17.
لكن أرقام Google هنا تتضمن مشكلة جرى إصلاحها منذ ذلك الحين. في هذا التشغيل، كانت النتيجتان 4 و5 من Google روابط إعادة توجيه
google.com/goto?url=… في 144 من أصل 162 عملية بحث، ولم يكن في معظمها نص يُذكر، لذا كان نحو ثلث أفضل 5 نتائج من Google شبه فارغ. واختفت هذه الروابط في إعادة تشغيل 11 نوفمبر، حيث ارتفع nDCG@5 لـ Google من 0.43 إلى 0.47 وارتفع gold URL hit@5 من 27.6% إلى 31.4%. وظل Exa وBrave في المقدمة.
لكن هذه الدرجة تقيس النص الذي أعاده كل موفّر، وليس الصفحات التي اختارها فقط. عندما أعاد موفّران الصفحة نفسها، أعطى الحَكَم النسختين الدرجة نفسها في 71% من الحالات، وعندما اختلفت الدرجات، حصلت النسخة الأقصر على درجة أقل في 69% من الحالات. وللفصل بين الأمرين، تقيّم الأداة أيضًا كل صفحة بأفضل درجة نالتها أي نسخة منها لدى أي موفّر. وبهذا المقياس لكل صفحة، يتقلص تقدّم Exa على Brave إلى 0.09 (فاصل ثقة 95%: 0.05 إلى 0.13)، لكنه لا يختفي، واختار كلاهما صفحات أفضل من Google. لاحظ أن هذا لا يحقق التكافؤ إلا للصفحات التي أعادها أكثر من موفّر. أما كل ما عداها فلا يزال يُقيَّم بالنص الخاص بالموفّر نفسه.
تتقارب تكلفة Brave وExa، وGoogle هو الأعلى تكلفة
تكلّف عملية البحث نفسها المبلغ ذاته، $10 لكل 1,000 استعلام، لدى كل الموفّرين، لذا يأتي فرق التكلفة من الرموز التي ترسلها إلى النموذج بعد ذلك. جاء Brave وExa متقاربين، بينما جعل نص صفحات Google موجّهات الإجابة أكبر بنحو 3.6 مرة من موجّهات Brave، ما ضاعف تقريبًا التكلفة لكل استعلام. تستخدم هذه التكاليف أسعار قائمة
zai-org-glm-5-2 دون خصم التخزين المؤقت، لذا تعتمد الأرقام الدقيقة على نموذجك، لكن النسب بين الموفّرين تظل قائمة.
كان Exa الأسرع من حيث الوسيط هذه المرة، بـ 0.71 ثانية مقابل 0.97 لـ Brave، لكننا لن نرتّب هذين الاثنين: فقد كان Brave أسرع في تشغيلنا الأول، في اليوم السابق، عندما كان وسيط Exa 1.73 ثانية، ومرة أخرى في إعادة تشغيل 11 نوفمبر، بـ 0.99 ثانية مقابل 1.54. يُقاس زمن الاستجابة من جهة العميل عبر واجهة Venice، لذا يشمل زمن الشبكة والحمل الإضافي الخاص بـ Venice، ويتغير بين التشغيلات. ما ثبت عبر التشغيلات الثلاثة هو أن Brave وExa بقيا كلاهما دون ثانيتين في الوسيط، وأن Google كان الأبطأ في كل مرة، بـ 4.52 ثانية هنا و5.36 في إعادة التشغيل.
الأسئلة العامة
لا تملك الأسئلة العامة الست إجابة مرجعية، لذا قارن الحَكَم بدلًا من ذلك إجابات كل زوج من الموفّرين وجهًا لوجه، مرتين مع تبديل الترتيب. تفوقت إجابات Exa على إجابات Google في 4 منها، لكن مع 6 أسئلة فقط، لا نعتمد على ذلك. التفاصيل الكاملة موجودة في التقرير.إذًا أيّها يجب أن تستخدم؟
بناءً على هذا التشغيل، إليك كيف سنختار:- Exa، لمعظم أحمال العمل التي تمرّر النتائج مباشرة إلى نموذج، وخاصة مساعدي البرمجة ووكلاء البحث. حقق أفضل دقة أو دقة مساوية للأفضل في كل مجموعة أسئلة، وأكثر النتائج صلة، بتكلفة لكل استعلام تقارب تكلفة Brave.
- Brave، إذا كانت أسئلتك أقرب إلى أسئلة الأخبار والوثائق لدينا، حيث تعادل مع Exa، أو إذا كنت تحتاج أساسًا إلى إيجاد الصفحة الرسمية لشيء ما، وهو ما فعله بقدر Exa تقريبًا. إنه الافتراضي، وهو سريع ورخيص.
- Google، إذا كنت تريد نص الصفحة مباشرة في استجابة البحث، دون عملية استخراج منفصلة. معظم النتائج هي الصفحة الكاملة، لكن نحو ربعها مقتطف فقط، عندما يحظر الموقع الاستخراج. ستحتاج إلى تخصيص ميزانية للرموز وزمن الاستجابة الإضافيين، وإذا اقتطعت النتائج، فاحتفظ بالمقاطع التي تطابق السؤال بدلًا من بداية كل صفحة.
تحفظات
هناك بعض الأمور التي يجب مراعاتها قبل استخلاص الكثير من هذه الأرقام:- اختيرت الأسئلة بحيث تحتاج إلى بحث. استبعدنا كل سؤال يستطيع النموذج الإجابة عنه بمفرده، لذا فالمجموعة أصعب من حركة المرور اليومية.
- كتب وكلاء ذكاء اصطناعي الأسئلة. جرى التحقق من كل سؤال مقابل مصادره ومراجعته، لكن قد تظل إجابة مرجعية ما خاطئة. إذا لاحظت واحدة، فافتح issue في المستودع.
- تشكّل ملاحظات الإصدار جزءًا كبيرًا من المجموعة. فهي 61 من أصل 156 إجابة مرجعية، ومنها يأتي معظم تقدّم Exa، لذا قارن الجدول حسب مجموعة الأسئلة بحمل عملك.
- تأتي الدرجات من نموذج. راجعنا كل إجابة لم يحكم الحَكَم بصحتها عند استخدام النتائج كما أُعيدت، 82 إجابة في المجموع، بالإضافة إلى 30 حكم بصحتها. كنا سنغيّر 6 منها، كلها من خاطئة إلى صحيحة: 3 لـ Brave و2 لـ Google و1 لـ Exa. سيضع ذلك Brave عند 80.1% وGoogle عند 76.9% وExa عند 94.2%، فلا يتغير الترتيب، لكن الحَكَم يميل إلى الصرامة قليلًا.
- تتغير نتائج البحث. هذه الأرقام لقطة من أكتوبر 2026، والإجابات المرجعية الحساسة للوقت، خاصة أسئلة الأخبار، تتقادم. أبقت إعادة تشغيل 11 نوفمبر الترتيب نفسه لـ Exa، لكنها غيّرت المقارنة بين Brave وGoogle ودرجات الصلة لـ Google.
- بحث تشغيلنا الرئيسي عن كل سؤال كما هو مكتوب تمامًا. لم تغيّر إعادة صياغة الأسئلة كاستعلامات بحث الترتيب في إعادة تشغيل 10 نوفمبر، لكن إعادة الصياغة الخاصة بتطبيقك قد تغيّره.
- اختبرنا الموفّرين عبر واجهة Venice. يعيد كل منهم النتائج بتنسيقه الخاص، لذا تصف هذه الأرقام الخيارات الثلاثة كما تعيدها الواجهة، وليس محركات البحث عمومًا.
- تعتمد درجات الصلة على مقدار النص المُعاد. قد يحصل مقتطف قصير على درجة أقل من نسخة أطول من الصفحة نفسها. تصحّح الدرجة لكل صفحة ذلك للصفحات التي أعادها أكثر من موفّر، لكن ليس للبقية.
- تقتطع الحالات المحددة بميزانية من النهاية. خط الأنابيب الذي يختار المقاطع حسب الصلة سيتعامل مع نتائج Google بشكل أفضل مما فعلنا.
- كتب نموذج واحد كل الإجابات، وفحص النموذج نفسه الأسئلة. قد يستفيد نموذج مختلف من النتائج الطويلة بشكل أفضل (أو أسوأ)، وقد يعرف بعض الإجابات مسبقًا.
تشغيله بنفسك
الأداة مشروع صغير بـ Bun وTypeScript بلا تبعيات تشغيل. بعد استنساخ المستودع، ثبّت تبعيات التطوير وشغّل الاختبارات:.env في المستودع:
--budget، الذي تكون قيمته الافتراضية $5. كلّف تشغيلنا الكامل $36.10: $4.86 لـ 486 عملية بحث، بالإضافة إلى رموز الإجابة والحَكَم. لا يحتسب التقدير خصومات التخزين المؤقت، لذا يأتي أعلى، عند نحو $50. يكتب كل تشغيل ملف report.md يحتوي على الجداول الكاملة التي يستند إليها هذا المقال، وملف results.csv بصف واحد لكل سؤال وموفّر وحالة، وملف summary.json، وملفين يحتويان على كل إجابة وقائمة نتائج كل موفّر.
إذا كنت تريد فقط تصفّح أرقامنا، فلا حاجة لتشغيل أي شيء، لأن مجلد results في المستودع يحتوي على كل ذلك من هذا التشغيل.
لكن القيمة الحقيقية تكمن في تشغيله على أسئلتك. اكتبها بصيغة JSON Lines، بكائن واحد لكل سؤال:
goldAnswer تحصل على درجات الاسترجاع، لذا يمكنك البدء بقائمة استعلامات حقيقية من سجلاتك وإضافة الإجابات المرجعية لاحقًا. لكن قبل أن تثق بأرقام الدقة، تحقق من عدد أسئلتك التي يجيب عنها النموذج بشكل صحيح باستخدام --arms none، لأن الأسئلة التي يعرف إجابتها مسبقًا لن تميّز بين موفّريك.