

brave, google o exa. Todos cuestan lo mismo, $0.01 por búsqueda, así que la pregunta obvia es cuál deberías usar.
En este artículo lo vamos a averiguar. Construimos un benchmark que envía las mismas 162 preguntas a cada proveedor, hace que el mismo modelo responda a partir de los resultados de cada proveedor y califica tanto los resultados como las respuestas. Veremos cómo elegimos las preguntas, qué encontramos y cómo puedes ejecutarlo tú mismo.
¿Te interesa el código completo? Consulta el repositorio de GitHub. También incluye cada respuesta y la lista de resultados de cada proveedor de esta ejecución, así que puedes revisar nuestro trabajo sin pagar por una ejecución.
Qué medimos
Hay dos cosas distintas en las que un proveedor de búsqueda puede ser bueno, y no siempre coinciden:- Recuperación: ¿los resultados son relevantes y contienen realmente la respuesta?
- Respuestas: cuando le das esos resultados a un modelo, ¿responde correctamente?
POST /augment/search una vez por proveedor, con limit fijado en 10. Después, zai-org-glm-5-2 responde a partir de los resultados de cada proveedor, y grok-4-7 lo califica todo con temperatura 0. El modelo también responde sin ninguna búsqueda, como referencia.
Ten en cuenta que los proveedores no devuelven la misma cantidad de texto, ni siquiera el mismo tipo. En nuestra ejecución, Exa devolvió 10 resultados por búsqueda y Brave entre 7 y 10, formados por pasajes ajustados a la pregunta, de unos 1.500 a 1.700 caracteres cada uno. Google devolvió 5 resultados, que es lo que la API de Venice devuelve para google sin importar el valor de limit. La mayoría eran el texto completo de la página, empezando por arriba: navegación, banners de cookies y todo lo demás. Aunque no todos: cuando un sitio bloquea la extracción, como Reddit, Facebook, Stack Overflow o YouTube, el resultado es solo el fragmento de búsqueda. En una repetición del 11 de noviembre, una cuarta parte de los 5 primeros resultados de Google tenía menos de 300 caracteres de texto. Eso suponía unos 9.700 caracteres por resultado, o 48.000 por búsqueda, frente a unos 14.000 para Brave y Exa. Más texto puede significar mejores respuestas, pero también significa más tokens de entrada en cada solicitud. Para ver cuánto importa el volumen, el modelo responde a partir de los resultados de cada proveedor de tres formas:
En las dos condiciones con presupuesto, todos los proveedores reciben el mismo número de resultados y el mismo espacio. Como el harness conserva el inicio de cada resultado, también prueban lo bien que aguantan los resultados de cada proveedor cuando se recortan, que es lo que hacen muchos pipelines reales.
Las preguntas
La primera versión de este benchmark tenía un problema: sin búsqueda, el modelo ya respondía el 72% de las preguntas que podíamos calificar, así que los tres proveedores parecían casi iguales. Si el modelo ya conoce la respuesta, la búsqueda no puede marcar mucha diferencia, y tampoco puede decirte qué proveedor es mejor. Así que para esta ejecución reunimos 156 preguntas con respuestas de referencia, cuya respuesta tiene que venir de una búsqueda:
Las preguntas de programación tienen varios estilos, desde mensajes de error pegados hasta preguntas ligadas a una versión como “Which ripgrep version started respecting the GIT_CONFIG_GLOBAL environment variable?”. Es a propósito: un buscador que funciona muy bien con lenguaje natural puede fallar con una cadena de error. También hay 6 preguntas generales sin respuesta de referencia, como preguntas conversacionales largas, a las que volveremos más adelante.
Cada pregunta con respuesta de referencia pasó los mismos controles antes de entrar en el conjunto. Redactamos cada una con agentes de IA a partir de una fuente primaria, como una nota de versión o un comunicado de prensa oficial, y un script descargó cada fuente para confirmar que la cita detrás de la respuesta de referencia estaba realmente en la página. Después, el modelo respondió cada pregunta dos veces sin búsqueda, y descartamos cualquier pregunta que acertara alguna de las dos veces.
Para las preguntas de noticias y temas sensibles, también le dimos al modelo las citas de la fuente como resultados de búsqueda, y solo conservamos una pregunta si respondía correctamente las dos veces. Esto detecta preguntas ambiguas y comprueba que el modelo responde una pregunta sensible cuando tiene la fuente. Por último, otro agente revisó cada pregunta y respuesta de referencia contra las fuentes, lo que llevó a 47 ediciones y 3 descartes más, y cada pregunta editada volvió a pasar por el filtro sin búsqueda.
Ten en cuenta que esto hace que la referencia sin búsqueda sea casi cero por diseño, así que no te dice con qué frecuencia ayuda la búsqueda en general. Lo que sí te dice es que todas las preguntas del conjunto necesitan una búsqueda, que es exactamente lo que queremos al comparar proveedores de búsqueda.
Las métricas
La precisión viene con un intervalo de confianza del 95%, y las diferencias entre proveedores provienen de comparaciones emparejadas sobre las mismas preguntas: un intervalo bootstrap y una prueba exacta de McNemar. Con 156 respuestas de referencia, cada pregunta vale unos 0,6 puntos porcentuales, y los intervalos de precisión llegan a unos ±7 puntos, así que conviene revisar las comparaciones emparejadas antes de sacar conclusiones de una diferencia pequeña.
Resultados
Exa respondió correctamente más preguntas
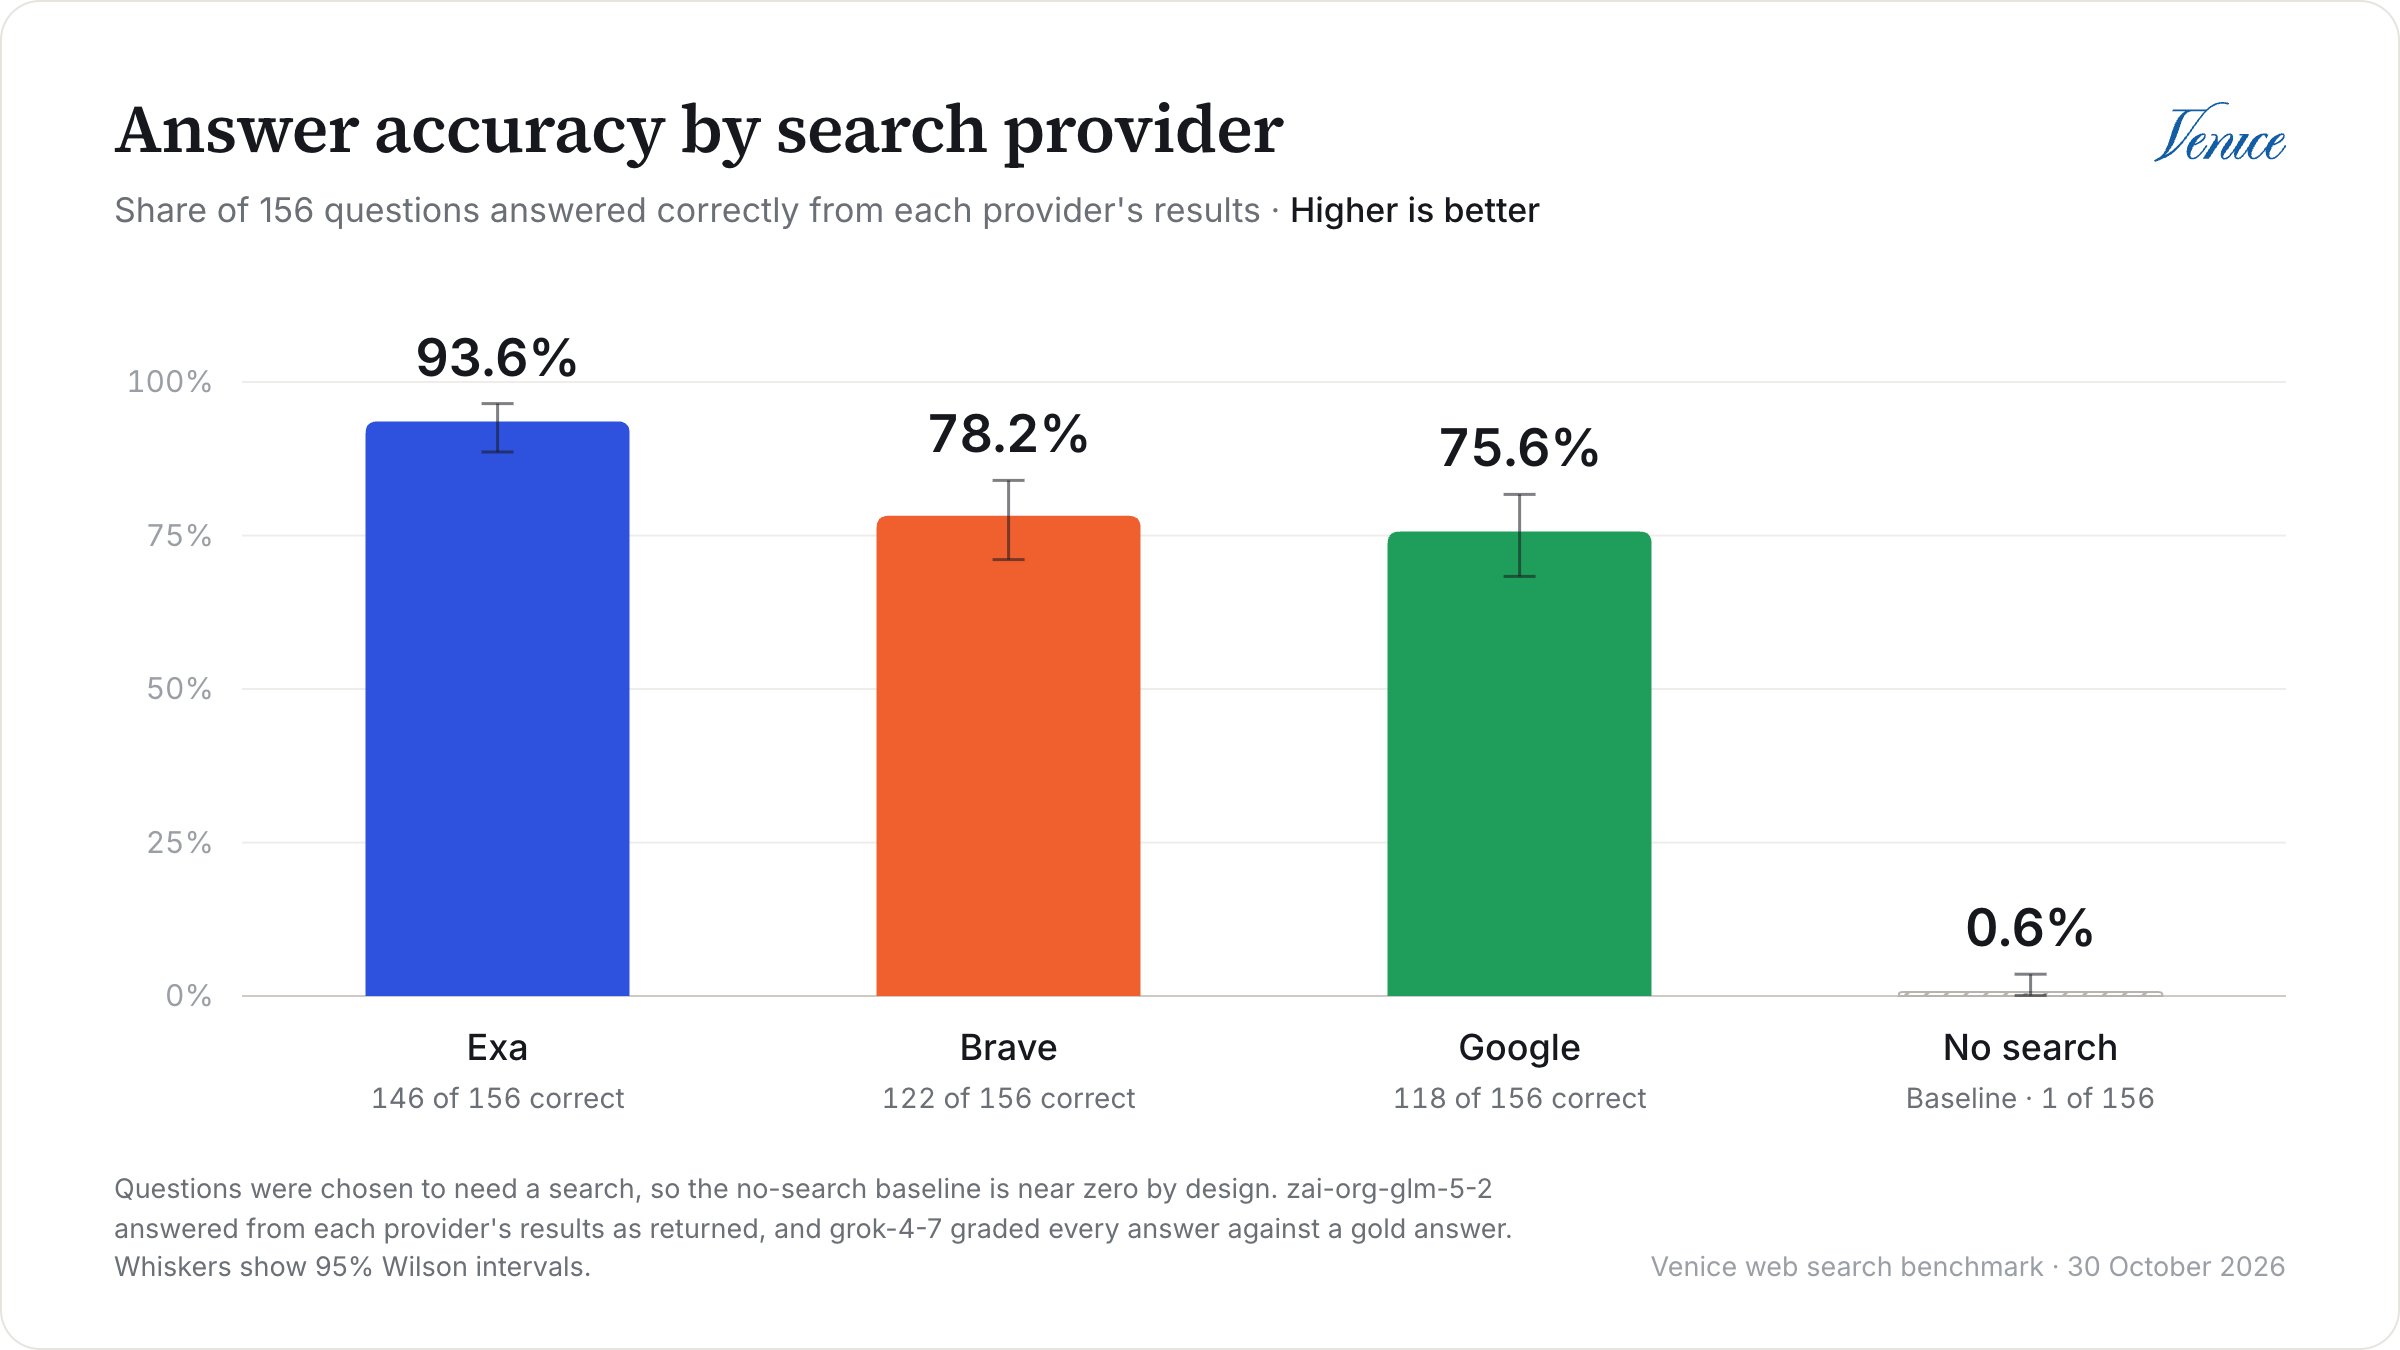
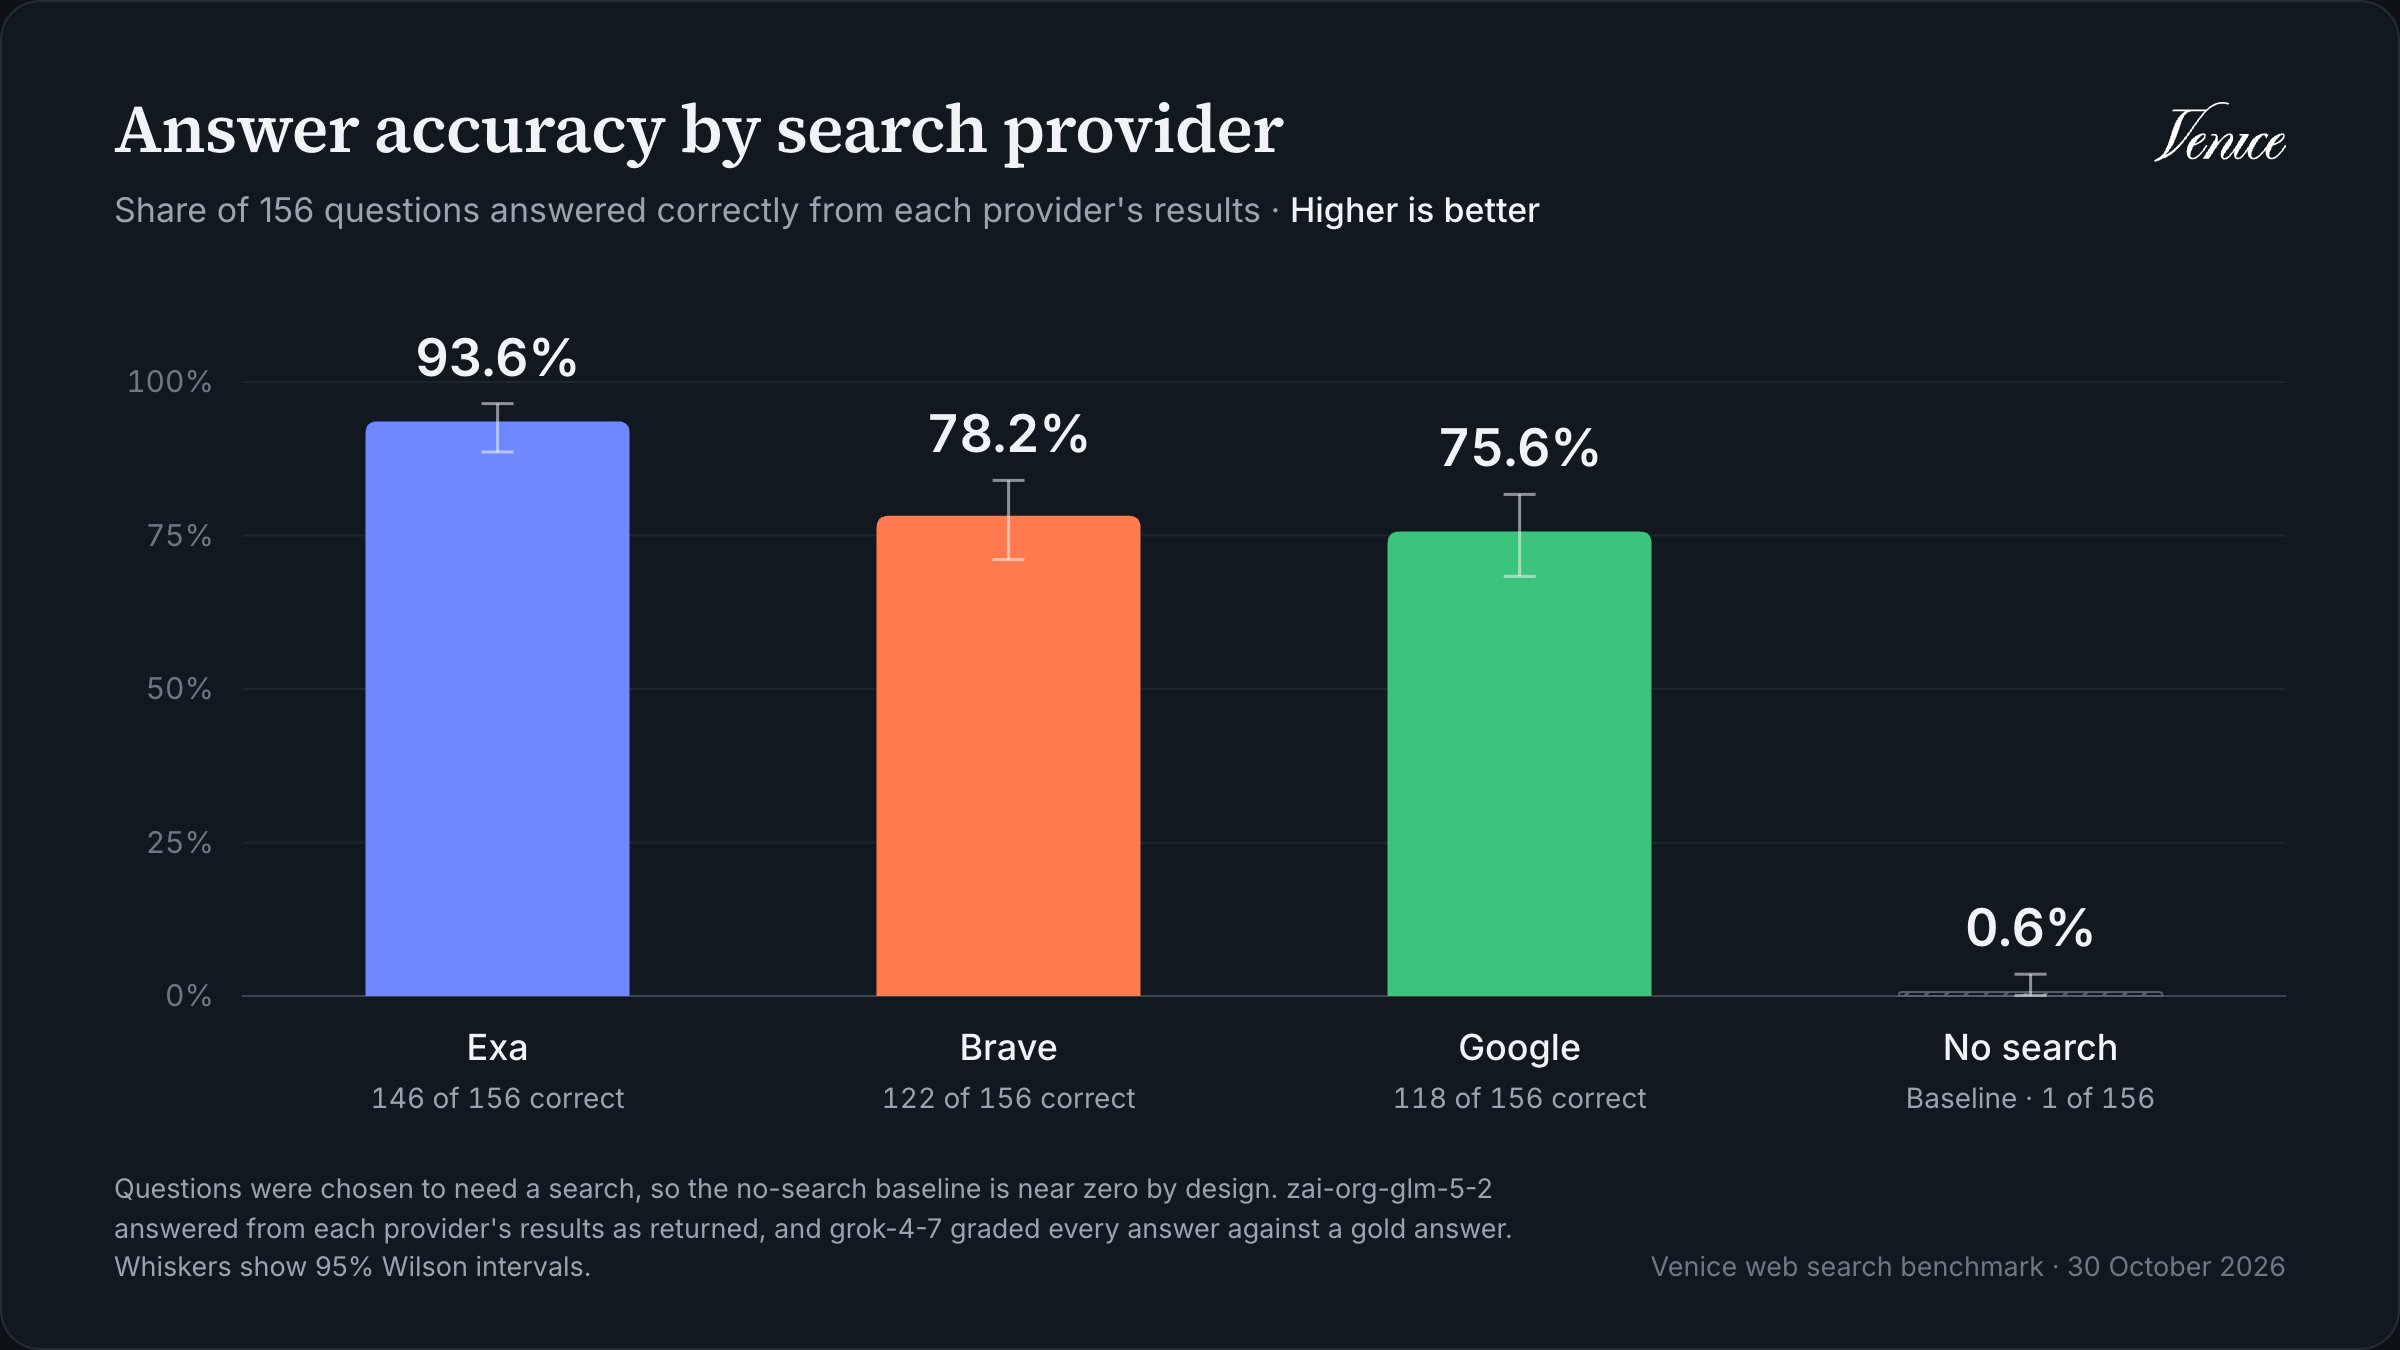
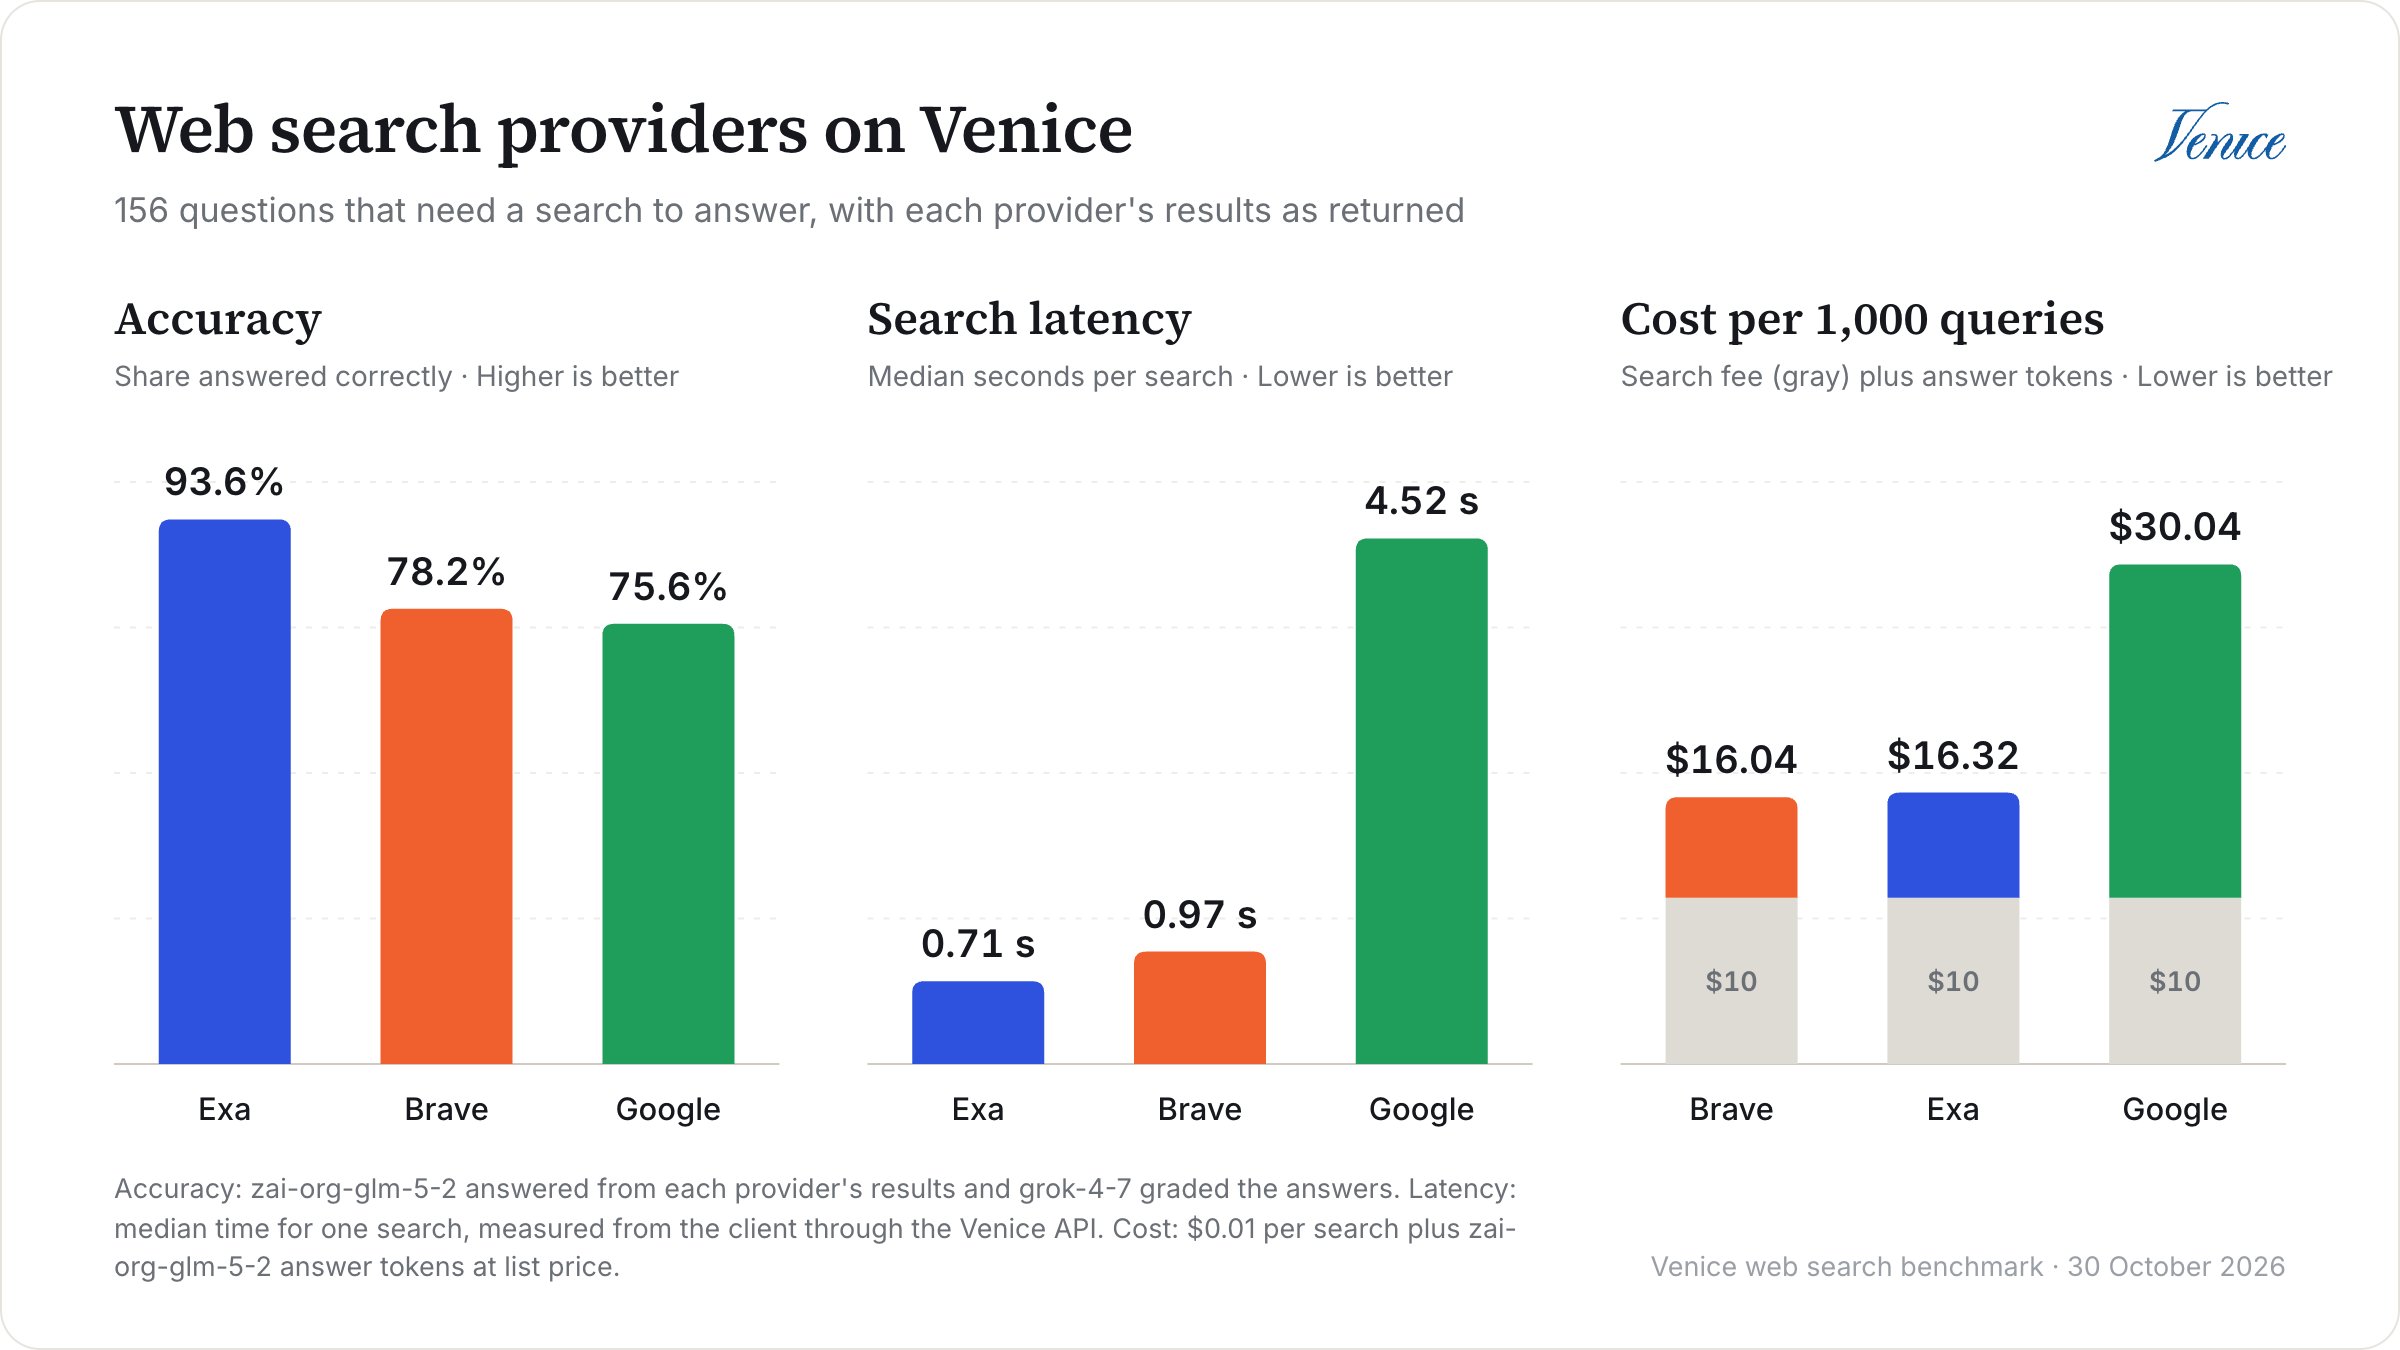
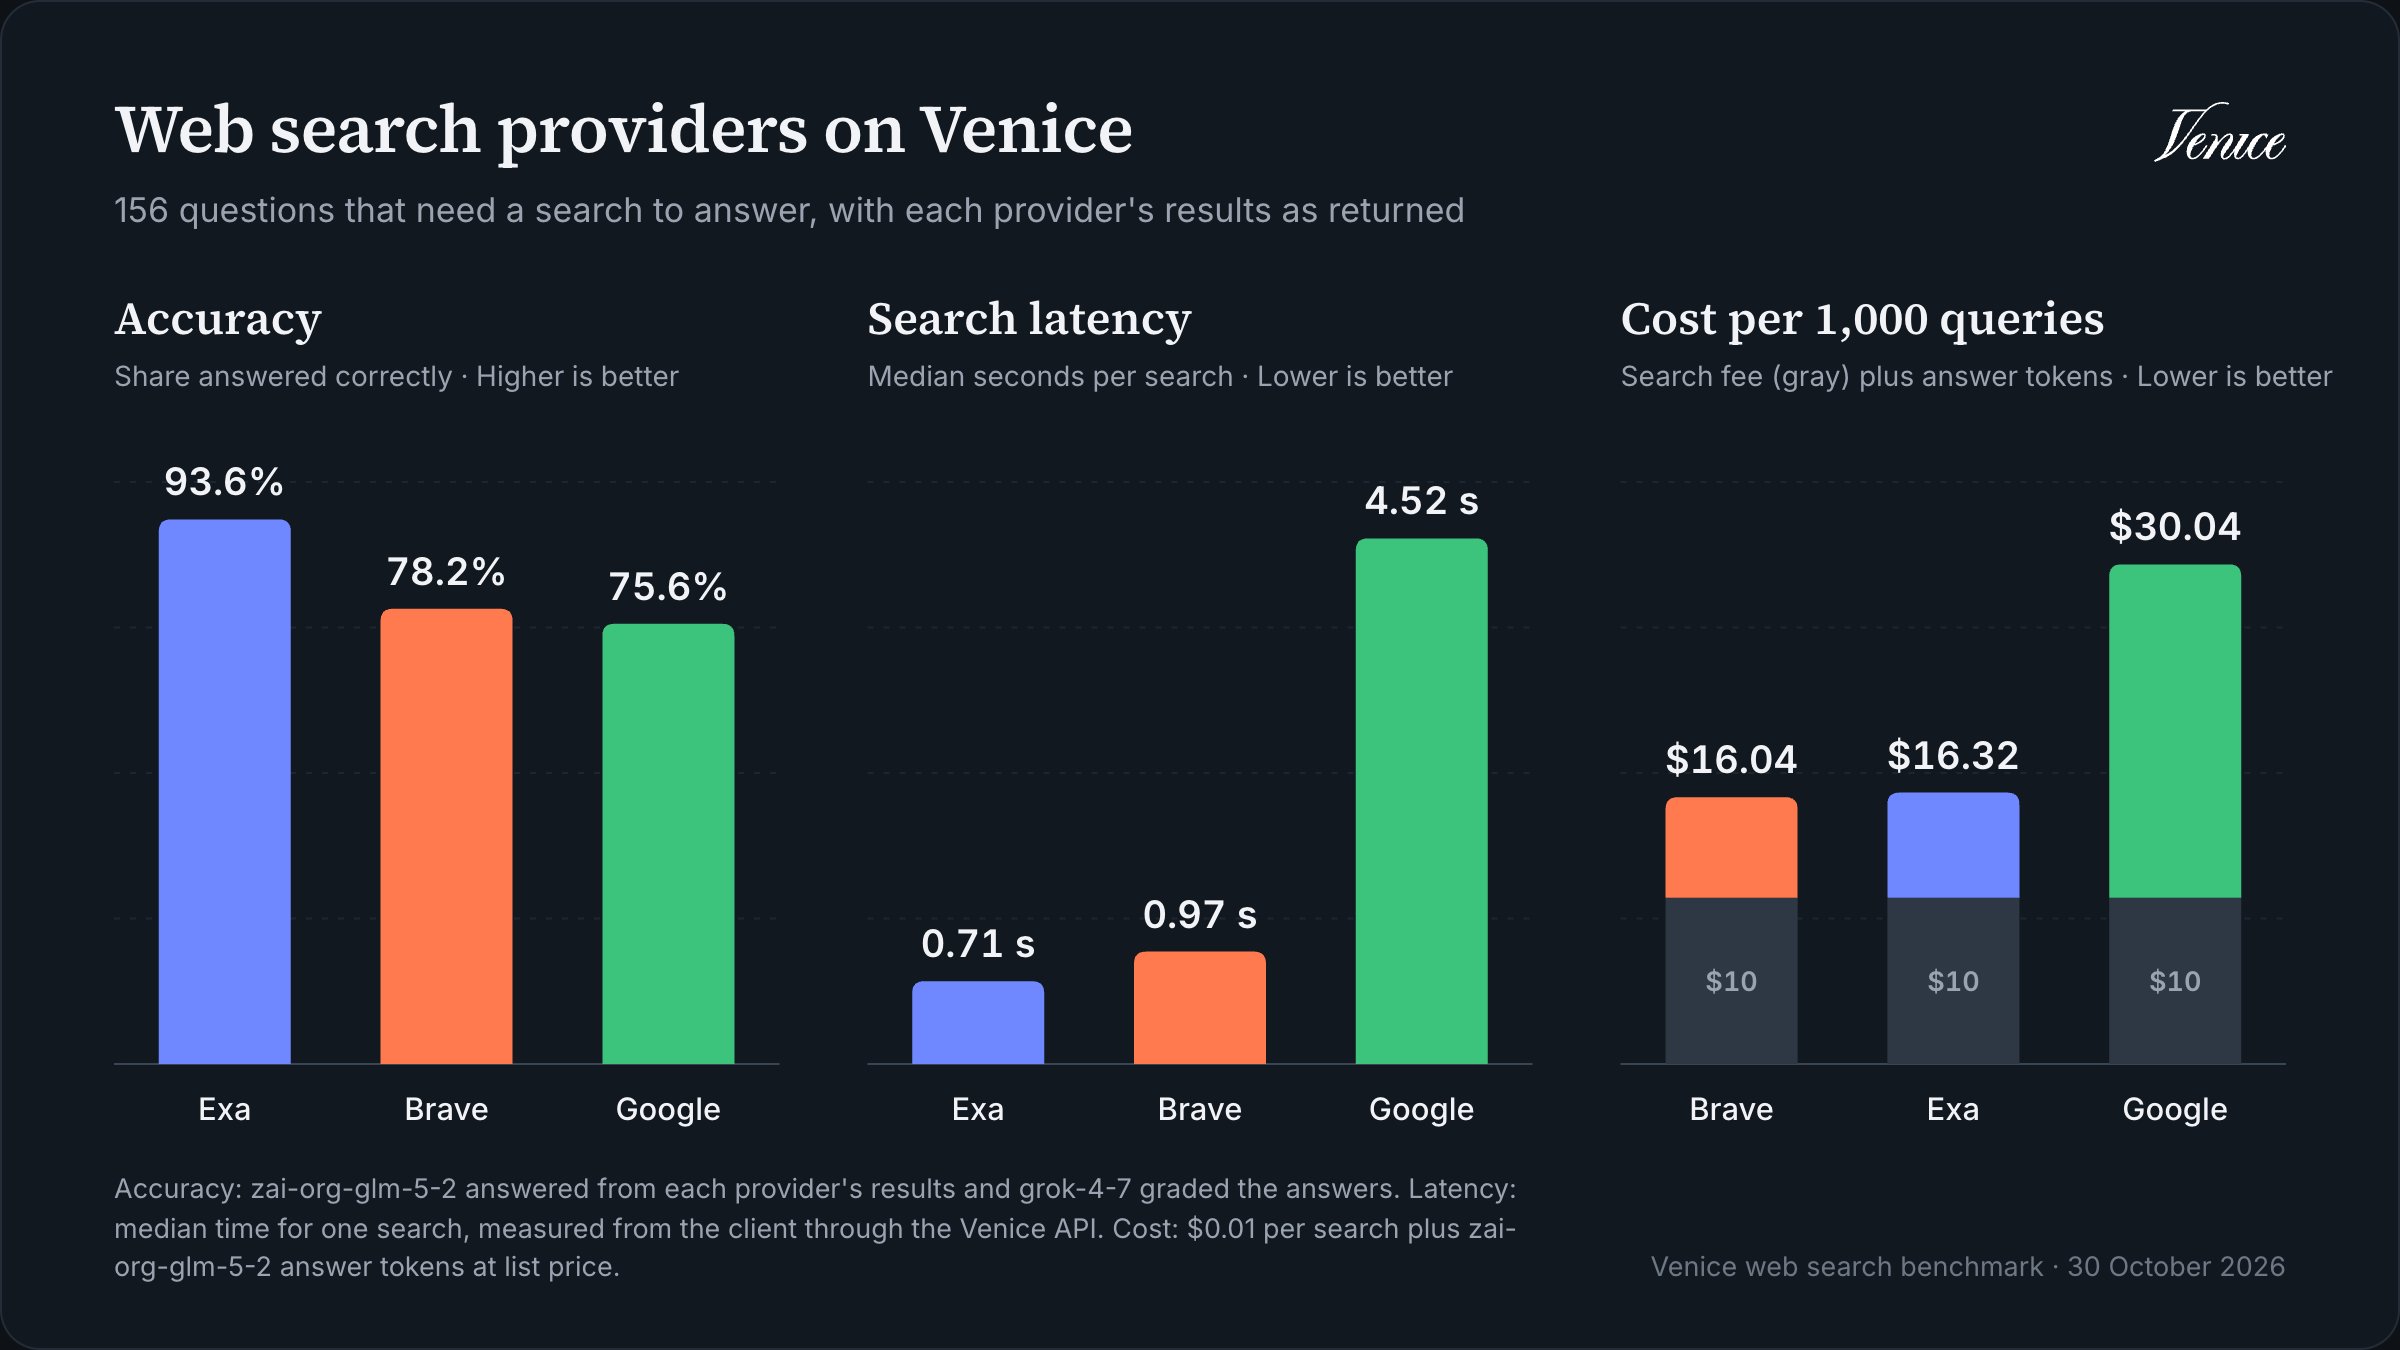
Con todos los resultados tal como se devolvieron, Exa respondió correctamente el 93,6% de las preguntas, unos 15 puntos por delante de Brave y 18 por delante de Google. Esta vez la diferencia es clara: Exa acertó 28 preguntas que Brave falló, con solo 4 en sentido contrario, y 33 que Google falló, frente a 5 (McNemar p < 0.001 en ambos casos).
Para comprobar que no era algo puntual, repetimos el benchmark completo el 11 de noviembre con la misma configuración, y sus resultados también están en el repositorio. Exa volvió a quedar primero, con un 93,6% frente al 81,4% de Brave y el 72,4% de Google, y superó a Brave por 12,2 puntos (24 preguntas a 5, p = 0.001).
Brave frente a Google está menos claro. En esta ejecución quedaron igualados, 22 preguntas a 18, lo que está dentro del ruido. En la repetición, Brave se adelantó, 29 preguntas a 15 (9,0 puntos, p = 0.049). Así que Brave quedó igualado con Google o por delante, según la ejecución.
También queríamos saber si la ventaja de Exa venía de cómo estaban formuladas las preguntas, ya que las buscamos tal cual, y las aplicaciones reales suelen reescribirlas antes como consultas de búsqueda. Así que en otra repetición, el 10 de noviembre, hicimos que el modelo reescribiera cada pregunta una vez como consulta de buscador, enviamos esa misma consulta a los tres proveedores y calificamos las respuestas a la pregunta original. Exa siguió superando a Brave por 13,5 puntos (24 preguntas a 3), y la puntuación de ningún proveedor cambió de forma significativa, así que la formulación no explica la ventaja de Exa.
Las respuestas sin búsqueda también merecen un vistazo. Sin búsqueda, el modelo nos dijo que leyéramos una cabecera
Retry-After tras un 429 en lugar de x-ratelimit-reset-requests de Venice, se inventó un sufijo -web-search para activar la búsqueda web a través del nombre del modelo y mencionó un proveedor de búsqueda venice que no existe. Si tus usuarios preguntan por APIs nuevas o de nicho, el conocimiento propio del modelo no va a bastar.
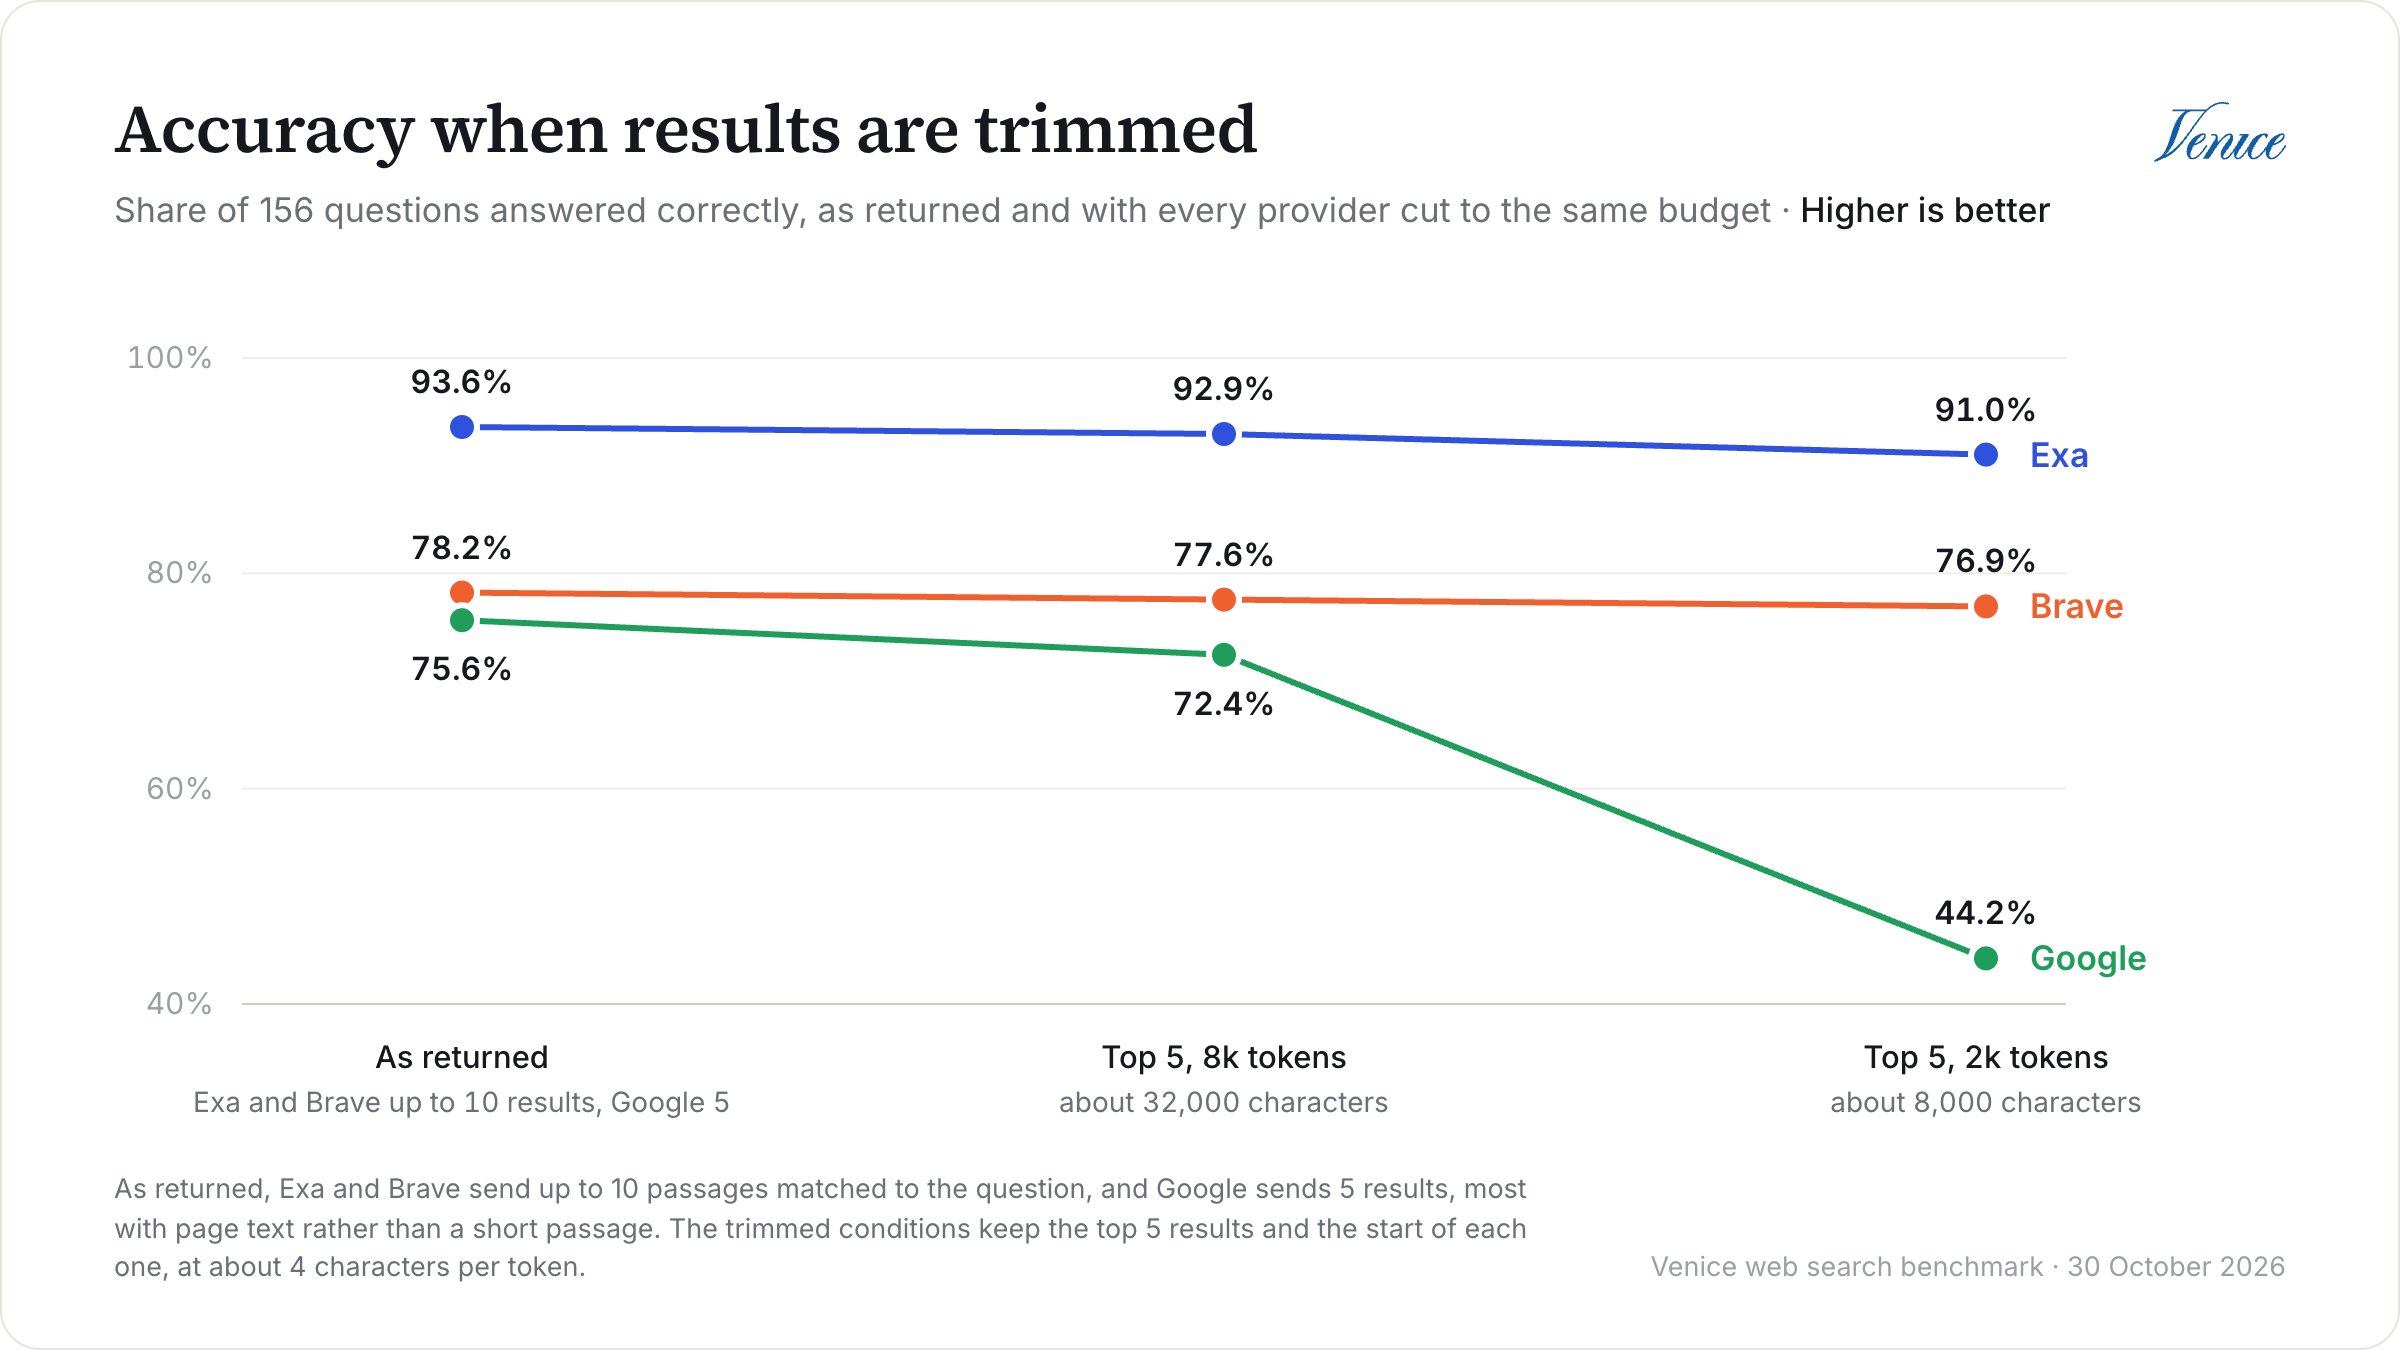
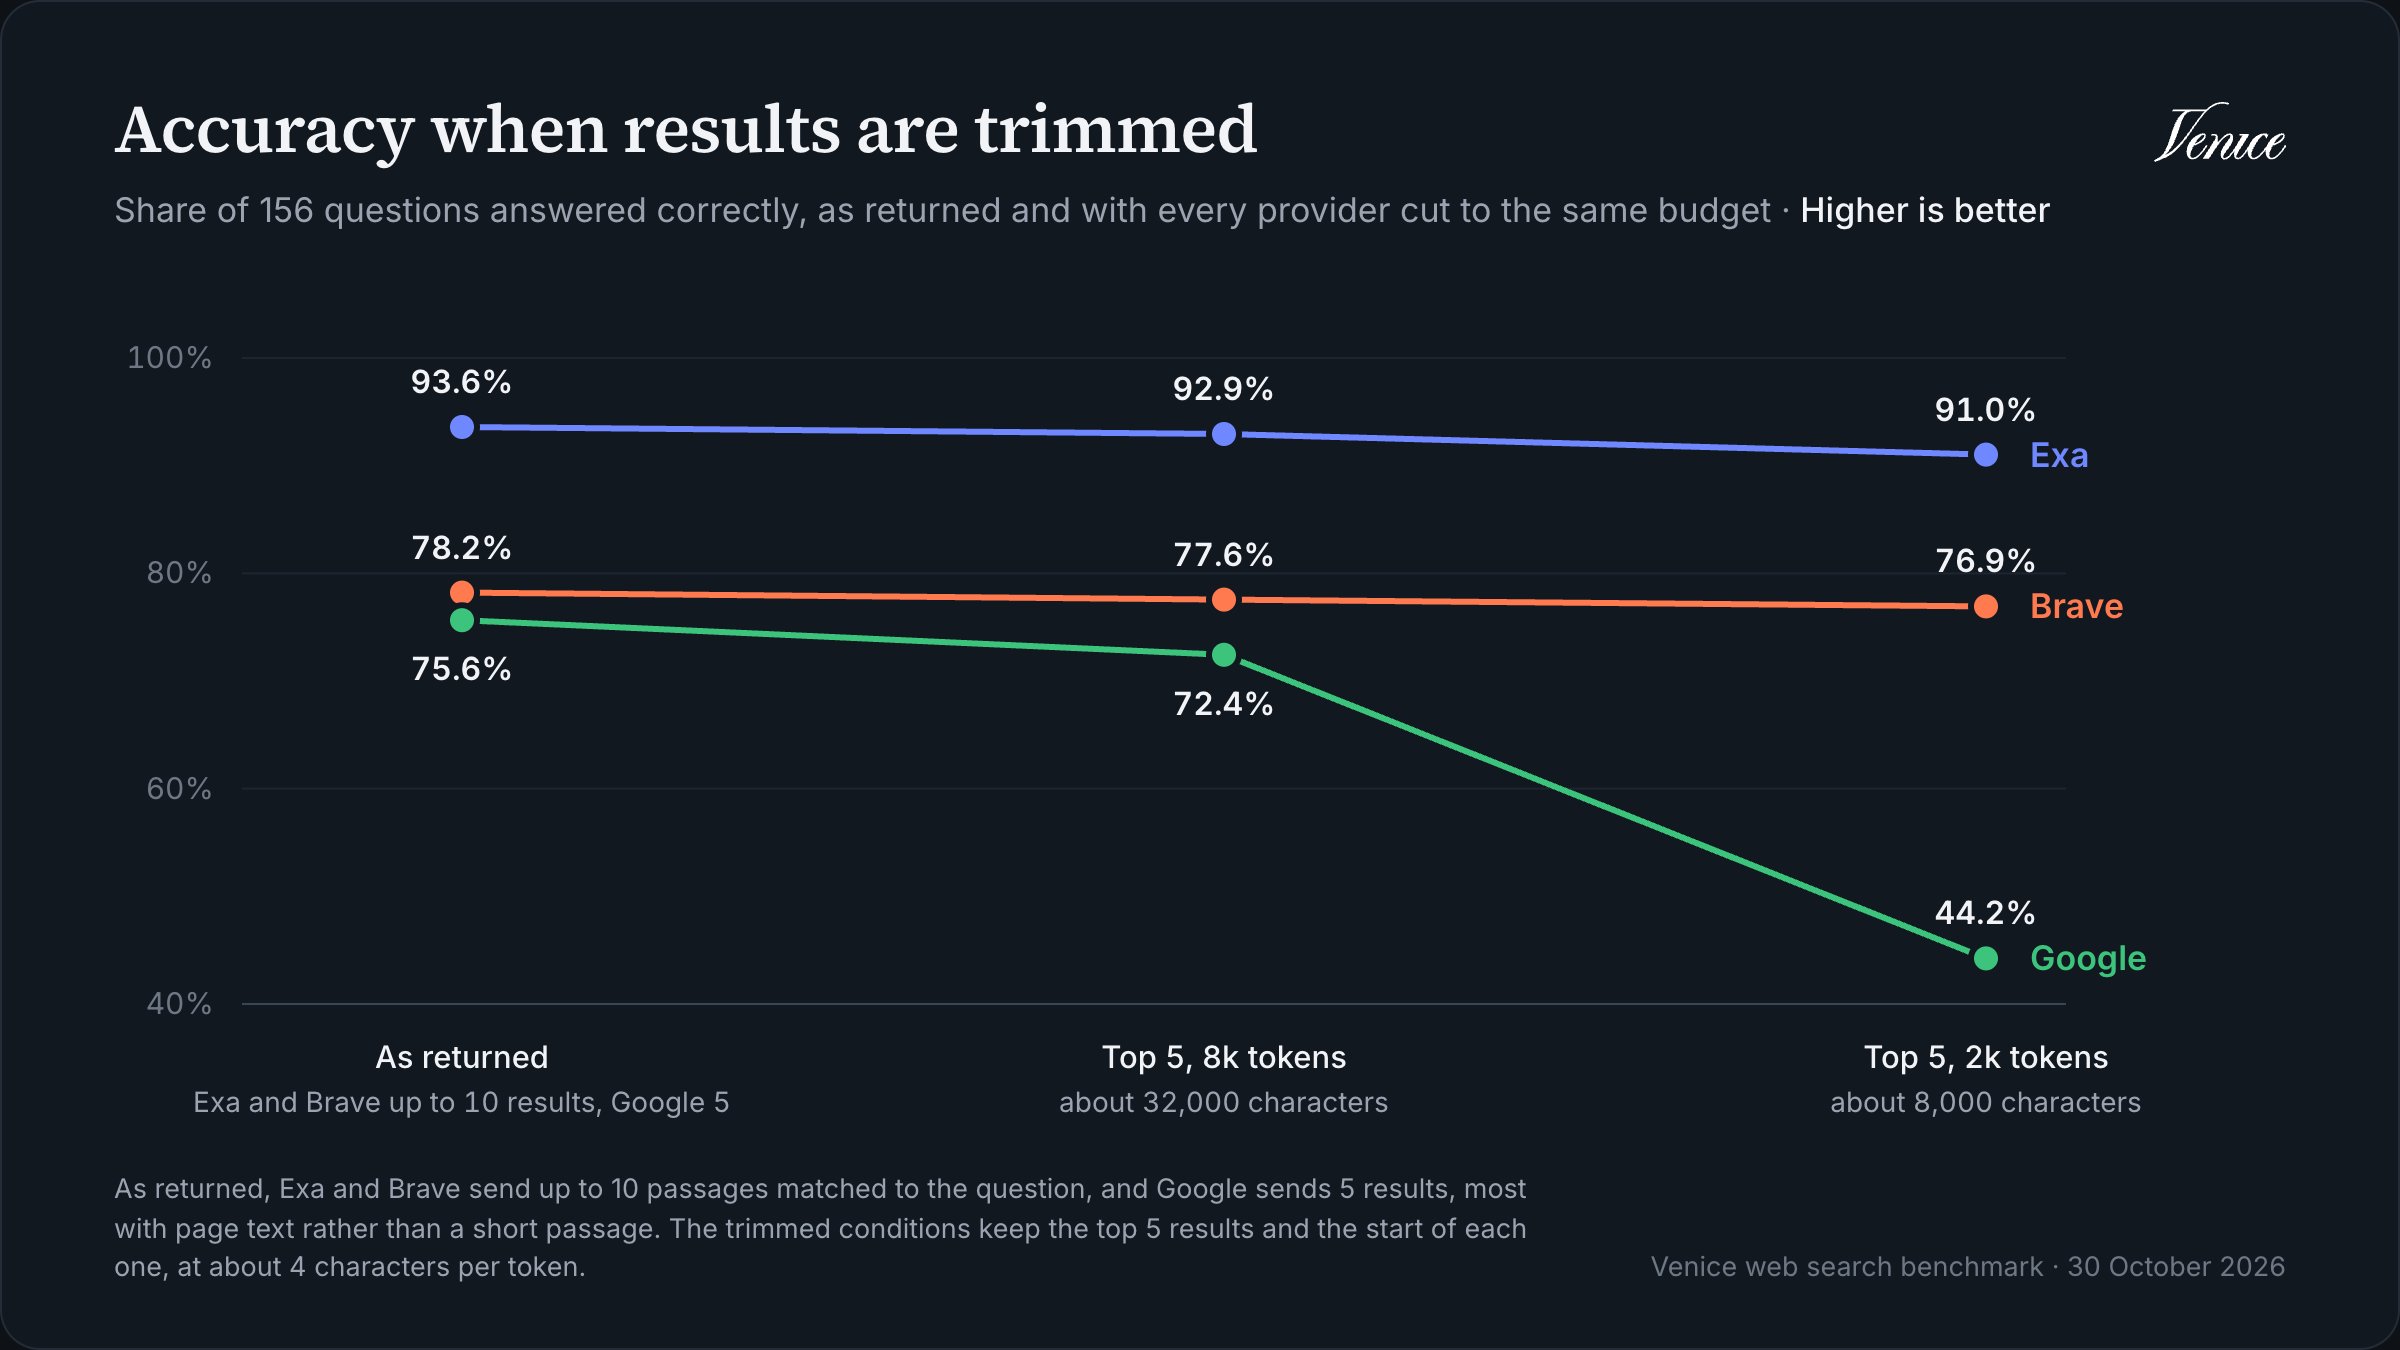
Las condiciones con presupuesto son donde Google se queda atrás. Con 2.000 tokens, su precisión cayó al 44,2%, y el modelo no encontró respuesta para el 30% de las preguntas, frente al 10% cuando tenía los resultados completos de Google. Como los resultados de Google empiezan en la parte superior de la página, recortarlos para que cupieran conservó la navegación y los banners y eliminó la parte que respondía a la pregunta. Los resultados de Brave y Exa ya son pasajes ajustados a la pregunta, así que recortarlos apenas marcó diferencia. Con 8.000 tokens, Google recuperó casi todo el terreno, hasta el 72,4%.
De dónde viene la ventaja de Exa
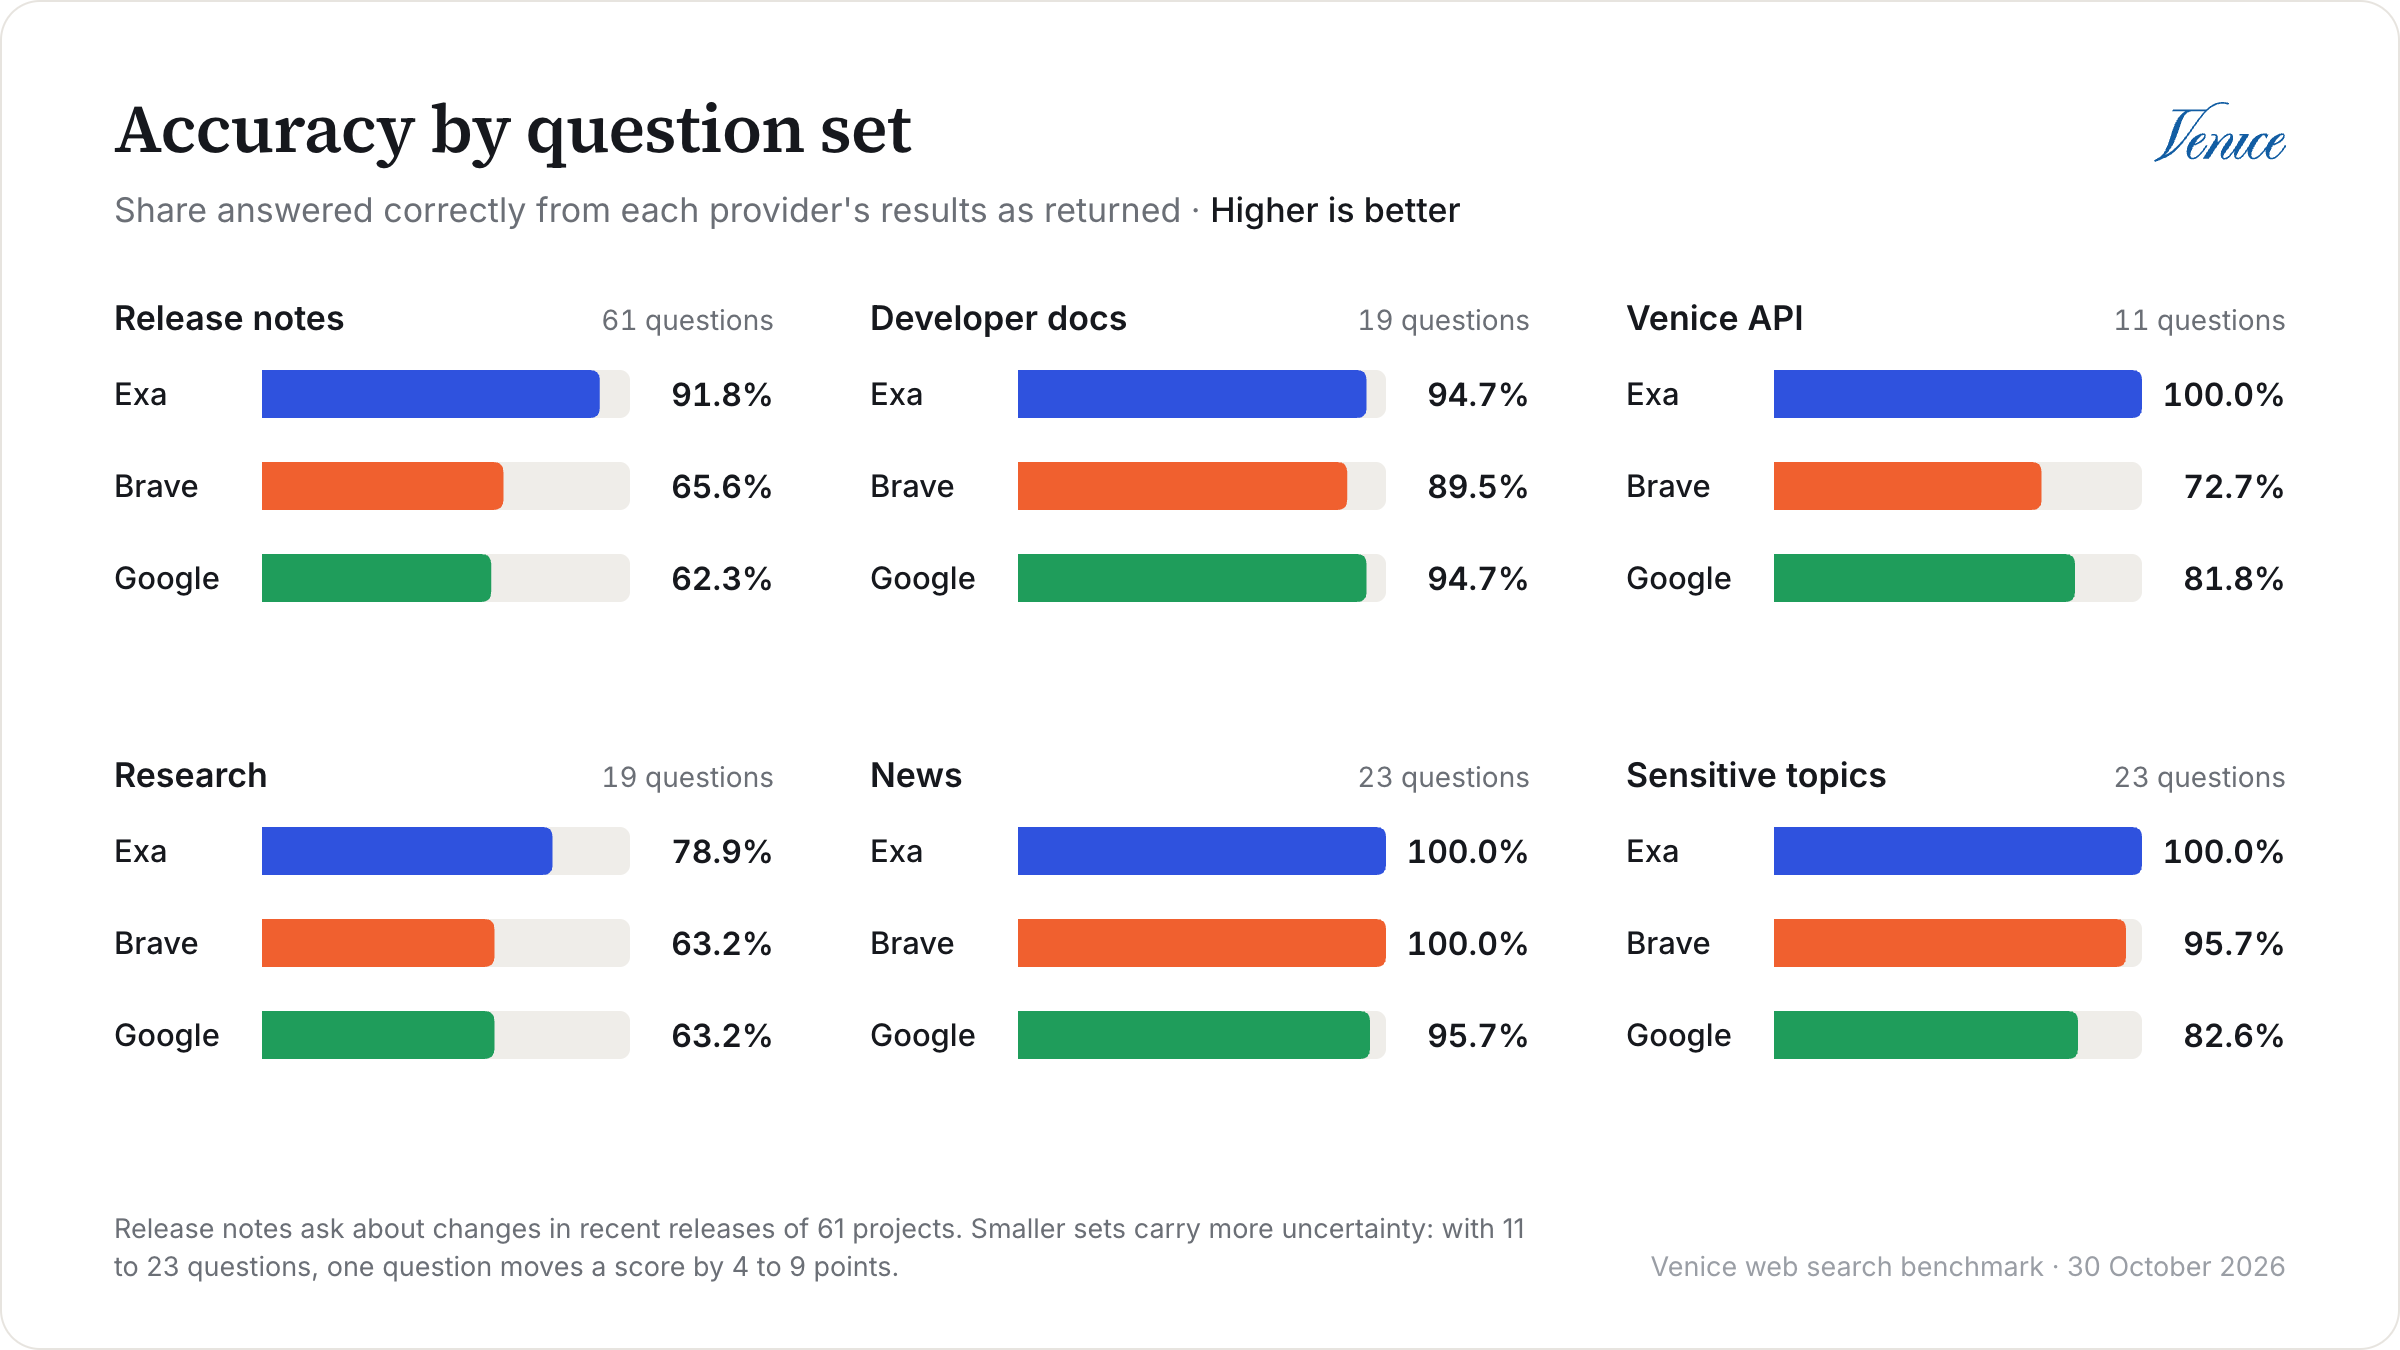
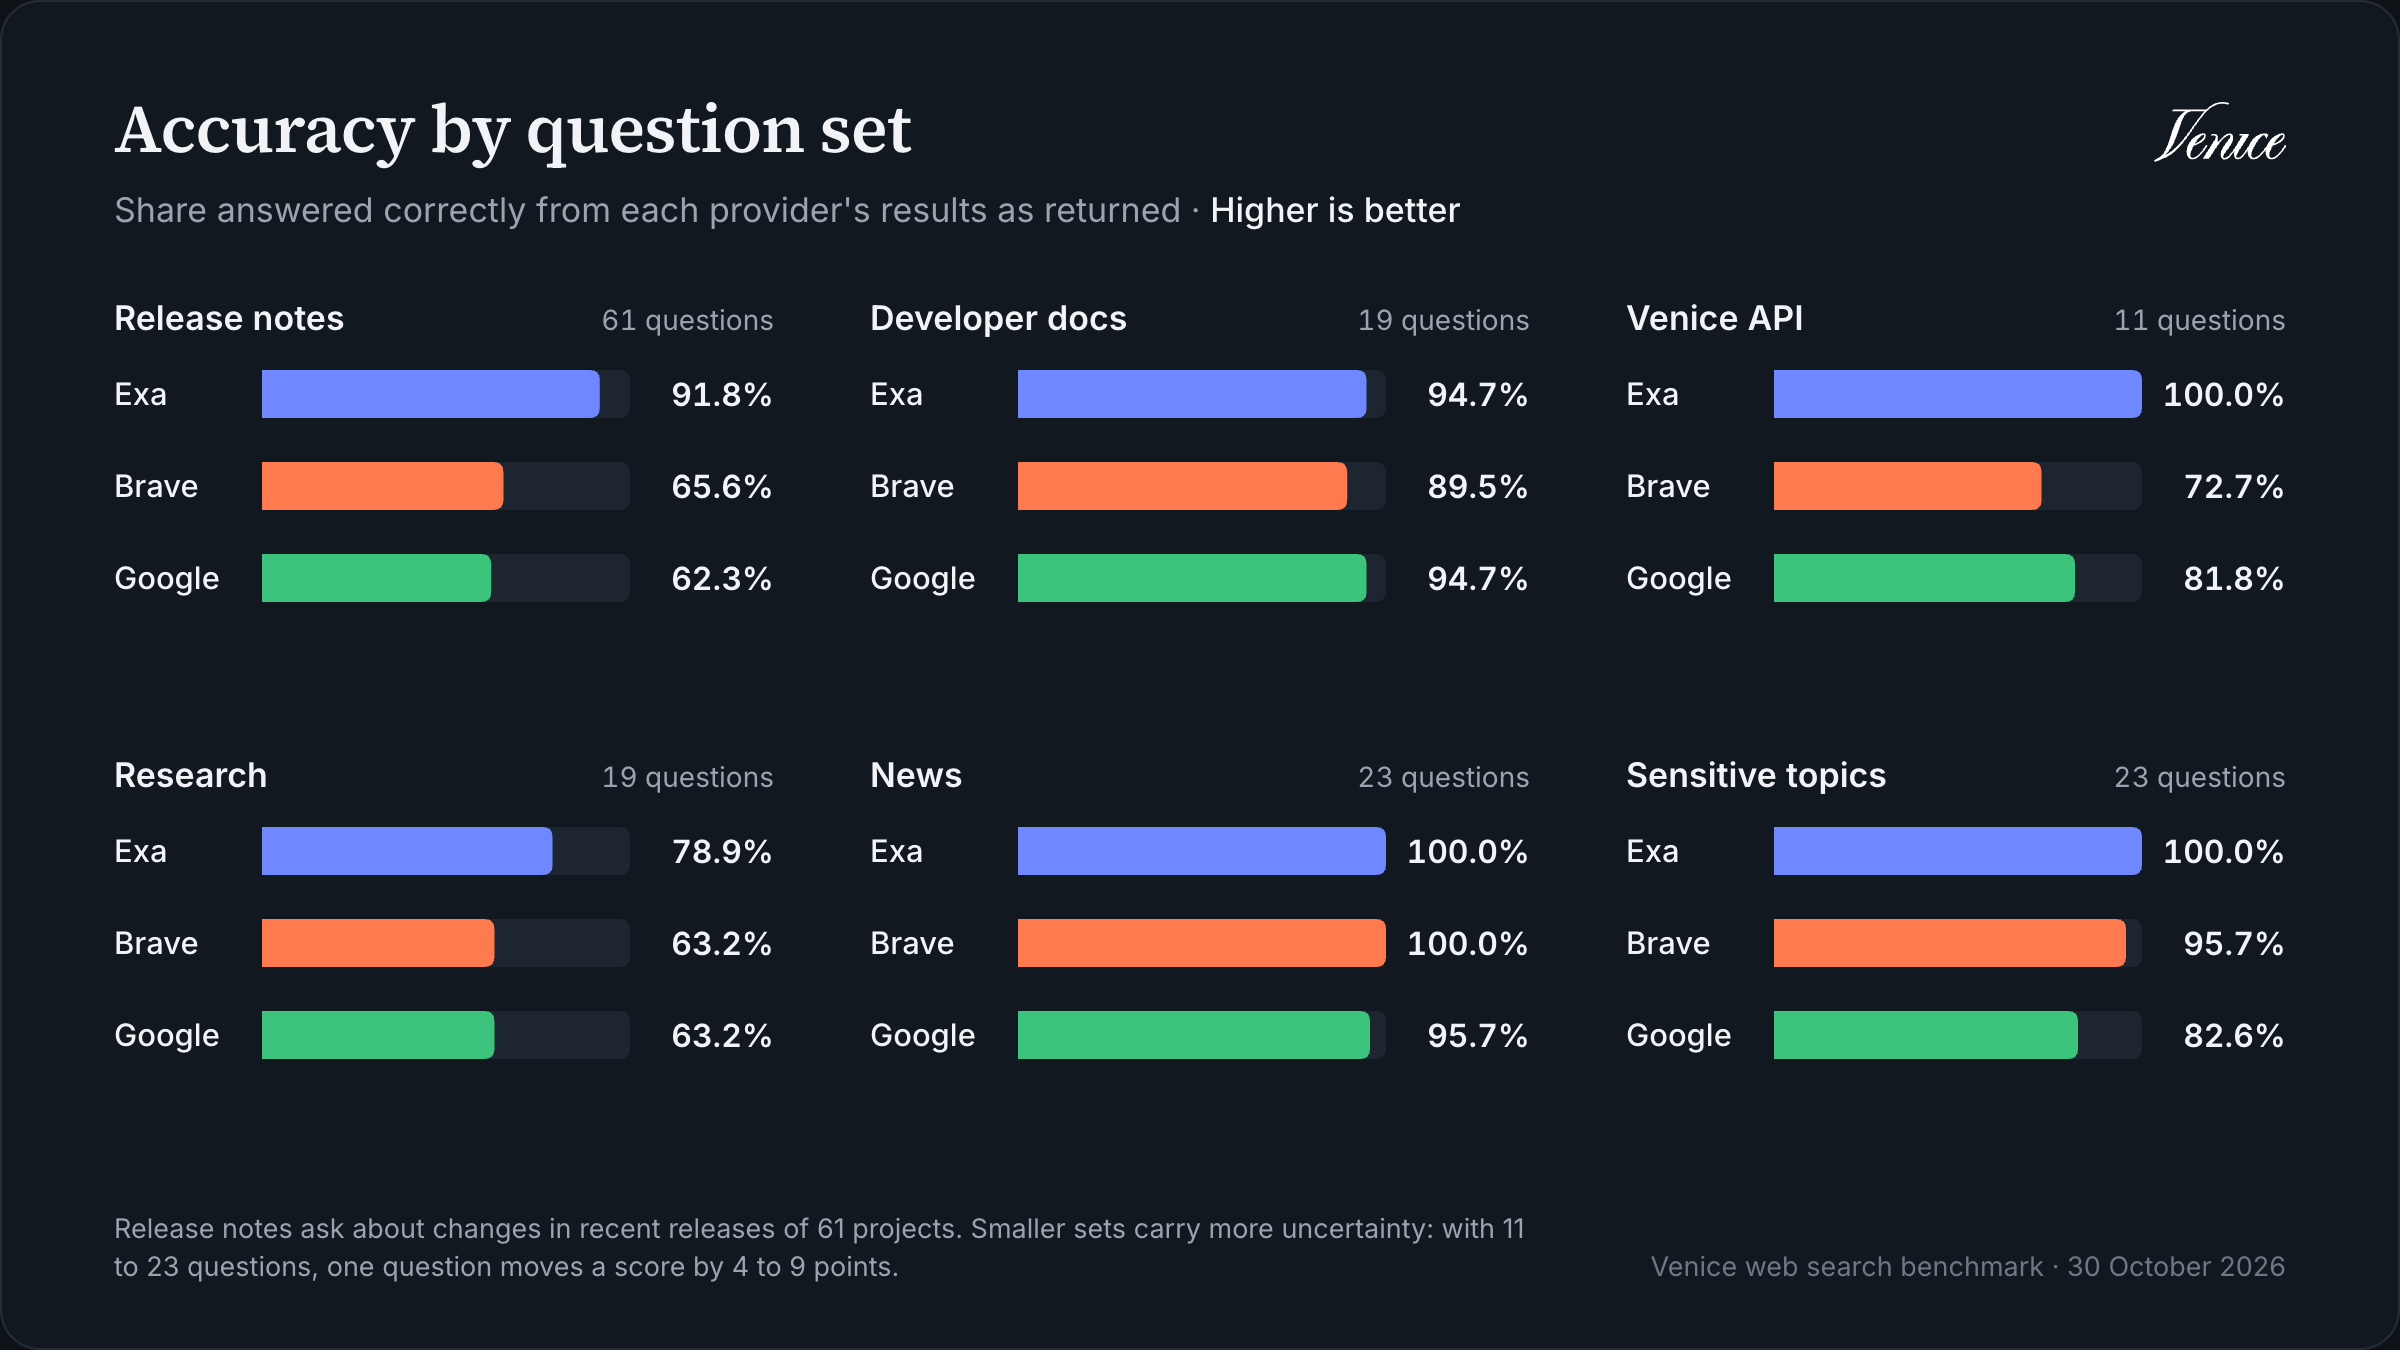
La mayor parte de la diferencia viene de un solo sitio: las notas de versión. Exa respondió correctamente 56 de las 61 preguntas de versiones, frente a 40 de Brave y 38 de Google. La respuesta a estas suele estar en una sola línea de un changelog, y los resultados de Exa tenían muchas más probabilidades de incluirla. En las preguntas de versiones con un identificador conocido, como un flag o una variable de entorno, los resultados de Exa contenían el 97% de ellos de forma literal, frente al 76% de Brave y el 68% de Google. En las preguntas ligadas a una versión de todos los conjuntos de programación, Exa acertó el 95% y los otros dos el 55%.
Las preguntas de investigación fueron las más difíciles para todos, ya que necesitan dos datos de dos páginas distintas, e incluso Exa solo acertó 15 de las 19. En noticias y documentación para desarrolladores, en cambio, los tres proveedores respondieron casi todo. Si las preguntas de tus usuarios se parecen a esas, el proveedor que elijas importa mucho menos.
¿Y los temas sensibles?
Algunos servicios de búsqueda filtran o entierran los resultados sobre temas sensibles, así que añadimos 23 preguntas para comprobar si alguno de los tres proveedores lo hacía. Cubren temas como legislación sobre drogas, aborto, trabajo sexual, armas de fuego, vigilancia y cortes de internet, y cada una tiene una respuesta factual de una fuente oficial, como una sentencia judicial o un aviso gubernamental. Ningún proveedor devolvió resultados vacíos ni un error en ninguna de ellas, y el modelo nunca se negó a responder una por su tema. Exa respondió correctamente las 23, Brave 22 y Google 19. Los fallos fueron fallos de búsqueda normales, en los que los resultados no tenían el dato o tenían una fecha distinta, salvo una respuesta de Google que dudó pero dio la fecha correcta, con la que el juez fue demasiado estricto. Ten en cuenta que 23 preguntas solo pueden mostrar que no vimos ningún filtrado, no que no exista en ningún caso.Exa devolvió el texto más útil
Los resultados de Exa también fueron los más relevantes. Su nDCG@5 fue 0,15 superior al de Brave (IC del 95%: 0,11 a 0,19) y 0,32 superior al de Google (IC del 95%: 0,28 a 0,36), y Brave quedó 0,17 por delante de Google.
Eso sí, las cifras de Google aquí incluyen un problema que ya se ha corregido. En esta ejecución, los resultados 4 y 5 de Google eran enlaces de redirección
google.com/goto?url=… en 144 de las 162 búsquedas, y la mayoría casi no tenía texto, así que alrededor de un tercio de los 5 primeros resultados de Google estaban prácticamente vacíos. Habían desaparecido en la repetición del 11 de noviembre, donde el nDCG@5 de Google subió de 0,43 a 0,47 y su gold URL hit@5 del 27,6% al 31,4%. Exa y Brave siguieron por delante.
Esa puntuación cubre el texto que devolvió cada proveedor, no solo las páginas que eligió. Cuando dos proveedores devolvieron la misma página, el juez dio a ambas copias la misma puntuación el 71% de las veces, y cuando las puntuaciones difirieron, la copia más corta obtuvo menos en el 69% de los casos. Para separar ambas cosas, el harness también puntúa cada página con la mejor nota que obtuvo cualquier copia de ella de cualquier proveedor. Con esa medida por página, la ventaja de Exa sobre Brave se reduce a 0,09 (IC del 95%: 0,05 a 0,13), pero no desaparece, y ambos eligieron mejores páginas que Google. Ten en cuenta que esto solo iguala las cosas para las páginas que devolvió más de un proveedor. Todo lo demás se sigue puntuando con el texto propio de cada proveedor.
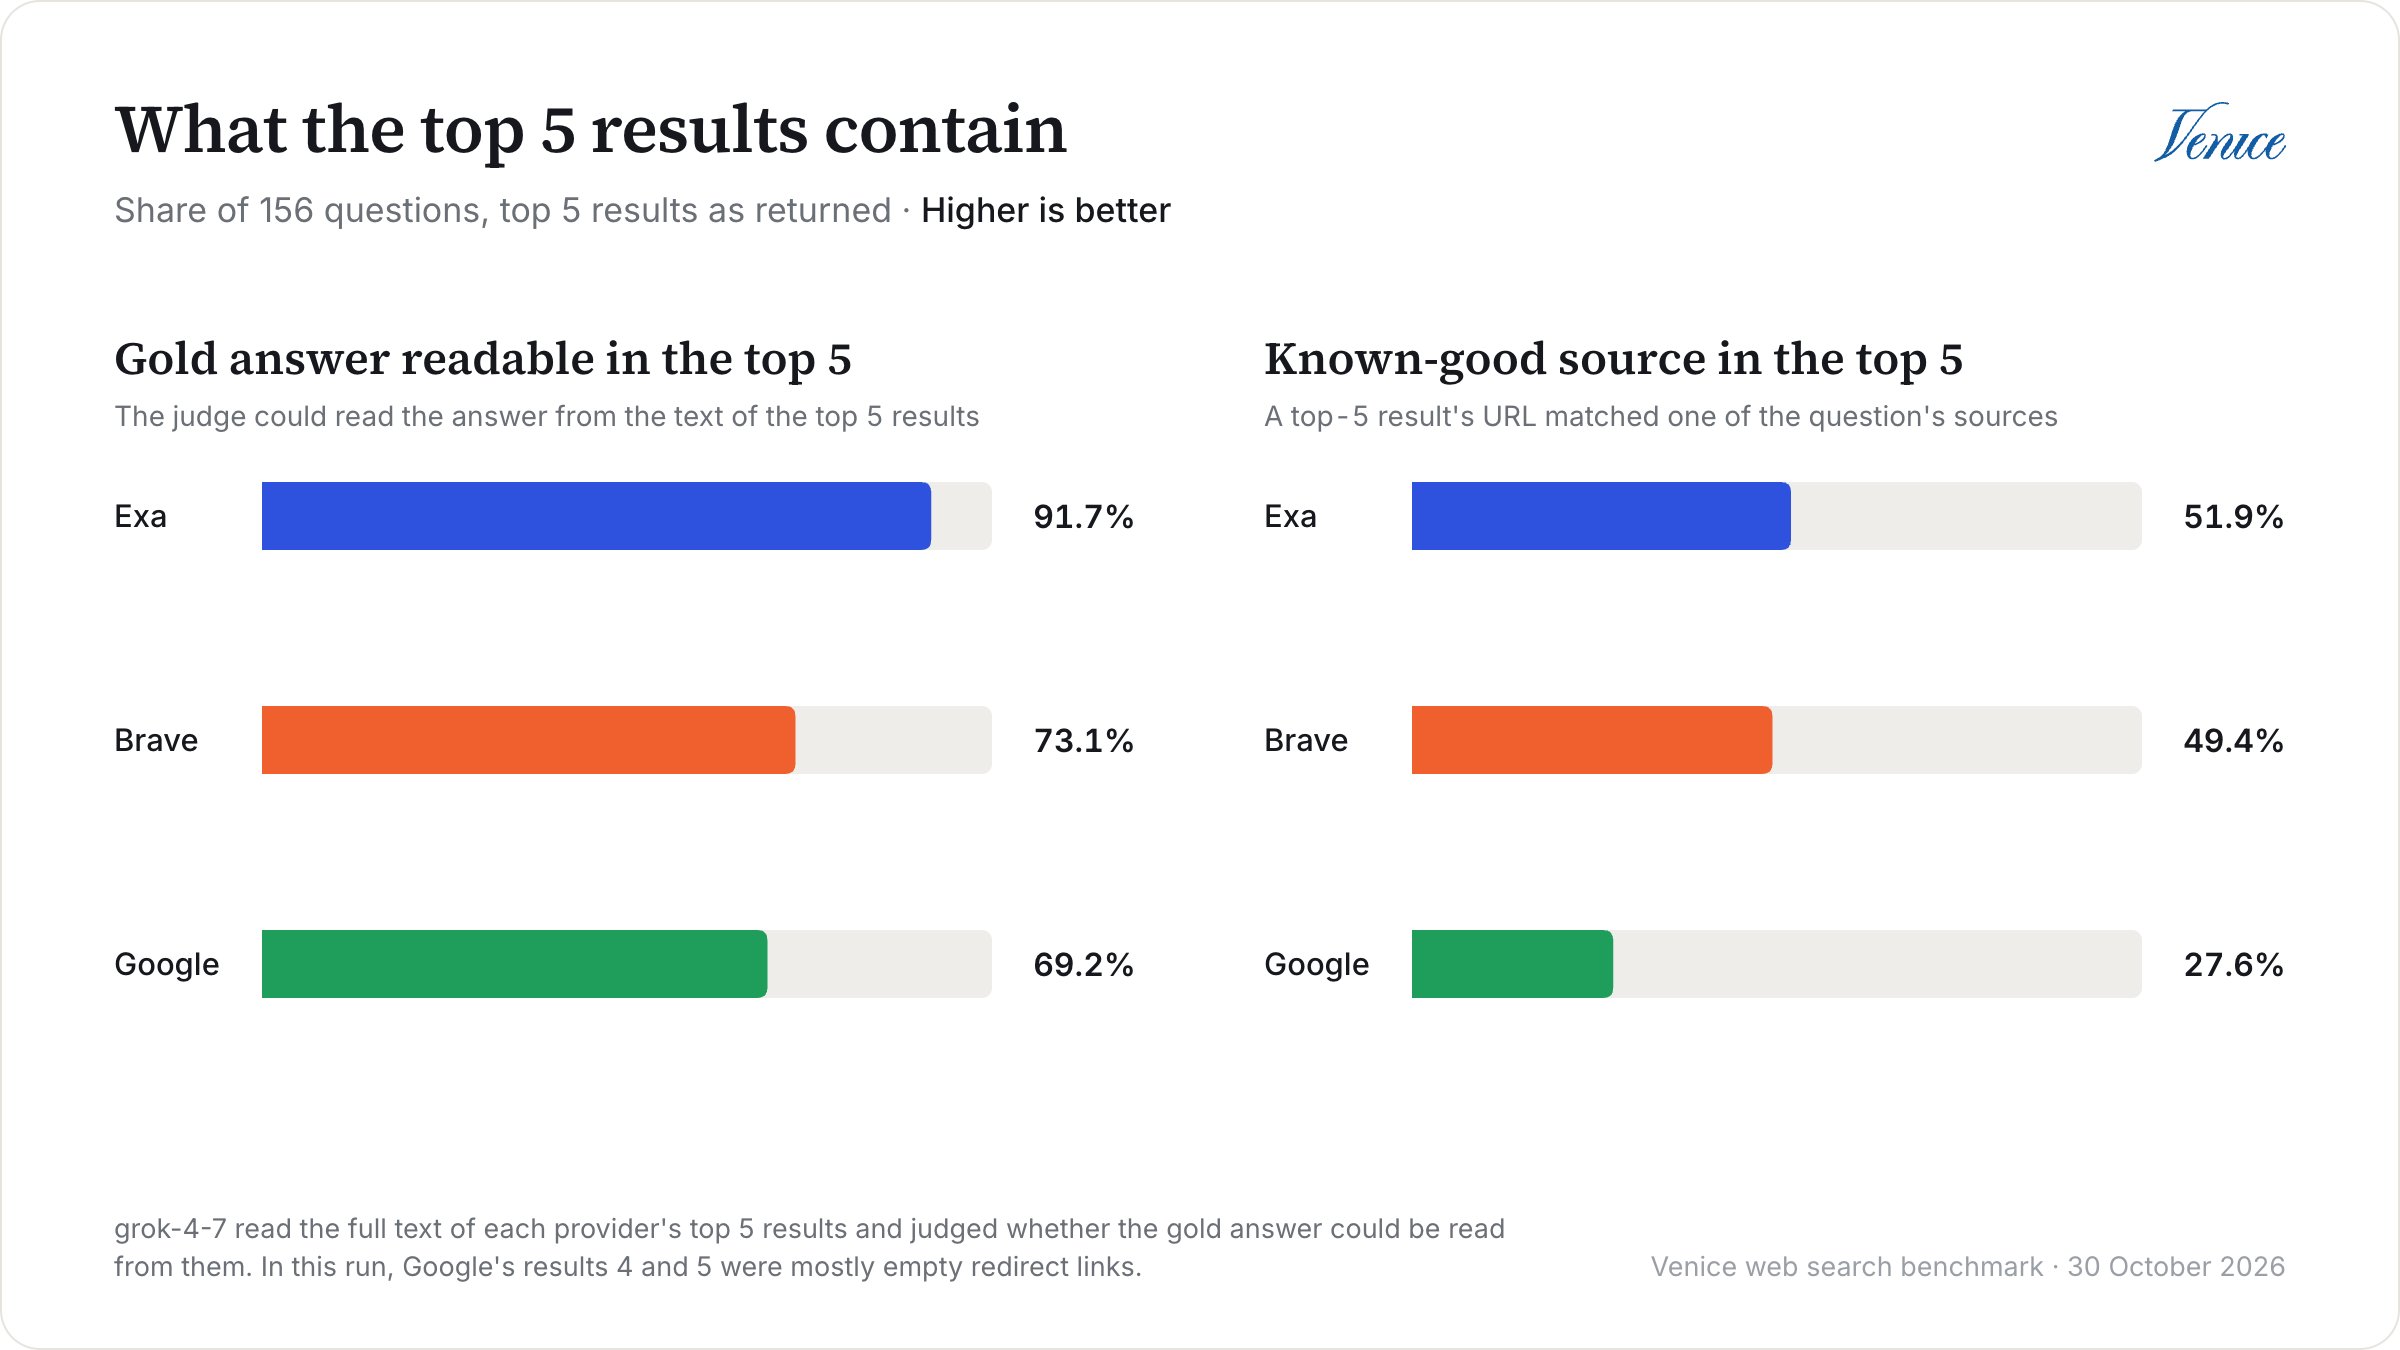
Brave y Exa cuestan casi lo mismo, y Google es el más caro
La búsqueda en sí cuesta lo mismo, $10 por 1.000 consultas, en todos los proveedores, así que la diferencia de coste viene de los tokens que envías al modelo después. Brave y Exa salieron casi iguales, mientras que el texto de página de Google hizo que los prompts de respuesta fueran unas 3,6 veces más grandes que los de Brave, lo que casi duplicó el coste por consulta. Estos costes usan los precios de lista de
zai-org-glm-5-2 sin descuento por caché, así que las cifras exactas dependen de tu modelo, pero las proporciones entre proveedores se mantienen.
Exa fue el más rápido en la mediana esta vez, con 0,71 segundos frente a 0,97 de Brave, pero no ordenaríamos a esos dos: Brave fue más rápido en nuestra primera ejecución, el día anterior, cuando la mediana de Exa fue de 1,73 segundos, y de nuevo en la repetición del 11 de noviembre, con 0,99 segundos frente a 1,54. La latencia se mide desde el cliente a través de la API de Venice, así que incluye el tiempo de red y la sobrecarga propia de Venice, y varía entre ejecuciones. Lo que sí se mantuvo en las tres ejecuciones es que Brave y Exa se quedaron por debajo de 2 segundos en la mediana, y Google fue el más lento todas las veces, con 4,52 segundos aquí y 5,36 en la repetición.
Las preguntas generales
Las 6 preguntas generales no tienen respuesta de referencia, así que en su lugar el juez comparó cara a cara las respuestas de cada par de proveedores, dos veces e intercambiando el orden. Las respuestas de Exa superaron a las de Google en 4 de ellas, pero con solo 6 preguntas no es algo en lo que nos apoyaríamos. El desglose completo está en el informe.Entonces, ¿cuál deberías usar?
Según esta ejecución, así es como elegiríamos:- Exa, para la mayoría de cargas de trabajo que pasan los resultados directamente a un modelo, y especialmente asistentes de programación y agentes de investigación. Tuvo la mejor precisión, o empatada con la mejor, en todos los conjuntos de preguntas y los resultados más relevantes, con un coste por consulta casi igual al de Brave.
- Brave, si tus preguntas se parecen más a nuestras preguntas de noticias y documentación, donde quedó igualado con Exa, o si sobre todo necesitas encontrar la página oficial de algo, cosa que logró casi tan a menudo como Exa. Es el predeterminado, y es rápido y barato.
- Google, si quieres el texto de la página directamente en la respuesta de búsqueda, sin una extracción aparte. La mayoría de los resultados son la página completa, pero alrededor de una cuarta parte son solo el fragmento, cuando el sitio bloquea la extracción. Tendrás que presupuestar los tokens y la latencia adicionales y, si recortas los resultados, conserva los pasajes que coinciden con la pregunta en lugar del inicio de cada página.
Advertencias
Hay algunas cosas que conviene tener en cuenta antes de sacar demasiadas conclusiones de estas cifras:- Las preguntas se eligieron para que necesitaran búsqueda. Descartamos todas las preguntas que el modelo podía responder por sí solo, así que el conjunto es más difícil que el tráfico cotidiano.
- Las preguntas las escribieron agentes de IA. Cada una se comprobó contra sus fuentes y se revisó, pero una respuesta de referencia todavía puede estar mal. Si encuentras alguna, abre un issue en el repositorio.
- Las notas de versión son una parte importante del conjunto. Son 61 de las 156 respuestas de referencia, y de ahí viene la mayor parte de la ventaja de Exa, así que compara la tabla por conjunto de preguntas con tu propia carga de trabajo.
- Las calificaciones vienen de un modelo. Revisamos cada respuesta que el juez no marcó como correcta con los resultados tal como se devolvieron, 82 en total, más 30 que sí marcó. Cambiaríamos 6 de ellas, todas de incorrecta a correcta: 3 de Brave, 2 de Google y 1 de Exa. Eso dejaría a Brave en 80,1%, a Google en 76,9% y a Exa en 94,2%, así que la clasificación no cambia, pero el juez tiende a ser un poco estricto.
- Los resultados de búsqueda cambian. Estas cifras son una instantánea de octubre de 2026, y las respuestas de referencia sensibles al tiempo, sobre todo las de noticias, se quedan obsoletas. Nuestra repetición del 11 de noviembre mantuvo la misma clasificación para Exa, pero movió a Brave frente a Google y las puntuaciones de relevancia de Google.
- Nuestra ejecución principal buscó cada pregunta tal cual estaba escrita. Reescribir las preguntas como consultas de búsqueda no cambió la clasificación en nuestra repetición del 10 de noviembre, pero la reescritura propia de tu aplicación podría hacerlo.
- Probamos los proveedores a través de la API de Venice. Cada uno devuelve los resultados en su propio formato, así que estas cifras describen las tres opciones tal como las devuelve la API, no los buscadores en general.
- Las puntuaciones de relevancia dependen de cuánto texto se devuelve. Un extracto corto puede puntuar menos que una copia más larga de la misma página. La puntuación por página corrige esto en las páginas que devolvió más de un proveedor, pero no en el resto.
- Las condiciones con presupuesto recortan desde el final. Un pipeline que elija pasajes por relevancia trataría los resultados de Google mejor que el nuestro.
- Un solo modelo escribió todas las respuestas, y el mismo modelo filtró las preguntas. Un modelo distinto podría aprovechar mejor (o peor) los resultados largos, y quizá ya conozca algunas de las respuestas.
Ejecútalo tú mismo
El harness es un pequeño proyecto de Bun y TypeScript sin dependencias de runtime. Una vez que hayas clonado el repositorio, instala las dependencias de desarrollo y ejecuta las pruebas:.env en el repositorio:
--budget, que por defecto es $5. Nuestra ejecución completa costó $36.10: $4.86 por 486 búsquedas, más los tokens de respuesta y del juez. La estimación no tiene en cuenta los descuentos por caché, así que sale más alta, unos $50. Cada ejecución escribe un report.md con las tablas completas detrás de este artículo, un results.csv con una fila por pregunta, proveedor y condición, un summary.json y dos archivos con cada respuesta y la lista de resultados de cada proveedor.
Si solo quieres explorar nuestras cifras, no necesitas ejecutar nada, ya que la carpeta results del repositorio tiene todo esto de esta ejecución.
Pero el verdadero valor está en ejecutarlo con tus propias preguntas. Escríbelas en formato JSON Lines, con un objeto por pregunta:
goldAnswer siguen recibiendo puntuaciones de recuperación, así que puedes empezar con una lista de consultas reales de tus logs y añadir respuestas de referencia más adelante. Antes de fiarte de las cifras de precisión, comprueba cuántas de tus preguntas acierta el modelo con --arms none, ya que las preguntas cuya respuesta ya conoce no distinguirán a tus proveedores.