

brave, google ou exa. Ils coûtent tous le même prix, 0,01 $ par recherche, donc la question évidente est de savoir lequel utiliser.
Dans cet article, nous allons le découvrir. Nous avons construit un benchmark qui envoie les mêmes 162 questions à chaque fournisseur, fait répondre le même modèle à partir des résultats de chaque fournisseur, et note à la fois les résultats et les réponses. Nous verrons comment nous avons choisi les questions, ce que nous avons trouvé et comment vous pouvez le lancer vous-même.
Vous voulez le code complet ? Consultez le dépôt GitHub. Il contient aussi chaque réponse et la liste de résultats de chaque fournisseur pour cette exécution, ce qui vous permet de vérifier notre travail sans payer une exécution.
Ce que nous avons mesuré
Un fournisseur de recherche peut être bon sur deux choses différentes, et elles ne vont pas toujours de pair :- Récupération : les résultats sont-ils pertinents, et contiennent-ils vraiment la réponse ?
- Réponses : quand vous transmettez ces résultats à un modèle, répond-il correctement ?
POST /augment/search une fois par fournisseur, avec limit fixé à 10. Ensuite, zai-org-glm-5-2 répond à partir des résultats de chaque fournisseur, et grok-4-7 note le tout à une température de 0. Le modèle répond aussi sans aucune recherche, comme référence.
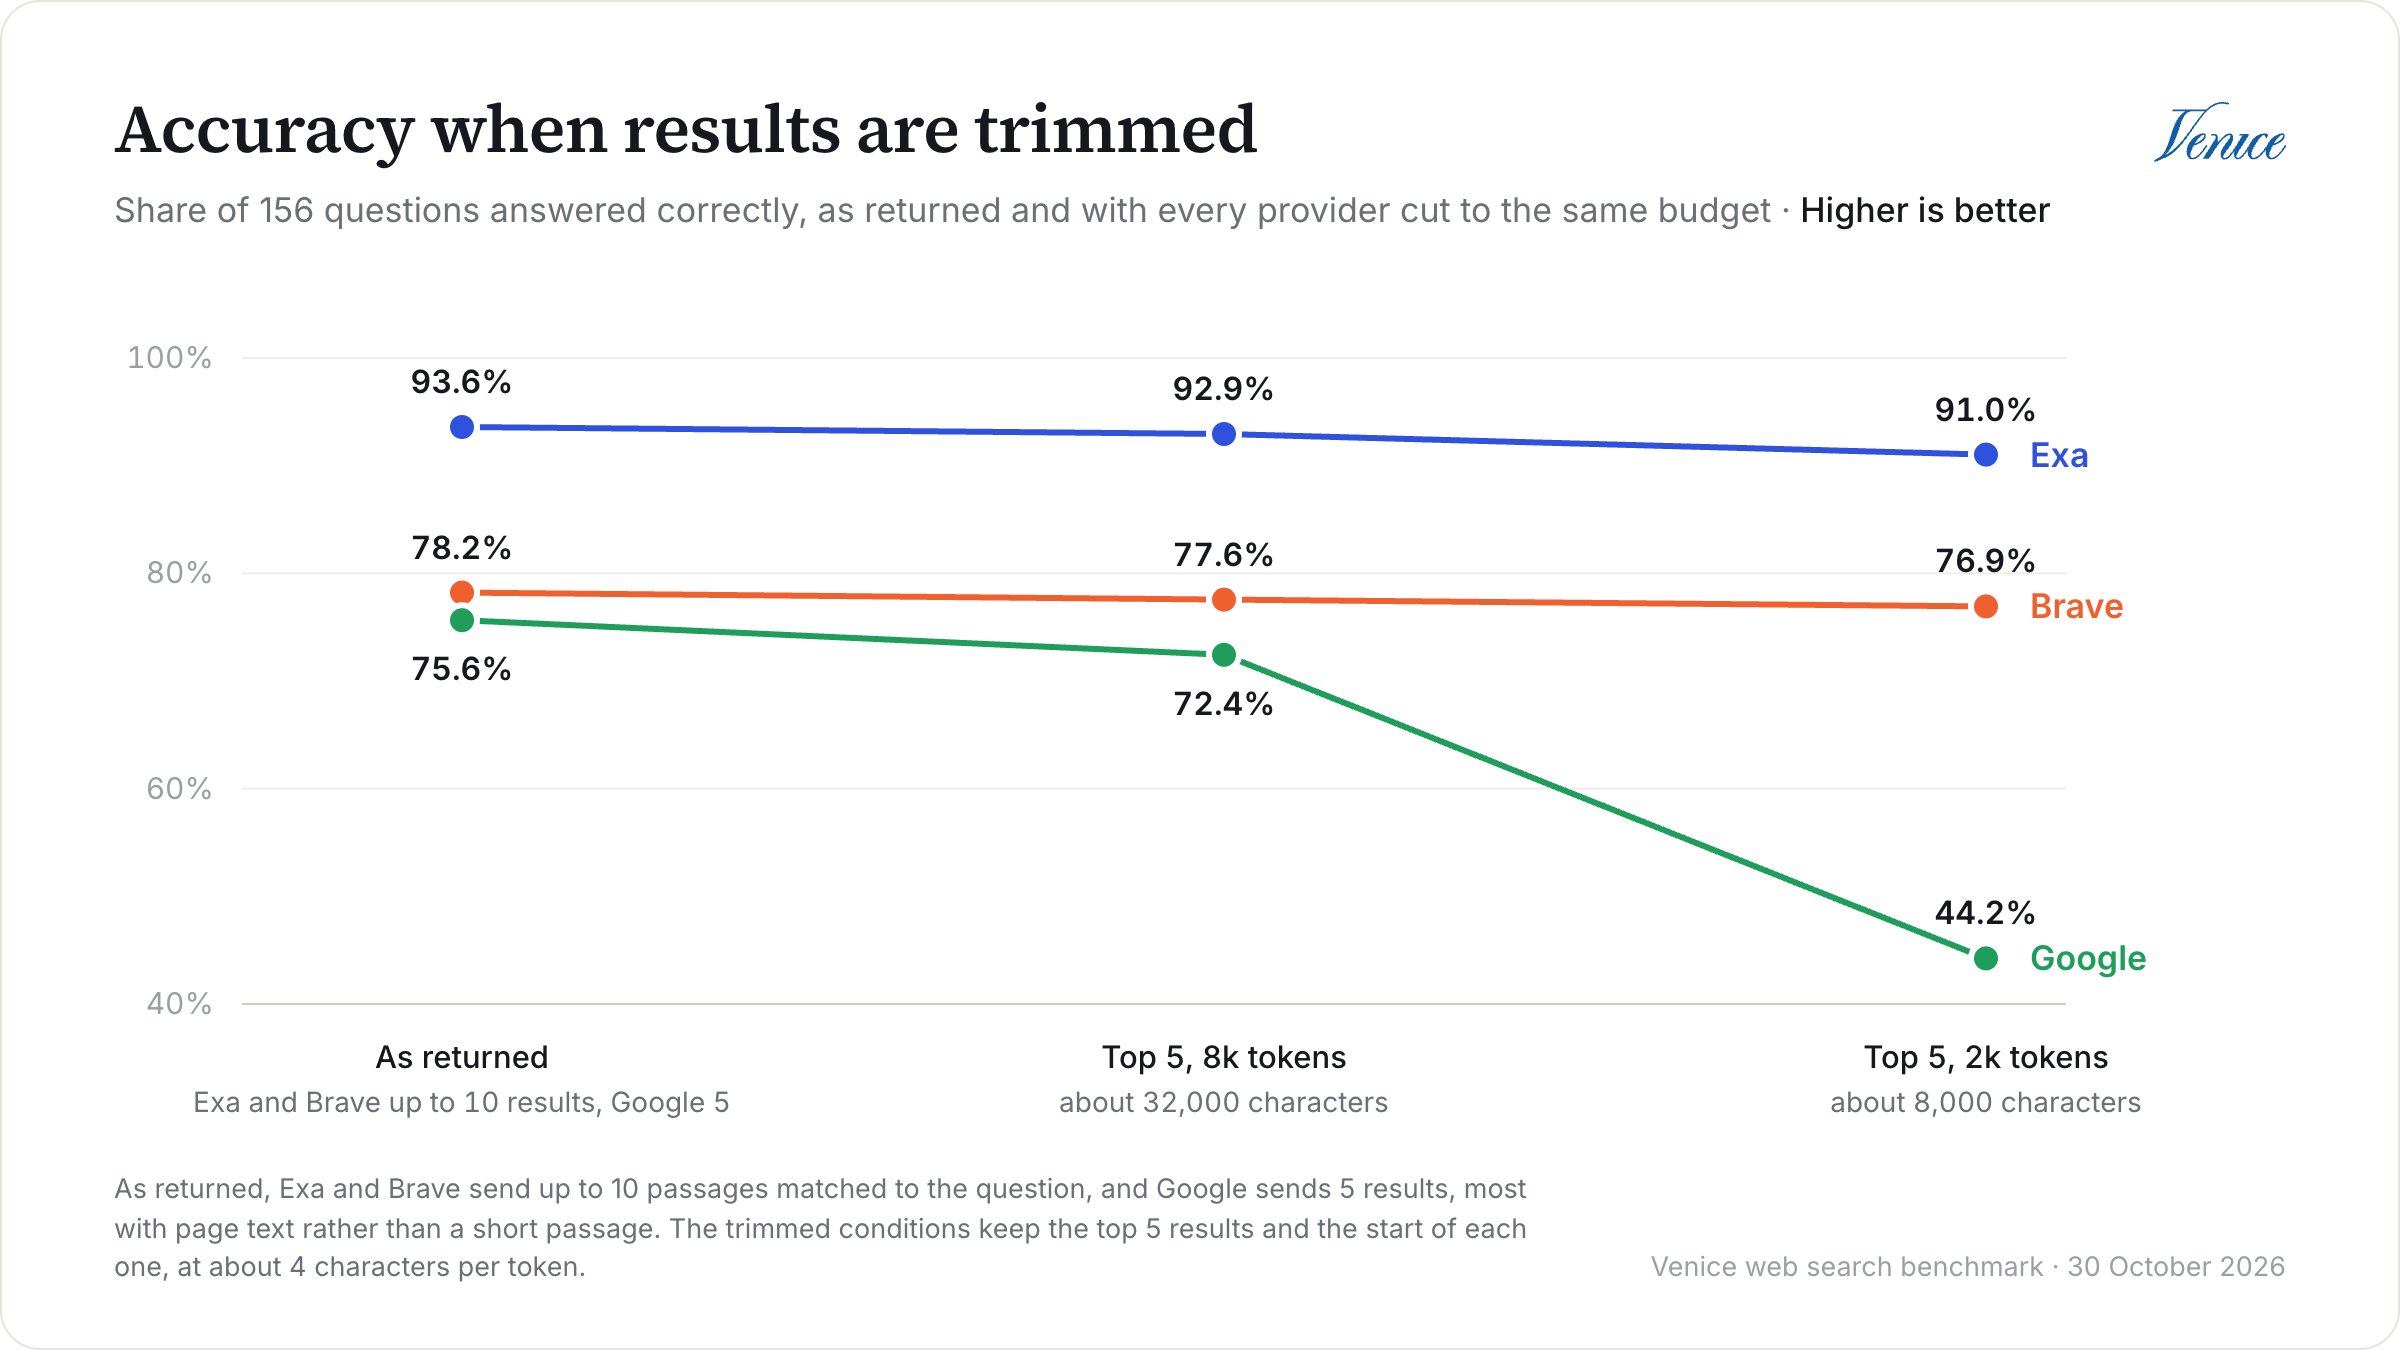
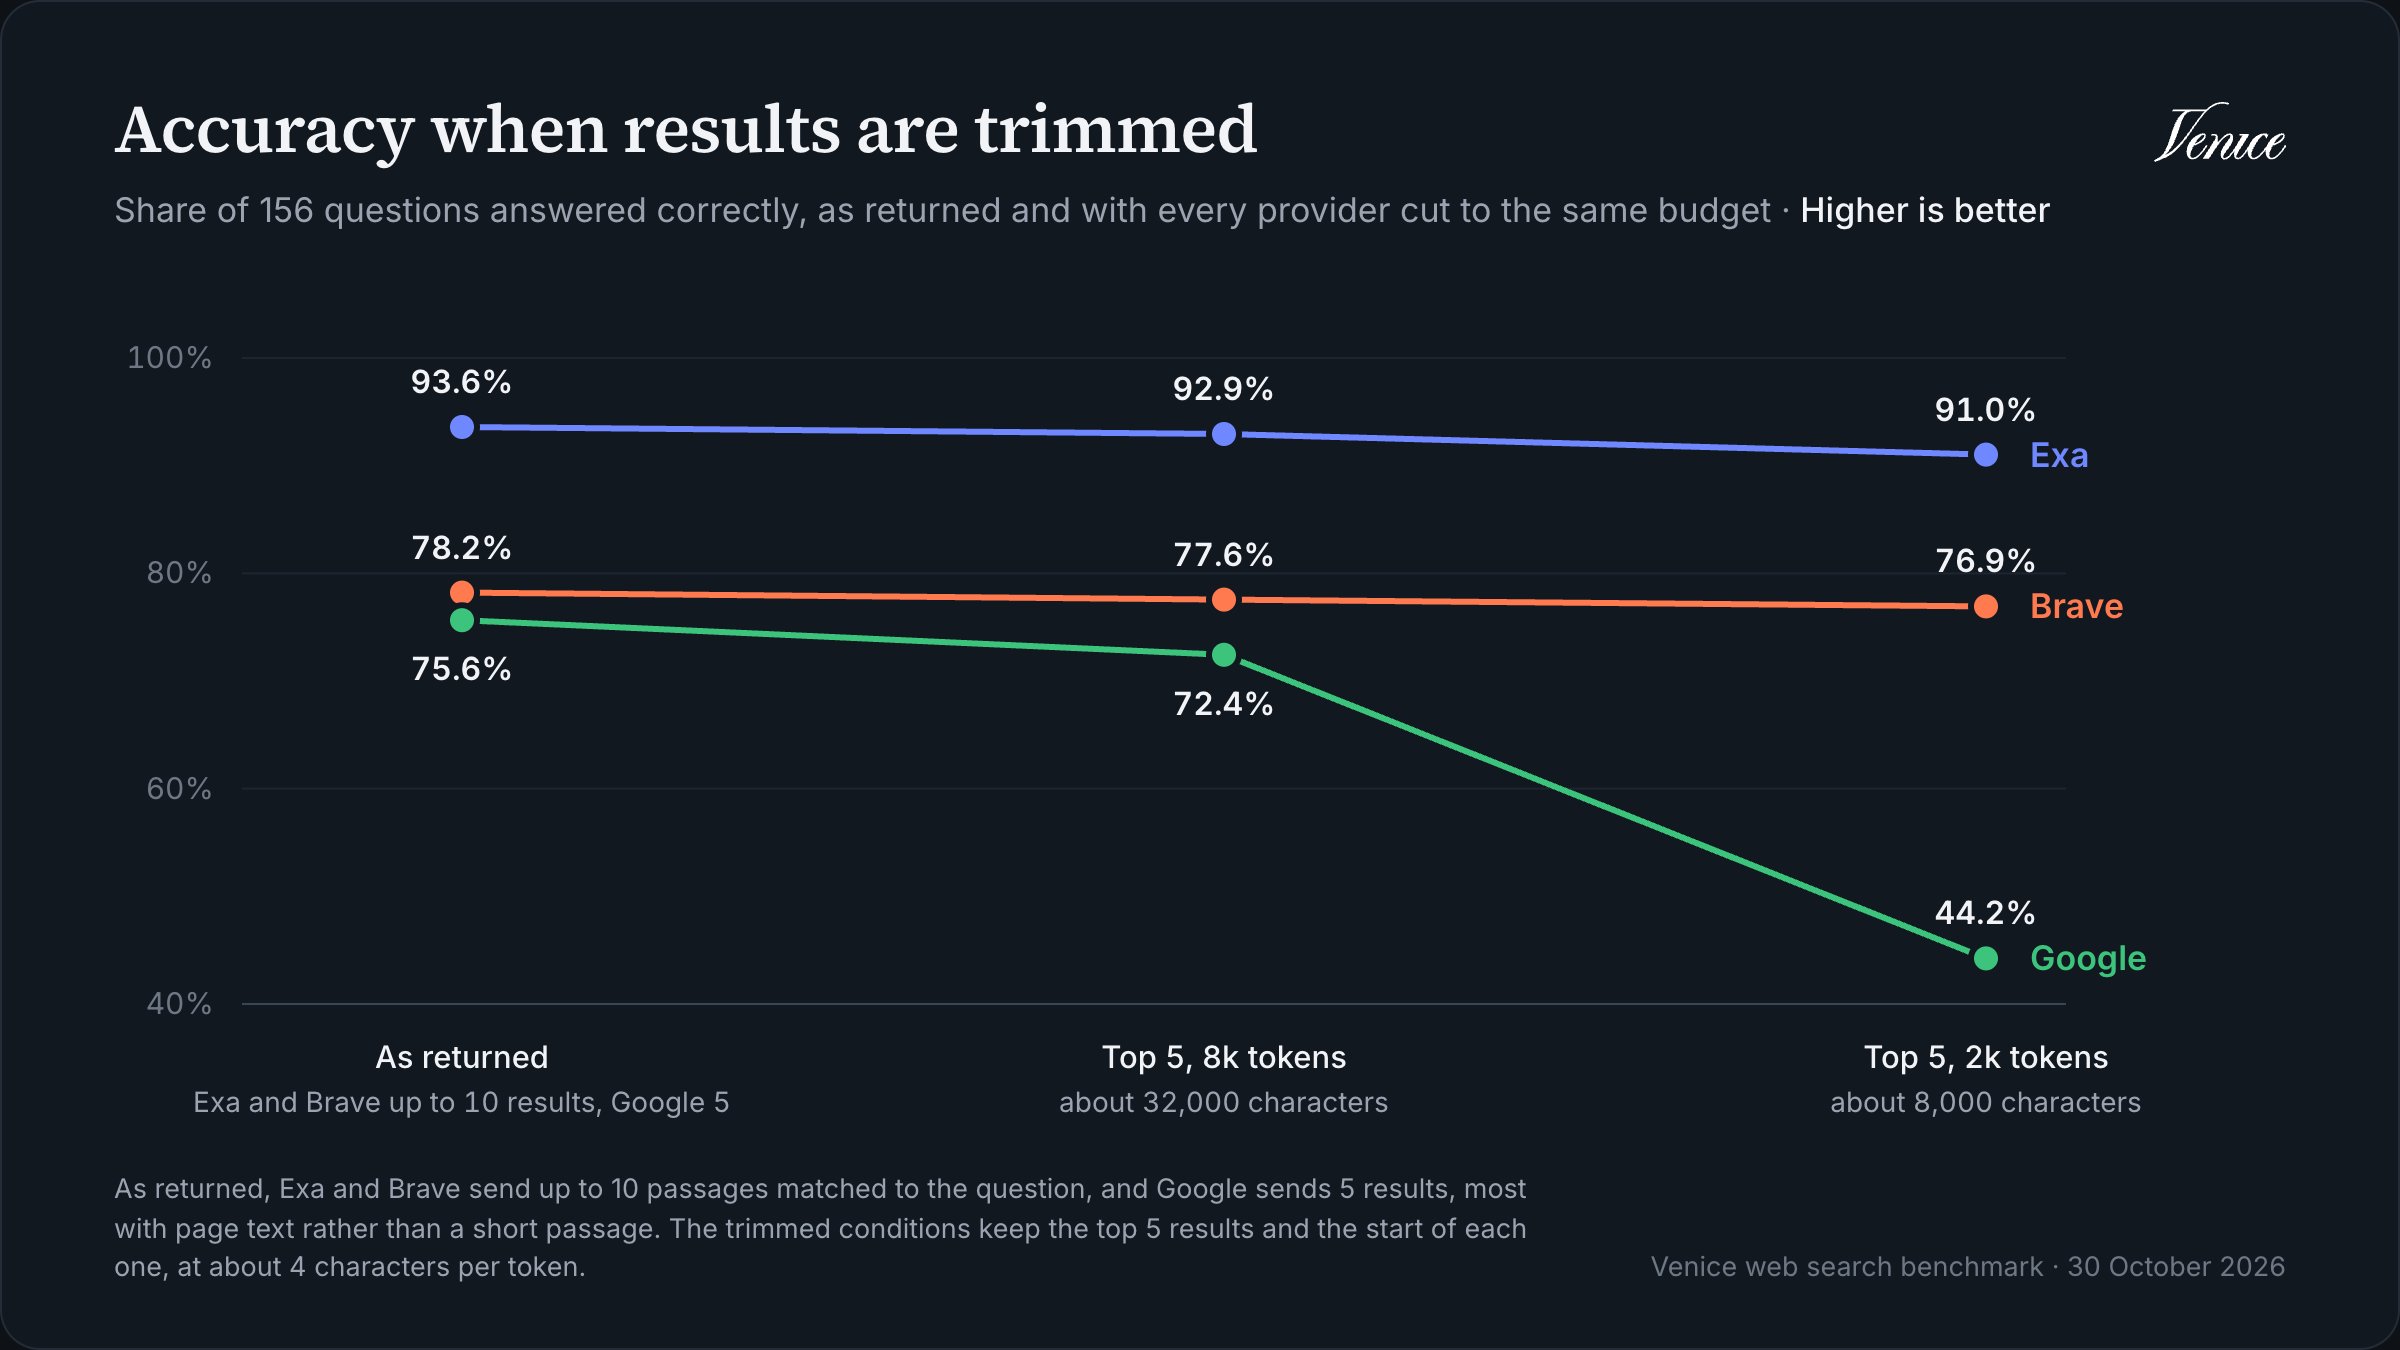
Notez que les fournisseurs ne renvoient pas la même quantité de texte, ni même le même type de texte. Dans notre exécution, Exa a renvoyé 10 résultats par recherche et Brave entre 7 et 10, composés de passages correspondant à la question, d’environ 1 500 à 1 700 caractères chacun. Google a renvoyé 5 résultats, ce que l’API de Venice renvoie pour google quelle que soit la valeur de limit. La plupart étaient le texte complet de la page, en partant du haut : navigation, bandeaux de cookies et tout le reste. Pas tous, cependant : quand un site bloque le scraping, comme Reddit, Facebook, Stack Overflow ou YouTube, le résultat se limite à l’extrait de recherche. Lors d’une nouvelle exécution le 11 novembre, un quart des 5 premiers résultats de Google contenaient moins de 300 caractères de texte. Cela représentait environ 9 700 caractères par résultat, soit 48 000 par recherche, contre environ 14 000 pour Brave et Exa. Plus de texte peut donner de meilleures réponses, mais cela signifie aussi plus de tokens d’entrée à chaque requête. Pour voir à quel point le volume compte, le modèle répond à partir des résultats de chaque fournisseur de trois façons :
Dans les deux conditions avec budget, chaque fournisseur reçoit le même nombre de résultats et la même place. Comme le harness conserve le début de chaque résultat, elles testent aussi la façon dont les résultats de chaque fournisseur résistent à la troncature, ce que font beaucoup de pipelines réels.
Les questions
La première version de ce benchmark avait un problème : sans recherche, le modèle répondait déjà à 72 % des questions que nous pouvions noter, donc les trois fournisseurs semblaient à peu près équivalents. Si le modèle connaît déjà la réponse, la recherche ne peut pas changer grand-chose, et elle ne peut pas non plus vous dire quel fournisseur est le meilleur. Pour cette exécution, nous avons donc réuni 156 questions avec des réponses de référence, dont la réponse doit venir d’une recherche :
Les questions de code prennent plusieurs formes, des messages d’erreur collés aux questions liées à une version comme “Which ripgrep version started respecting the GIT_CONFIG_GLOBAL environment variable?”. C’est volontaire : un moteur de recherche excellent en langage naturel peut quand même échouer sur une chaîne d’erreur. Il y a aussi 6 questions générales sans réponse de référence, comme de longues questions conversationnelles, sur lesquelles nous reviendrons.
Chaque question avec réponse de référence a subi les mêmes vérifications avant d’être retenue. Nous avons rédigé chacune avec des agents IA à partir d’une source primaire, comme une note de version ou un communiqué de presse officiel, et un script a récupéré chaque source pour confirmer que la citation à l’origine de la réponse de référence figurait bien sur la page. Ensuite, le modèle a répondu à chaque question deux fois sans recherche, et nous avons écarté toute question à laquelle il a bien répondu l’une ou l’autre fois.
Pour les questions d’actualité et sur les sujets sensibles, nous avons aussi donné au modèle les citations de la source comme résultats de recherche, et nous n’avons gardé une question que s’il y répondait correctement les deux fois. Cela repère les questions ambiguës et vérifie que le modèle répond à une question sensible quand il dispose de la source. Enfin, un autre agent a revérifié chaque question et réponse de référence par rapport aux sources, ce qui a entraîné 47 modifications et 3 abandons supplémentaires, et chaque question modifiée est repassée par le filtre sans recherche.
Notez que cela rend la référence sans recherche proche de zéro par construction, donc elle ne vous dit pas à quelle fréquence la recherche aide en général. Ce qu’elle vous dit, c’est que chaque question de l’ensemble nécessite une recherche, ce qui est exactement ce que nous voulons pour comparer des fournisseurs de recherche.
Les métriques
La précision est accompagnée d’un intervalle de confiance à 95 %, et les écarts entre fournisseurs proviennent de comparaisons appariées sur les mêmes questions : un intervalle bootstrap et un test exact de McNemar. Avec 156 réponses de référence, chaque question vaut environ 0,6 point de pourcentage, et les intervalles de précision atteignent environ ±7 points, donc mieux vaut consulter les comparaisons appariées avant de tirer des conclusions d’un petit écart.
Résultats
Exa a répondu correctement au plus grand nombre de questions
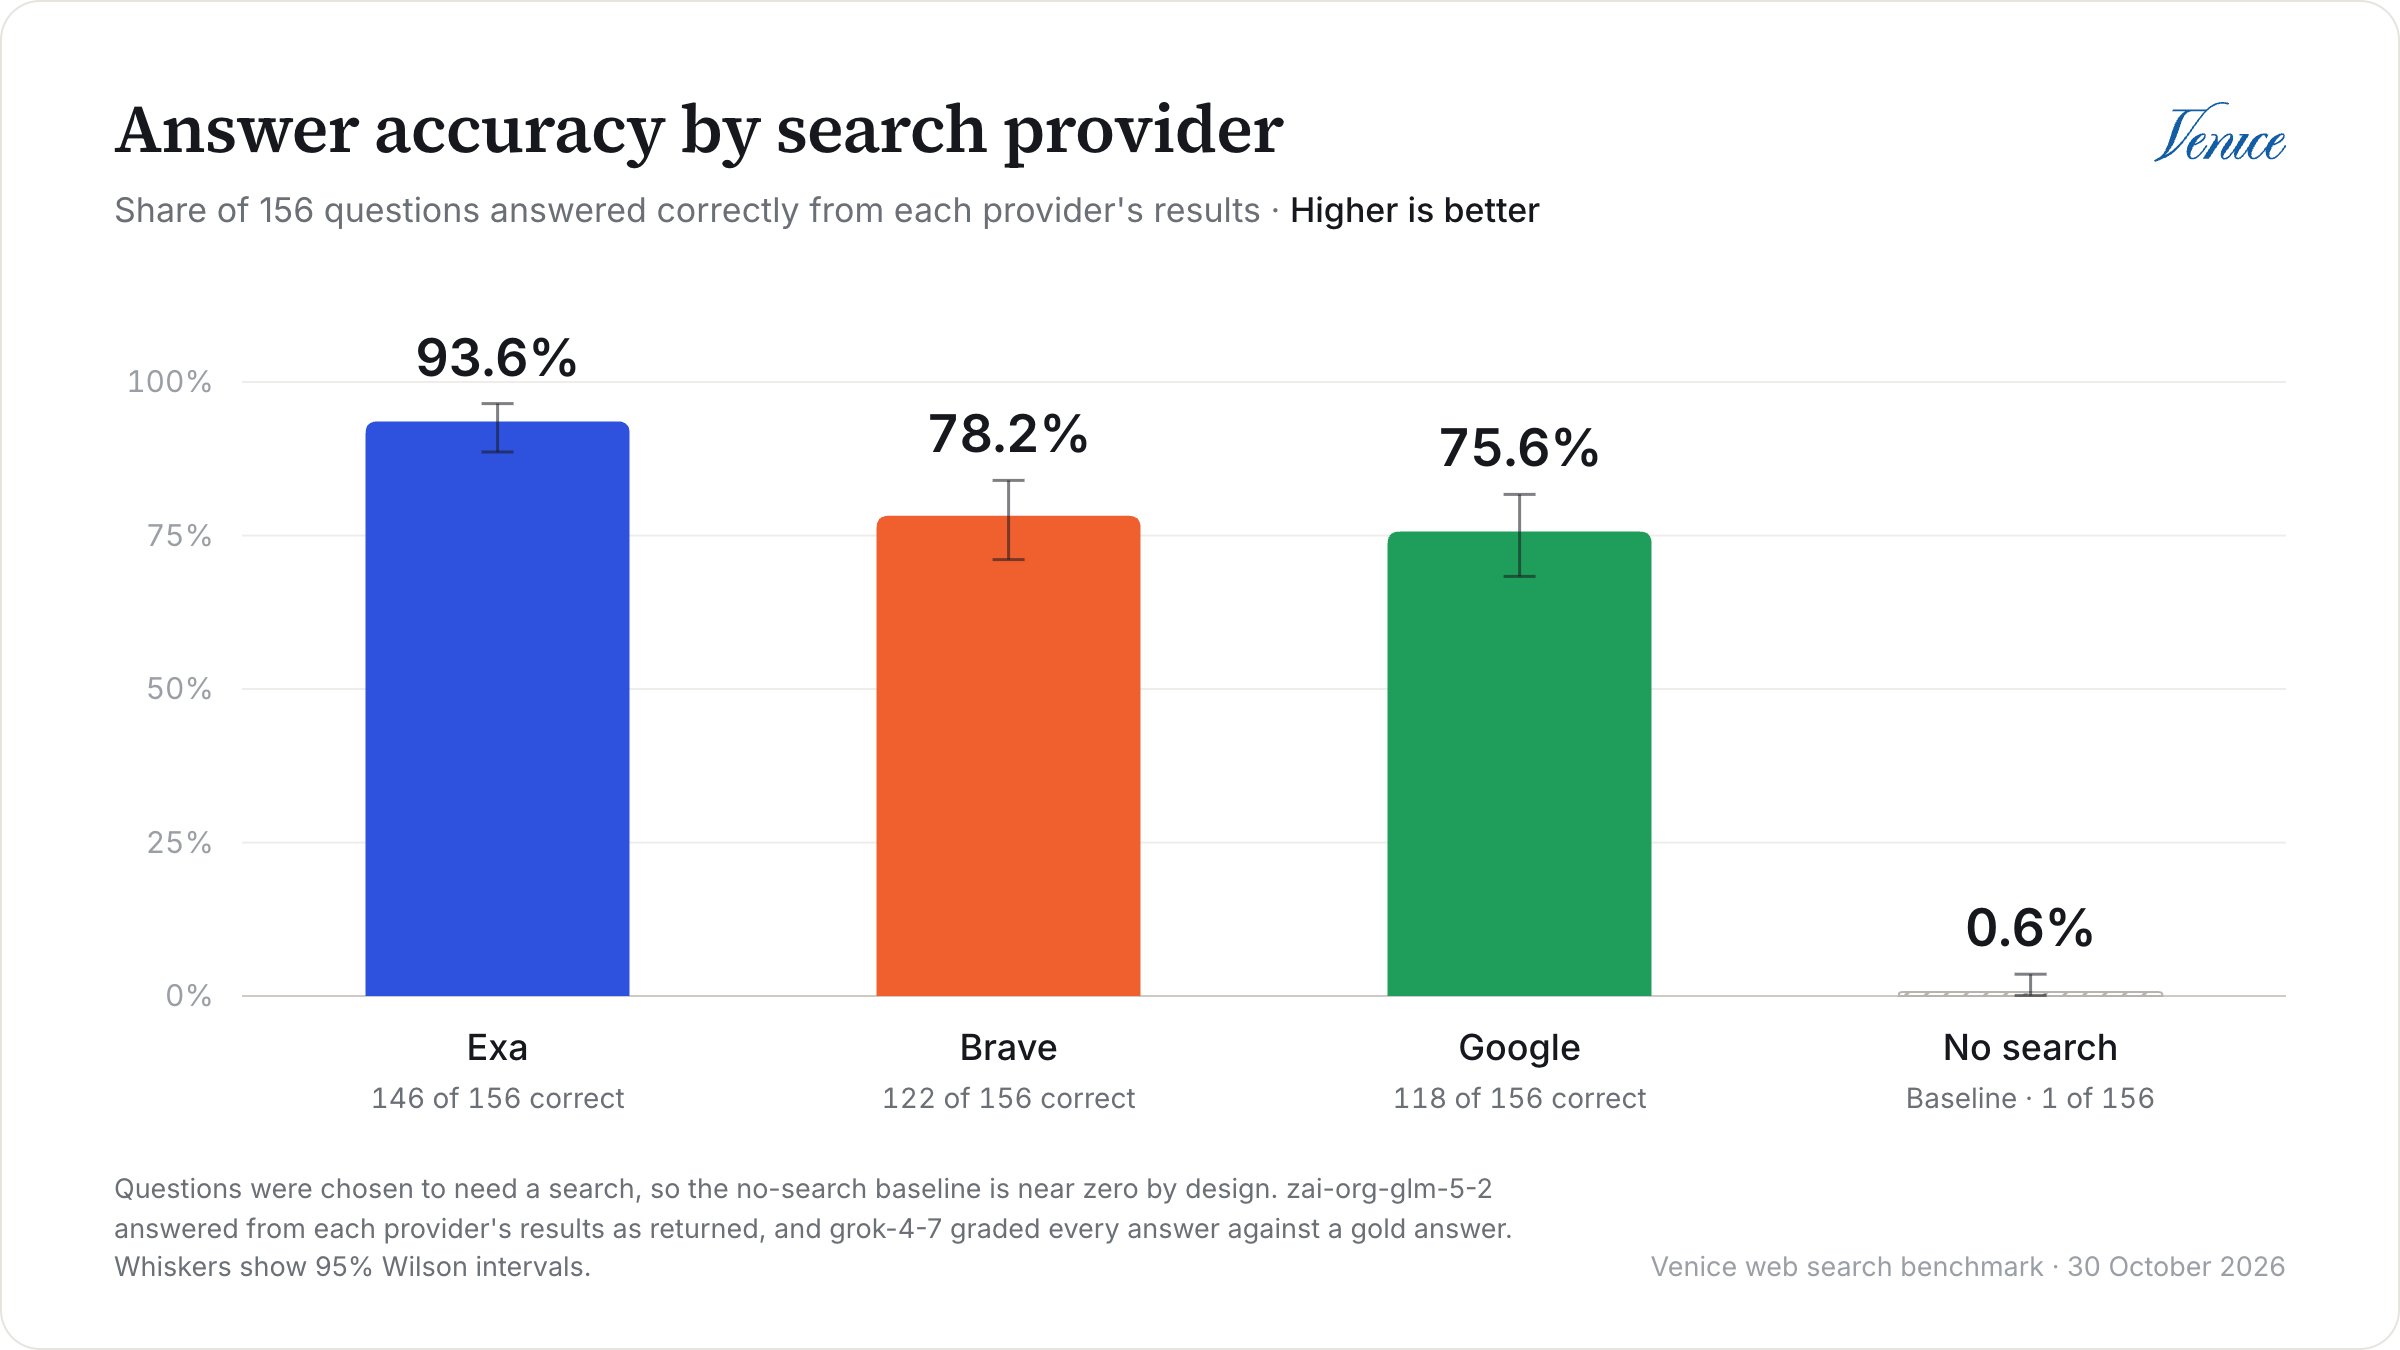
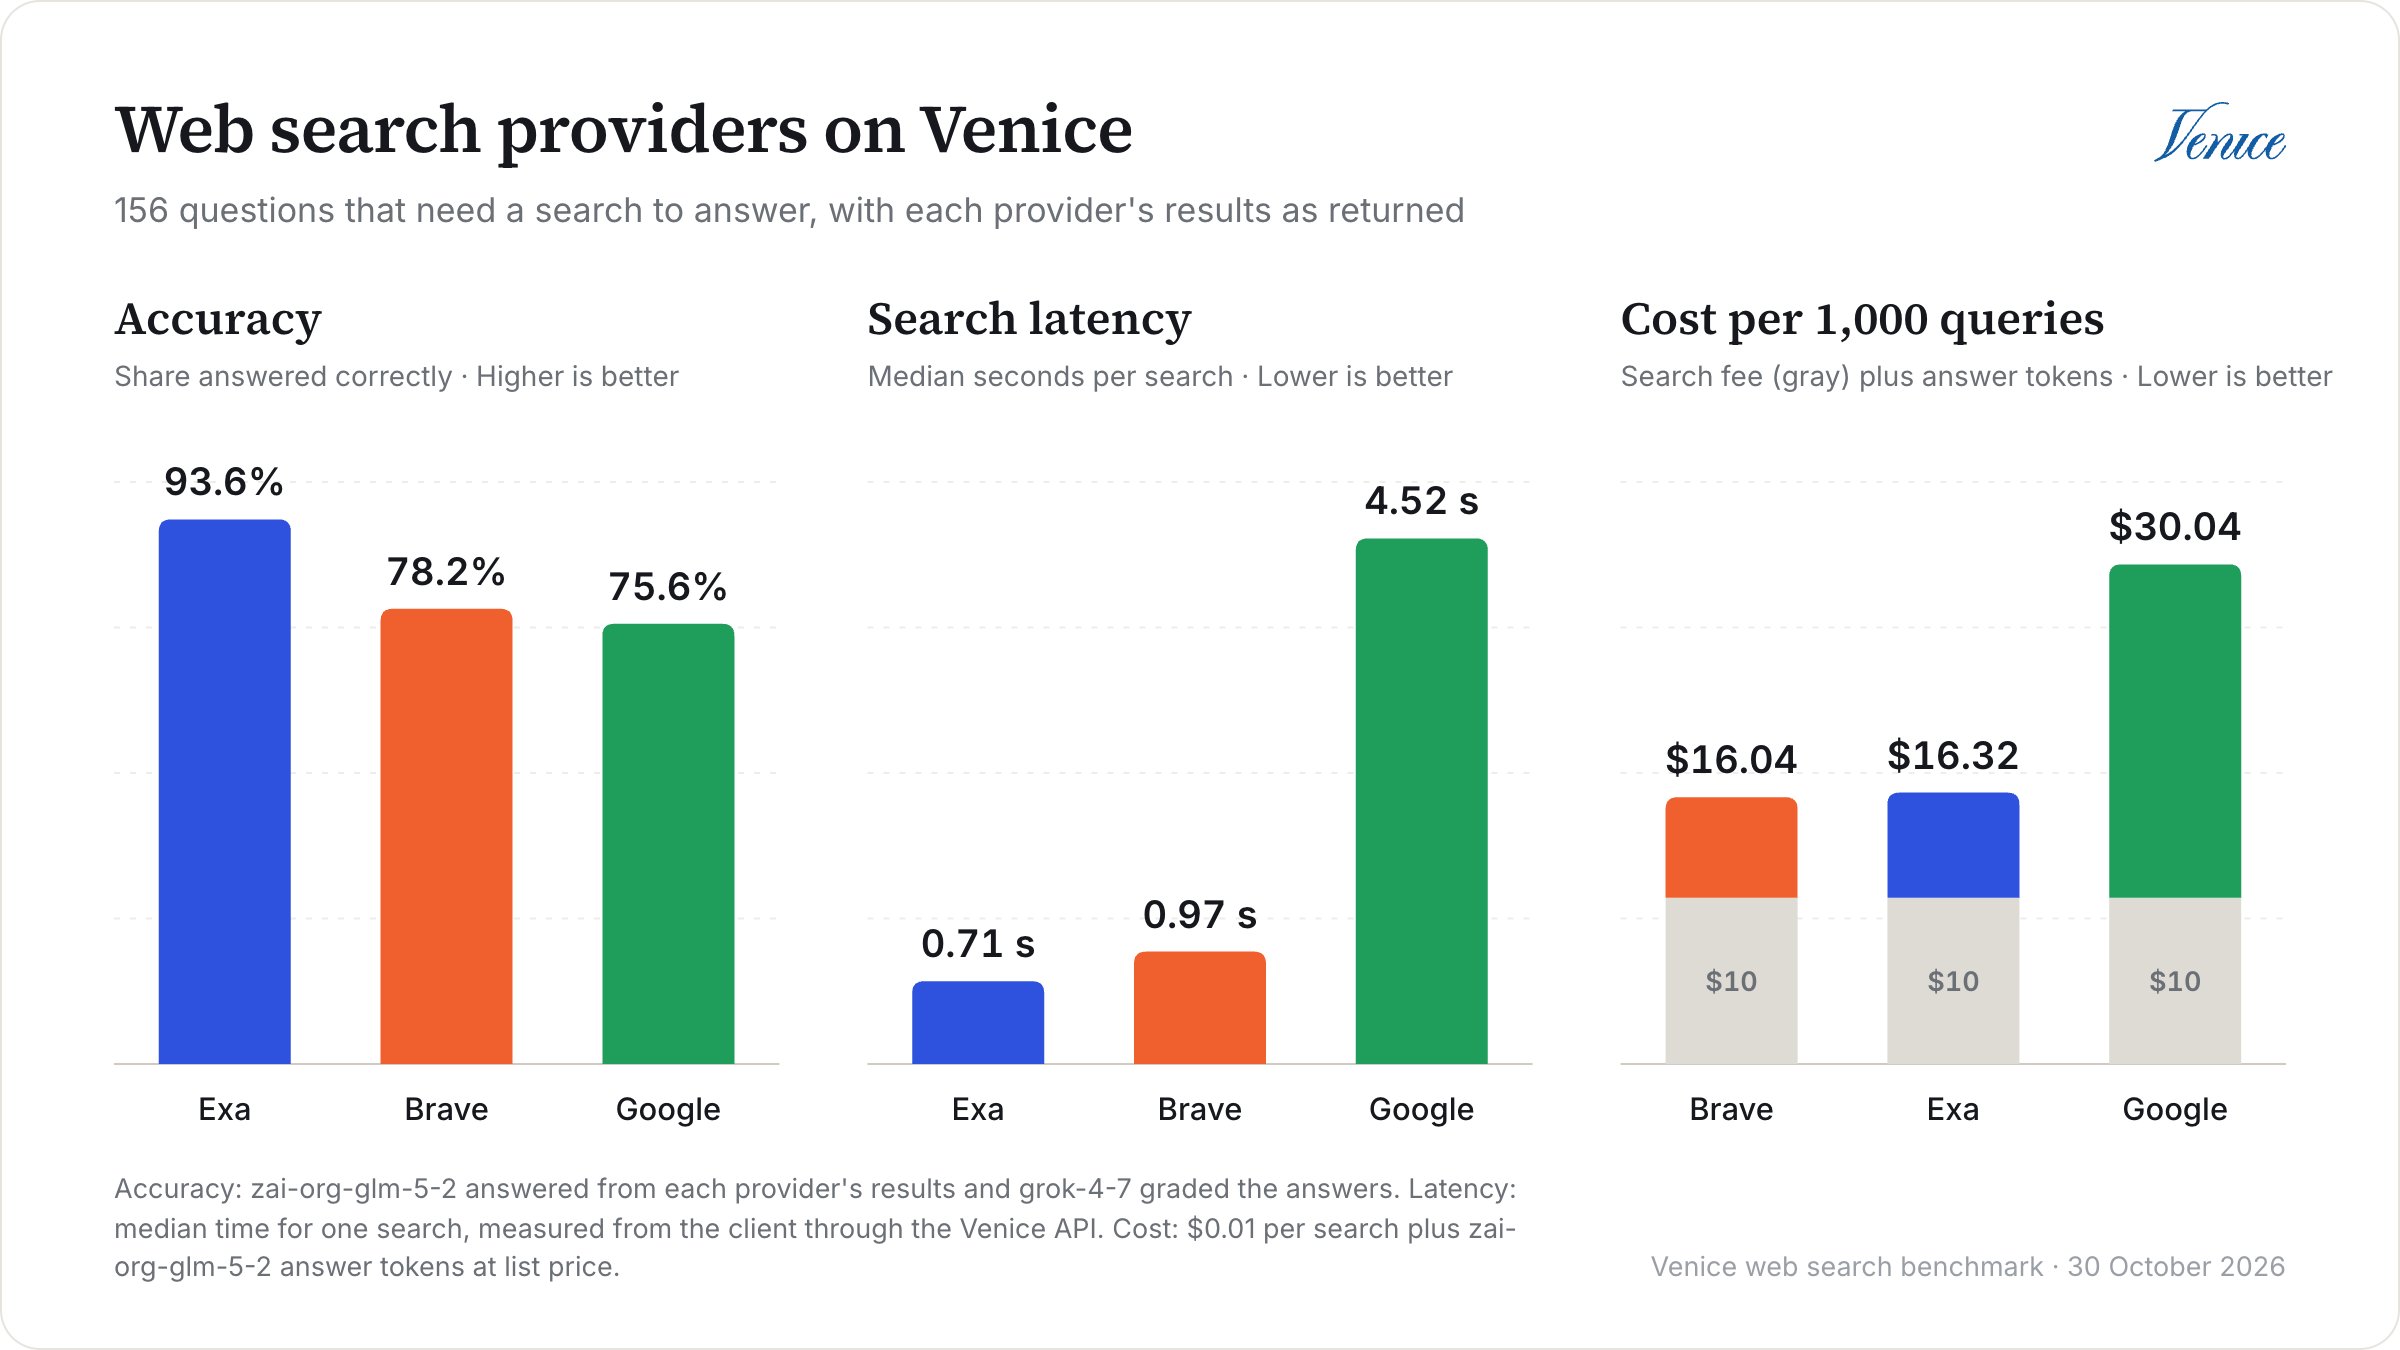
Avec tous les résultats tels que renvoyés, Exa a répondu correctement à 93,6 % des questions, soit environ 15 points de plus que Brave et 18 de plus que Google. Cette fois, l’écart est net : Exa a bien répondu à 28 questions que Brave a manquées, contre seulement 4 dans l’autre sens, et à 33 que Google a manquées, contre 5 (McNemar p < 0.001 dans les deux cas).
Pour vérifier que ce n’était pas un hasard, nous avons relancé le benchmark complet le 11 novembre avec les mêmes paramètres, et ses résultats sont aussi dans le dépôt. Exa est de nouveau arrivé en tête, à 93,6 % contre 81,4 % pour Brave et 72,4 % pour Google, et devançait Brave de 12,2 points (24 questions contre 5, p = 0.001).
Brave face à Google est moins tranché. Dans cette exécution, ils étaient à égalité, à 22 questions contre 18, ce qui reste largement dans le bruit. Lors de la nouvelle exécution, Brave a pris l’avantage, à 29 questions contre 15 (9,0 points, p = 0.049). Brave était donc à égalité avec Google ou devant lui, selon l’exécution.
Nous voulions aussi savoir si l’avance d’Exa venait de la formulation des questions, puisque nous les avons recherchées telles quelles, alors que les applications réelles les réécrivent généralement d’abord en requêtes de recherche. Lors d’une autre exécution, le 10 novembre, nous avons donc demandé au modèle de réécrire chaque question une fois en requête de moteur de recherche, envoyé cette même requête aux trois fournisseurs, et noté les réponses à la question d’origine. Exa devançait toujours Brave de 13,5 points (24 questions contre 3), et aucun score ne changeait significativement, donc la formulation n’explique pas l’avance d’Exa.
Les réponses sans recherche valent aussi le coup d’œil. Sans recherche, le modèle nous a dit de lire un en-tête
Retry-After après une 429 au lieu de x-ratelimit-reset-requests de Venice, a inventé un suffixe -web-search pour activer la recherche web via le nom du modèle, et a cité un fournisseur de recherche venice qui n’existe pas. Si vos utilisateurs posent des questions sur des API récentes ou de niche, les connaissances propres du modèle ne suffiront pas.
C’est dans les conditions avec budget que Google décroche. À 2 000 tokens, sa précision est tombée à 44,2 %, et le modèle n’a pas trouvé de réponse pour 30 % des questions, contre 10 % avec les résultats complets de Google. Comme les résultats de Google commencent en haut de la page, les tronquer a conservé la navigation et les bandeaux et supprimé la partie qui répondait à la question. Les résultats de Brave et d’Exa sont déjà des passages correspondant à la question, donc les tronquer n’a presque rien changé. À 8 000 tokens, Google a regagné l’essentiel du terrain, à 72,4 %.
D’où vient l’avance d’Exa
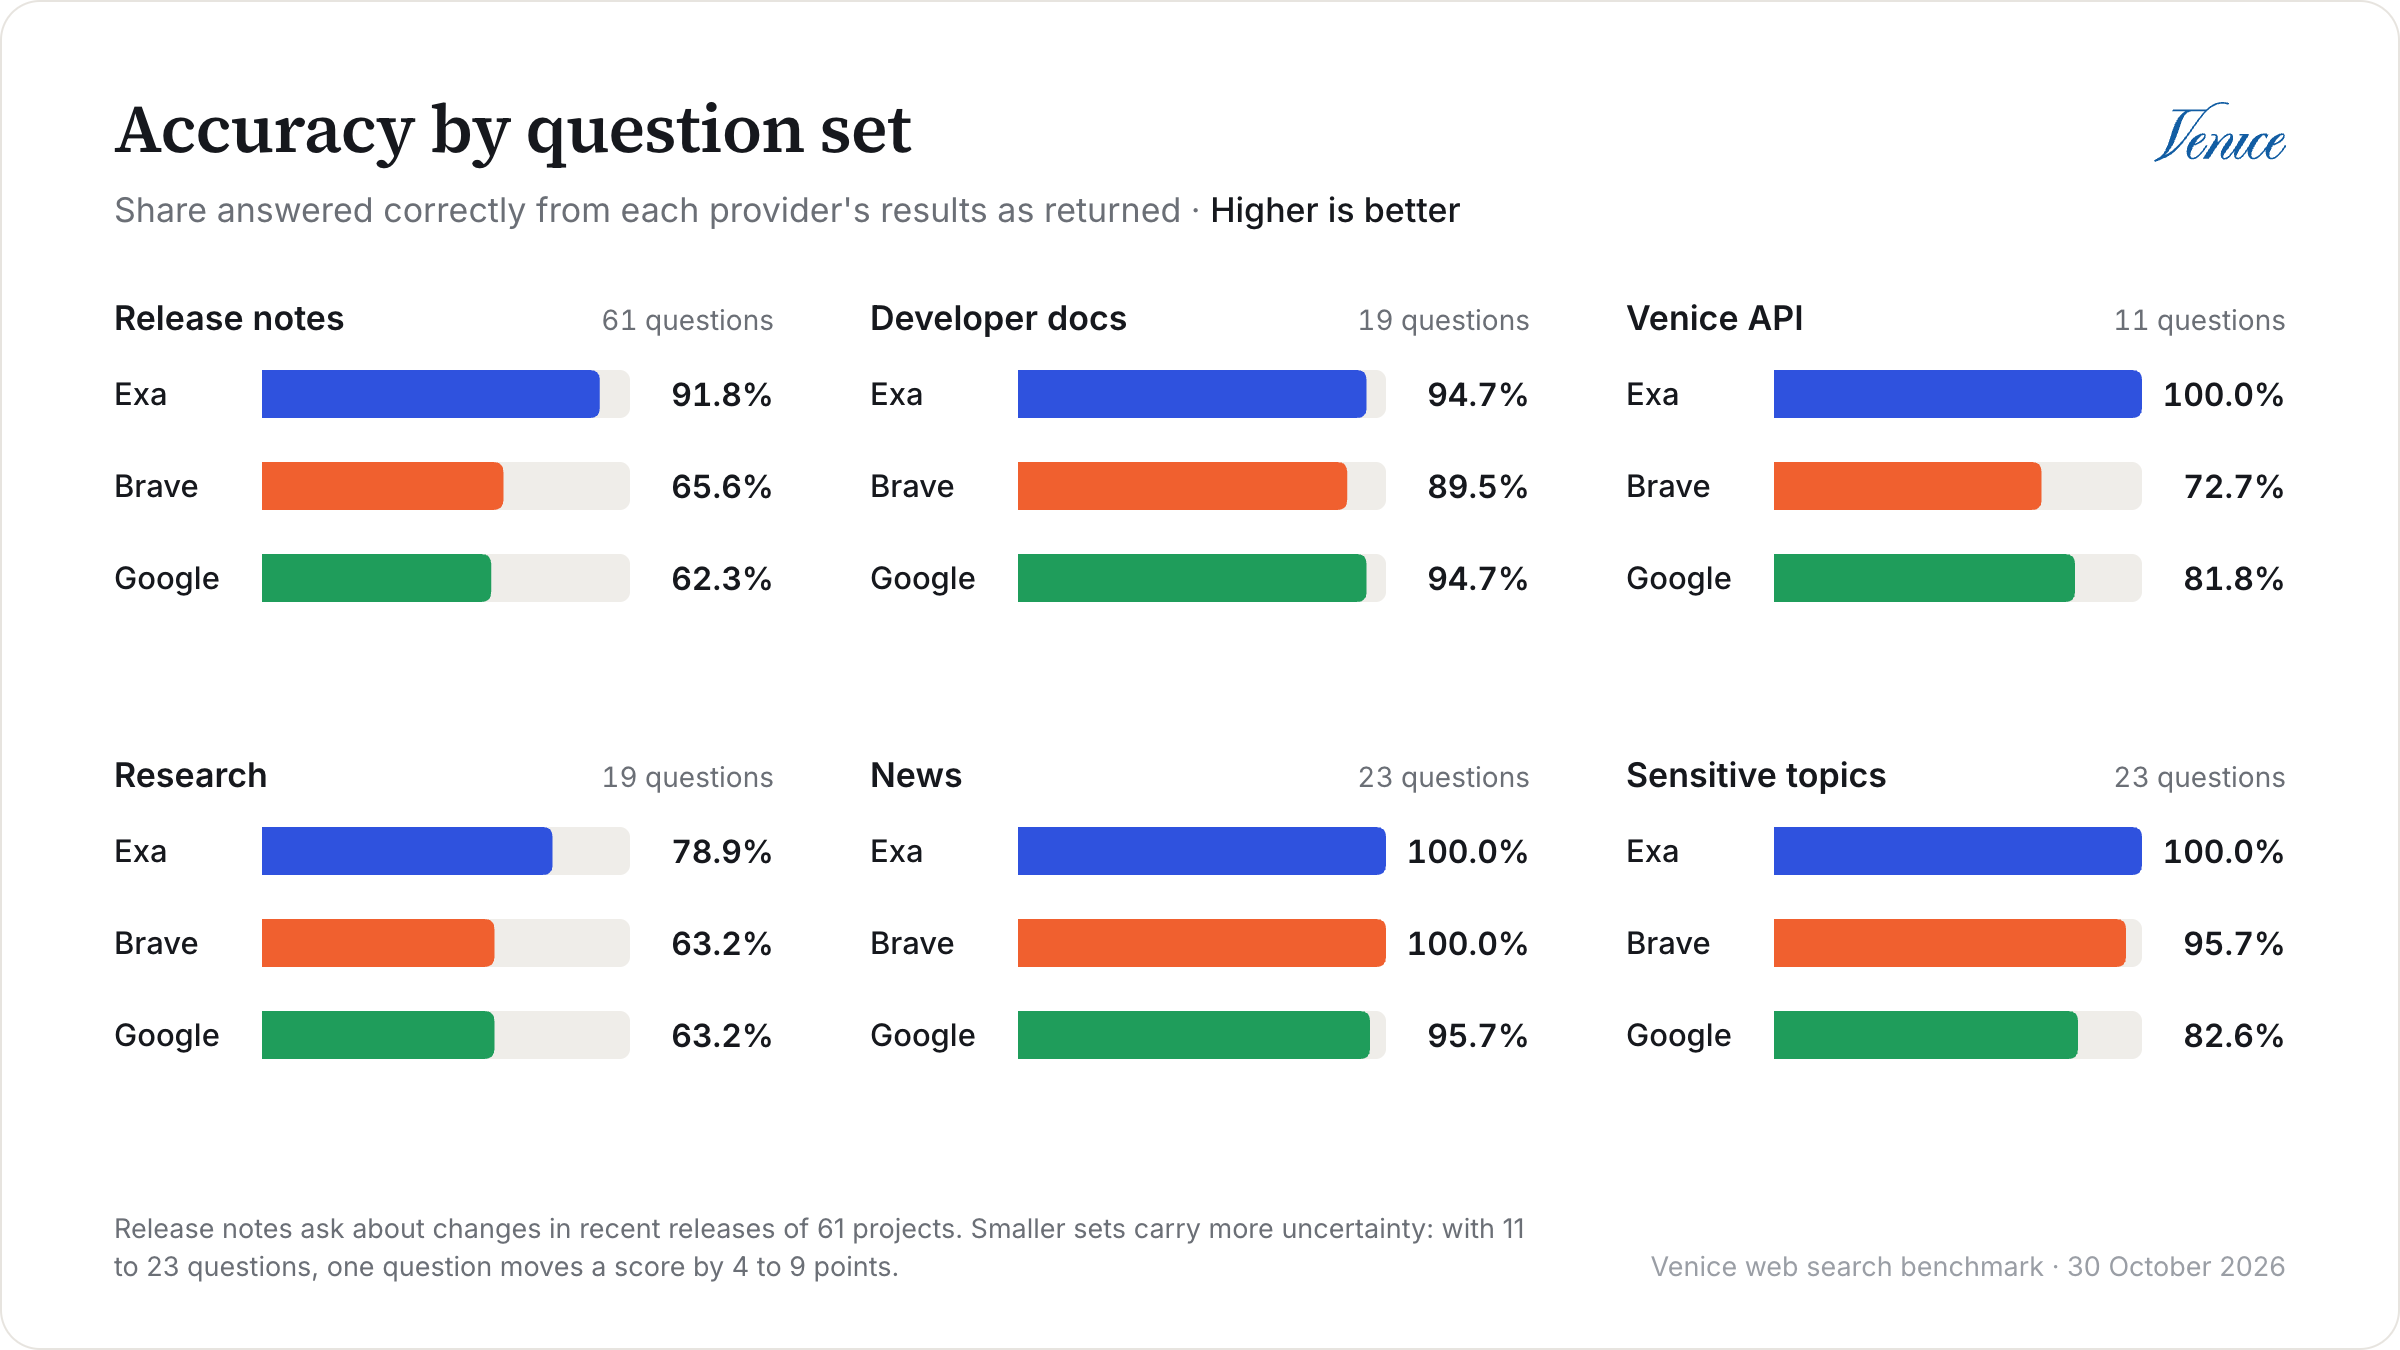
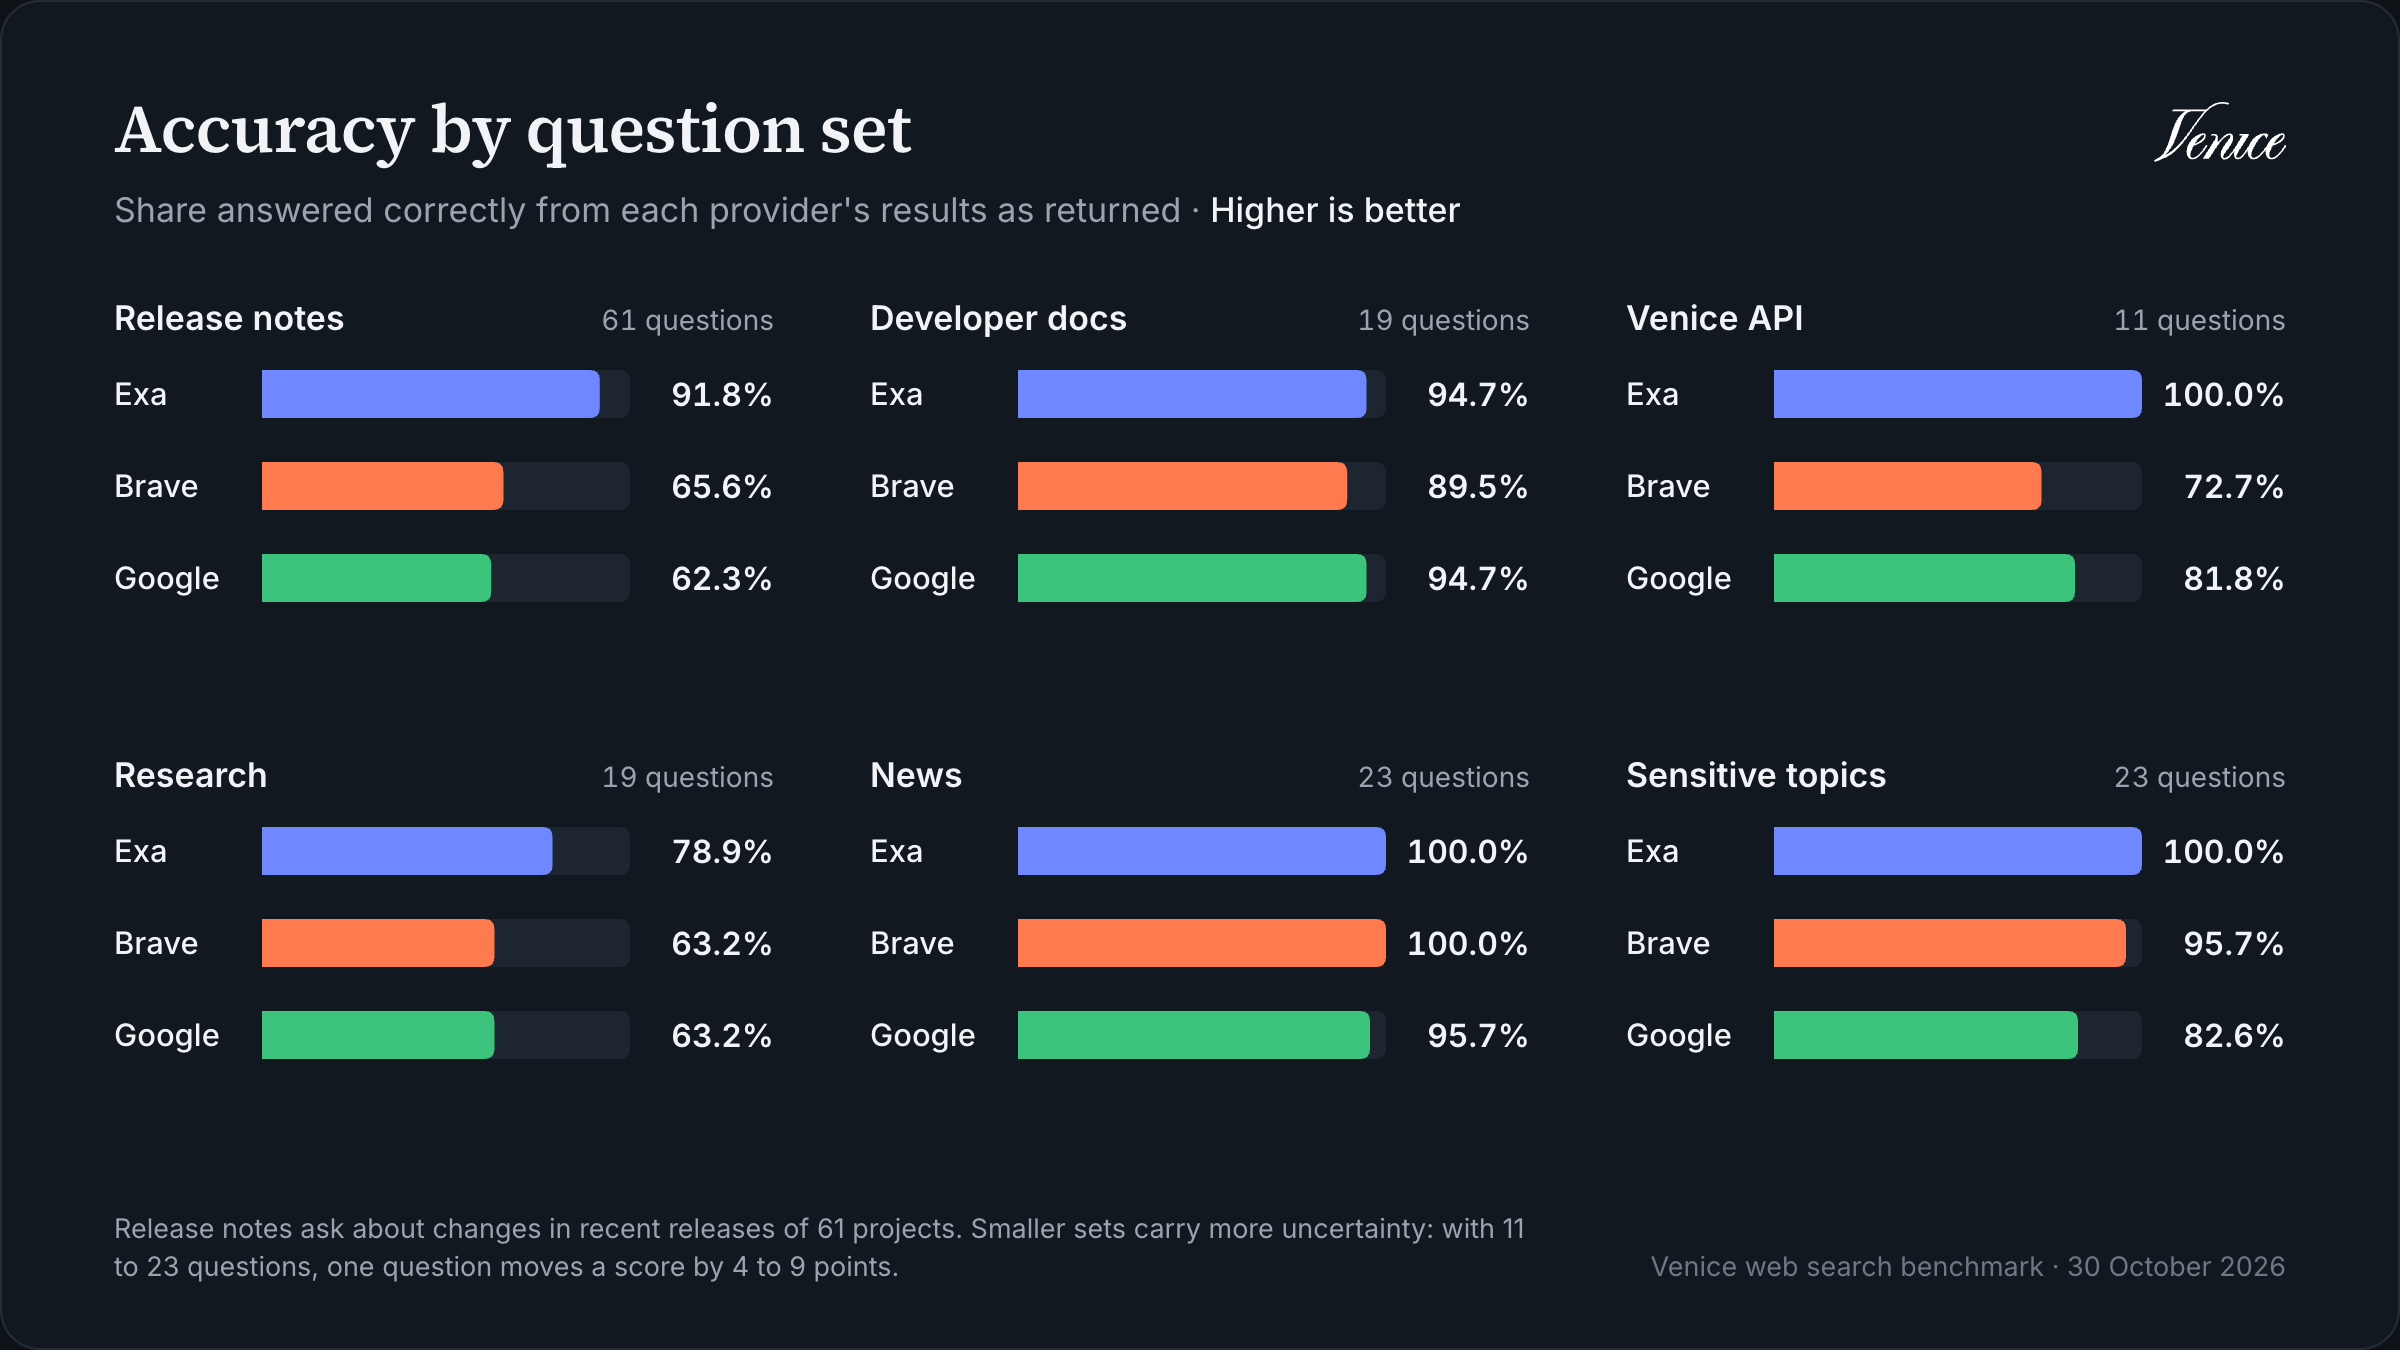
L’essentiel de l’écart vient d’un seul endroit : les notes de version. Exa a répondu correctement à 56 des 61 questions de version, contre 40 pour Brave et 38 pour Google. La réponse se trouve généralement sur une seule ligne d’un changelog, et les résultats d’Exa avaient bien plus de chances de l’inclure. Sur les questions de version portant sur un identifiant connu, comme un flag ou une variable d’environnement, les résultats d’Exa en contenaient 97 % mot pour mot, contre 76 % pour Brave et 68 % pour Google. Sur les questions liées à une version dans tous les ensembles de code, Exa a eu 95 % de bonnes réponses et les deux autres 55 %.
Les questions de recherche ont été les plus difficiles pour tout le monde, puisqu’elles nécessitent deux faits provenant de deux pages différentes, et même Exa n’a répondu correctement qu’à 15 sur 19. Sur l’actualité et la documentation développeur, en revanche, les trois fournisseurs ont répondu à presque tout. Si les questions de vos utilisateurs ressemblent à celles-là, le choix du fournisseur compte beaucoup moins.
Et les sujets sensibles ?
Certains services de recherche filtrent ou enterrent les résultats sur les sujets sensibles, alors nous avons ajouté 23 questions pour vérifier si l’un des trois fournisseurs le faisait. Elles couvrent des sujets comme la législation sur les drogues, l’avortement, le travail du sexe, les armes à feu, la surveillance et les coupures d’internet, et chacune a une réponse factuelle issue d’une source officielle, comme une décision de justice ou un avis gouvernemental. Aucun fournisseur n’a renvoyé de résultat vide ni d’erreur sur l’une d’elles, et le modèle n’a jamais refusé de répondre en raison du sujet. Exa a répondu correctement aux 23, Brave à 22 et Google à 19. Les échecs étaient des échecs de recherche ordinaires, où les résultats ne contenaient pas le fait ou donnaient une autre date, à l’exception d’une réponse de Google qui hésitait mais donnait la bonne date, et sur laquelle le juge a été trop sévère. Notez que 23 questions peuvent seulement montrer que nous n’avons constaté aucun filtrage, pas qu’il n’en existe nulle part.Exa a renvoyé le texte le plus utile
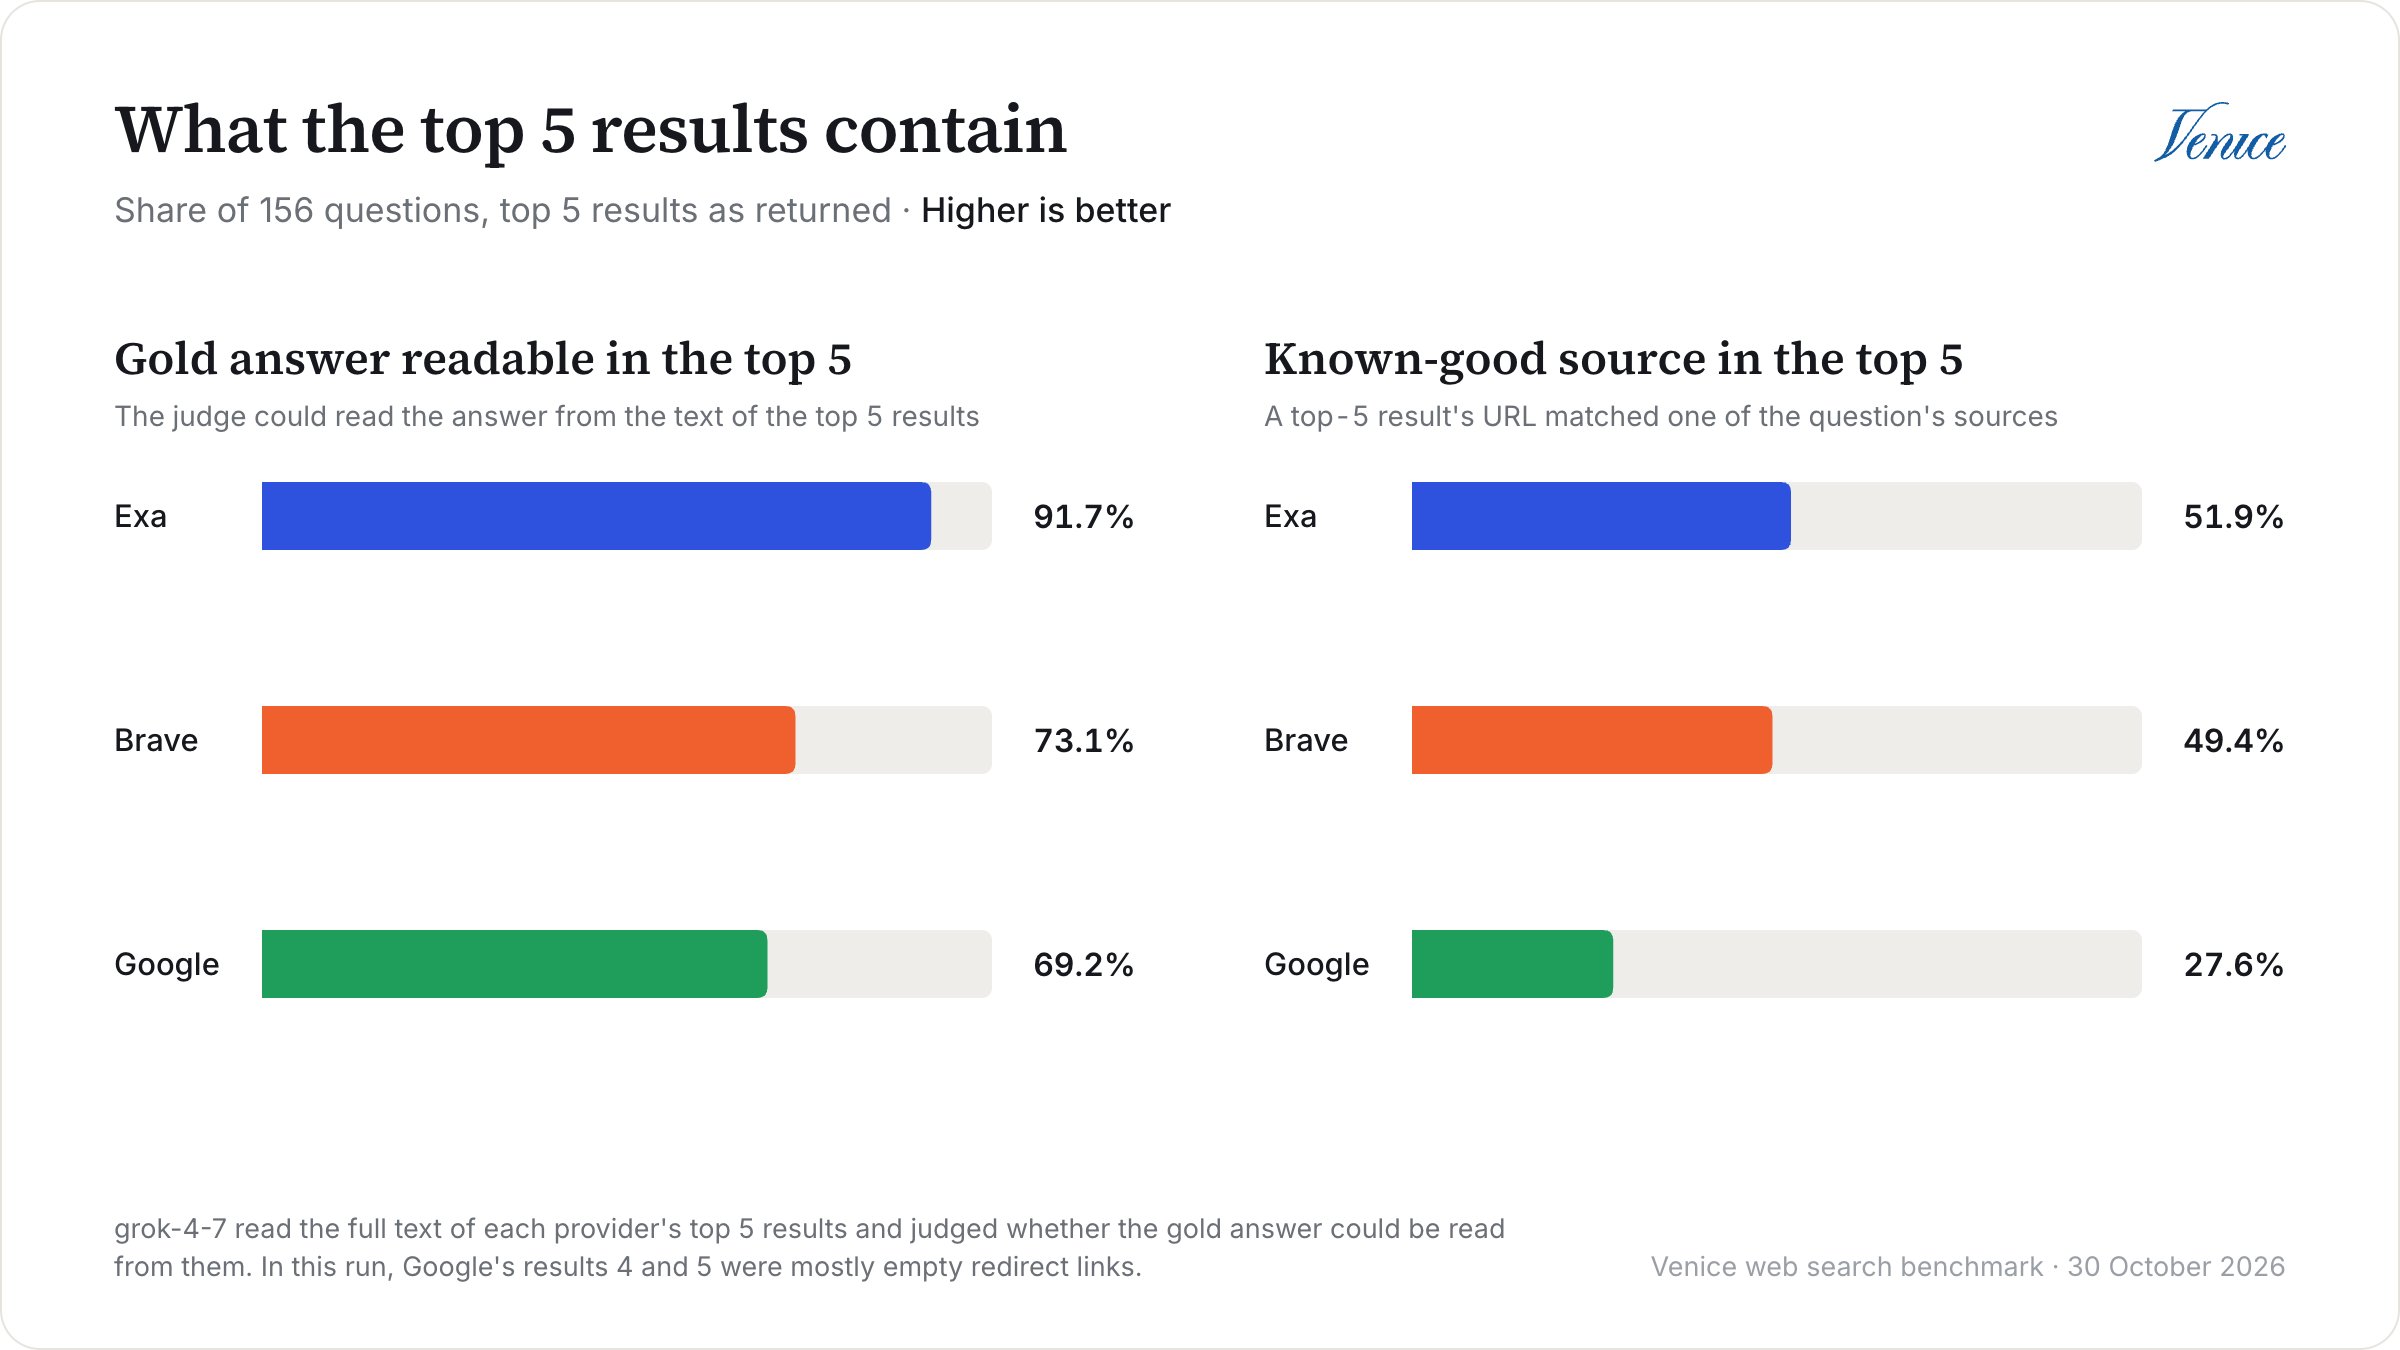
Les résultats d’Exa étaient aussi les plus pertinents. Son nDCG@5 était supérieur de 0,15 à celui de Brave (IC à 95 % : 0,11 à 0,19) et de 0,32 à celui de Google (IC à 95 % : 0,28 à 0,36), et Brave devançait Google de 0,17.
Les chiffres de Google intègrent toutefois ici un problème corrigé depuis. Dans cette exécution, les résultats 4 et 5 de Google étaient des liens de redirection
google.com/goto?url=… dans 144 des 162 recherches, et la plupart ne contenaient presque pas de texte, donc environ un tiers des 5 premiers résultats de Google étaient quasiment vides. Ils avaient disparu lors de la nouvelle exécution du 11 novembre, où le nDCG@5 de Google est passé de 0,43 à 0,47 et son gold URL hit@5 de 27,6 % à 31,4 %. Exa et Brave restaient devant.
Ce score porte cependant sur le texte renvoyé par chaque fournisseur, et pas seulement sur les pages choisies. Quand deux fournisseurs renvoyaient la même page, le juge a donné la même note aux deux copies dans 71 % des cas, et quand les notes différaient, la copie la plus courte obtenait la note la plus basse dans 69 % des cas. Pour séparer les deux, le harness note aussi chaque page avec la meilleure note obtenue par l’une de ses copies chez n’importe quel fournisseur. Avec cette mesure par page, l’avance d’Exa sur Brave se réduit à 0,09 (IC à 95 % : 0,05 à 0,13), mais ne disparaît pas, et tous deux ont choisi de meilleures pages que Google. Notez que cela n’équilibre les choses que pour les pages renvoyées par plus d’un fournisseur. Tout le reste est toujours noté sur le texte propre au fournisseur.
Brave et Exa coûtent à peu près pareil, et Google coûte le plus cher
La recherche elle-même coûte le même prix, 10 $ pour 1 000 requêtes, chez tous les fournisseurs, donc l’écart de coût vient des tokens que vous envoyez ensuite au modèle. Brave et Exa sont arrivés à peu près au même niveau, tandis que le texte de page de Google a rendu les prompts de réponse environ 3,6 fois plus longs que ceux de Brave, ce qui a presque doublé le coût par requête. Ces coûts utilisent les prix catalogue de
zai-org-glm-5-2 sans remise de cache, donc les chiffres exacts dépendent de votre modèle, mais les rapports entre fournisseurs tiennent.
Exa a été le plus rapide en médiane cette fois, à 0,71 seconde contre 0,97 pour Brave, mais nous ne classerions pas ces deux-là : Brave a été plus rapide lors de notre première exécution, la veille, quand la médiane d’Exa était de 1,73 seconde, et à nouveau lors de l’exécution du 11 novembre, à 0,99 seconde contre 1,54. La latence est mesurée côté client via l’API Venice, donc elle inclut le temps réseau et la surcharge propre à Venice, et elle varie d’une exécution à l’autre. Ce qui s’est confirmé sur les trois exécutions, c’est que Brave et Exa sont tous deux restés sous les 2 secondes en médiane, et que Google a été le plus lent à chaque fois, à 4,52 secondes ici et 5,36 lors de la nouvelle exécution.
Les questions générales
Les 6 questions générales n’ont pas de réponse de référence, donc le juge a comparé directement les réponses de chaque paire de fournisseurs, deux fois en inversant l’ordre. Les réponses d’Exa ont battu celles de Google sur 4 d’entre elles, mais avec seulement 6 questions, nous ne nous appuierions pas là-dessus. Le détail complet figure dans le rapport.Alors, lequel utiliser ?
D’après cette exécution, voici comment nous choisirions :- Exa, pour la plupart des charges de travail qui transmettent directement les résultats à un modèle, en particulier les assistants de code et les agents de recherche. Il a obtenu la meilleure précision, ou une précision à égalité avec la meilleure, sur chaque ensemble de questions, et les résultats les plus pertinents, pour un coût par requête à peu près identique à celui de Brave.
- Brave, si vos questions ressemblent davantage à nos questions d’actualité et de documentation, où il était à égalité avec Exa, ou si vous avez surtout besoin de trouver la page officielle de quelque chose, ce qu’il a fait presque aussi souvent qu’Exa. C’est le fournisseur par défaut, et il est rapide et peu coûteux.
- Google, si vous voulez le texte de la page directement dans la réponse de recherche, sans scraping séparé. La plupart des résultats sont la page complète, mais environ un quart se limitent à l’extrait, quand le site bloque le scraping. Vous devrez prévoir les tokens et la latence supplémentaires et, si vous tronquez les résultats, conservez les passages qui correspondent à la question plutôt que le début de chaque page.
Mises en garde
Quelques points à garder à l’esprit avant de trop interpréter ces chiffres :- Les questions ont été choisies pour nécessiter une recherche. Nous avons écarté toutes les questions auxquelles le modèle pouvait répondre seul, donc l’ensemble est plus difficile que le trafic courant.
- Des agents IA ont rédigé les questions. Chacune a été vérifiée par rapport à ses sources et relue, mais une réponse de référence peut encore être fausse. Si vous en repérez une, ouvrez une issue sur le dépôt.
- Les notes de version représentent une grande partie de l’ensemble. Elles comptent pour 61 des 156 réponses de référence, et c’est d’elles que vient l’essentiel de l’avance d’Exa, donc comparez le tableau par ensemble de questions avec votre propre charge de travail.
- Les notes viennent d’un modèle. Nous avons revu chaque réponse que le juge n’a pas jugée correcte avec les résultats tels que renvoyés, 82 au total, plus 30 qu’il a jugées correctes. Nous en modifierions 6, toutes de fausse à correcte : 3 pour Brave, 2 pour Google et 1 pour Exa. Cela placerait Brave à 80,1 %, Google à 76,9 % et Exa à 94,2 %, donc le classement ne change pas, mais le juge penche un peu vers la sévérité.
- Les résultats de recherche évoluent. Ces chiffres sont un instantané d’octobre 2026, et les réponses de référence dépendantes du temps, en particulier celles d’actualité, se périment. Notre exécution du 11 novembre a gardé le même classement pour Exa, mais a fait bouger Brave face à Google ainsi que les scores de pertinence de Google.
- Notre exécution principale a recherché chaque question telle qu’elle était écrite. Réécrire les questions en requêtes de recherche n’a pas changé le classement lors de notre exécution du 10 novembre, mais la réécriture propre à votre application pourrait le faire.
- Nous avons testé les fournisseurs via l’API de Venice. Chacun renvoie ses résultats dans son propre format, donc ces chiffres décrivent les trois options telles que l’API les renvoie, et non les moteurs de recherche en général.
- Les scores de pertinence dépendent de la quantité de texte renvoyée. Un extrait court peut obtenir une note plus basse qu’une copie plus longue de la même page. Le score par page corrige cela pour les pages renvoyées par plus d’un fournisseur, mais pas pour les autres.
- Les conditions avec budget tronquent par la fin. Un pipeline qui sélectionne les passages par pertinence traiterait mieux les résultats de Google que le nôtre.
- Un seul modèle a rédigé toutes les réponses, et ce même modèle a filtré les questions. Un autre modèle pourrait mieux (ou moins bien) exploiter les résultats longs, et connaître déjà certaines réponses.
Le lancer vous-même
Le harness est un petit projet Bun et TypeScript sans dépendance d’exécution. Une fois le dépôt cloné, installez les dépendances de développement et lancez les tests :.env du dépôt :
--budget, qui vaut 5 : 4,86 . Chaque exécution écrit un report.md avec les tableaux complets derrière cet article, un results.csv avec une ligne par question, fournisseur et condition, un summary.json, et deux fichiers avec chaque réponse et la liste de résultats de chaque fournisseur.
Si vous voulez simplement explorer nos chiffres, vous n’avez rien à lancer, puisque le dossier results du dépôt contient tout cela pour cette exécution.
Le véritable intérêt reste toutefois de le lancer sur vos propres questions. Écrivez-les en JSON Lines, avec un objet par question :
goldAnswer obtiennent quand même des scores de récupération, donc vous pouvez commencer avec une liste de vraies requêtes tirées de vos logs et ajouter des réponses de référence plus tard. Avant de vous fier aux chiffres de précision, vérifiez cependant combien de vos questions le modèle réussit avec --arms none, puisque les questions dont il connaît déjà la réponse ne départageront pas vos fournisseurs.