

brave, google o exa. Costano tutti uguale, $0.01 per ricerca, quindi la domanda ovvia è quale dovresti usare davvero.
In questo articolo lo scopriremo. Abbiamo costruito un benchmark che invia le stesse 162 domande a ogni provider, fa rispondere lo stesso modello a partire dai risultati di ciascun provider e valuta sia i risultati sia le risposte. Vedremo come abbiamo scelto le domande, cosa abbiamo trovato e come puoi eseguirlo da solo.
Ti interessa il codice completo? Dai un’occhiata al repository GitHub. Contiene anche ogni risposta e l’elenco dei risultati di ogni provider di questa esecuzione, così puoi verificare il nostro lavoro senza pagare un’esecuzione.
Cosa abbiamo misurato
Ci sono due cose diverse in cui un provider di ricerca può essere bravo, e non sempre coincidono:- Recupero: i risultati sono pertinenti e contengono davvero la risposta?
- Risposte: quando passi quei risultati a un modello, risponde correttamente?
POST /augment/search una volta per provider, con limit impostato a 10. Poi zai-org-glm-5-2 risponde a partire dai risultati di ciascun provider, e grok-4-7 valuta tutto con temperatura 0. Il modello risponde anche senza alcuna ricerca, come riferimento.
Nota che i provider non restituiscono la stessa quantità di testo, e nemmeno lo stesso tipo. Nella nostra esecuzione, Exa ha restituito 10 risultati per ricerca e Brave tra 7 e 10, composti da passaggi corrispondenti alla domanda, di circa 1.500-1.700 caratteri ciascuno. Google ha restituito 5 risultati, che è ciò che l’API di Venice restituisce per google qualunque valore tu imposti per limit. La maggior parte era il testo completo della pagina, a partire dall’inizio: navigazione, banner dei cookie e tutto il resto. Non tutti, però: quando un sito blocca lo scraping, come Reddit, Facebook, Stack Overflow o YouTube, il risultato è solo lo snippet di ricerca. In una nuova esecuzione dell’11 novembre, un quarto dei primi 5 risultati di Google aveva meno di 300 caratteri di testo. Questo corrispondeva a circa 9.700 caratteri per risultato, ovvero 48.000 per ricerca, contro circa 14.000 per Brave ed Exa. Più testo può significare risposte migliori, ma significa anche più token di input in ogni richiesta. Per vedere quanto conta il volume, il modello risponde a partire dai risultati di ciascun provider in tre modi:
Nelle due condizioni con budget, ogni provider riceve lo stesso numero di risultati e lo stesso spazio. Poiché l’harness mantiene l’inizio di ogni risultato, queste condizioni verificano anche quanto reggono i risultati di ciascun provider quando li tagli, cosa che fanno molte pipeline reali.
Le domande
La prima versione di questo benchmark aveva un problema: senza ricerca, il modello rispondeva già al 72% delle domande che potevamo valutare, quindi i tre provider sembravano più o meno uguali. Se il modello conosce già la risposta, la ricerca non può fare molta differenza, e non può nemmeno dirti quale provider sia migliore. Per questa esecuzione abbiamo quindi raccolto 156 domande con risposte di riferimento, la cui risposta deve arrivare da una ricerca:
Le domande di programmazione hanno stili diversi, dai messaggi di errore incollati alle domande legate a una versione come “Which ripgrep version started respecting the GIT_CONFIG_GLOBAL environment variable?”. È voluto: un motore di ricerca ottimo con il linguaggio naturale può comunque inciampare su una stringa di errore. Ci sono anche 6 domande generali senza risposta di riferimento, come lunghe domande colloquiali, su cui torneremo più avanti.
Ogni domanda con risposta di riferimento ha superato gli stessi controlli prima di essere inclusa. Abbiamo redatto ciascuna con agenti AI a partire da una fonte primaria, come una nota di rilascio o un comunicato stampa ufficiale, e uno script ha scaricato ogni fonte per confermare che la citazione alla base della risposta di riferimento fosse davvero nella pagina. Poi il modello ha risposto a ogni domanda due volte senza ricerca, e abbiamo scartato qualsiasi domanda a cui ha risposto correttamente almeno una volta.
Per le domande su notizie e temi sensibili, abbiamo anche dato al modello le citazioni della fonte come risultati di ricerca, e abbiamo mantenuto una domanda solo se rispondeva correttamente entrambe le volte. Questo intercetta le domande ambigue e verifica che il modello risponda a una domanda sensibile quando ha la fonte. Infine, un altro agente ha ricontrollato ogni domanda e risposta di riferimento rispetto alle fonti, il che ha portato a 47 modifiche e altri 3 scarti, e ogni domanda modificata è ripassata dal filtro senza ricerca.
Nota che questo rende il riferimento senza ricerca vicino a zero per costruzione, quindi non ti dice quanto spesso la ricerca aiuti in generale. Ti dice però che ogni domanda del set richiede una ricerca, che è esattamente ciò che vogliamo quando confrontiamo provider di ricerca.
Le metriche
L’accuratezza è accompagnata da un intervallo di confidenza al 95%, e le differenze tra provider derivano da confronti appaiati sulle stesse domande: un intervallo bootstrap e un test esatto di McNemar. Con 156 risposte di riferimento, ogni domanda vale circa 0,6 punti percentuali, e gli intervalli sull’accuratezza arrivano a circa ±7 punti, quindi conviene controllare i confronti appaiati prima di leggere troppo in un piccolo divario.
Risultati
Exa ha risposto correttamente al maggior numero di domande
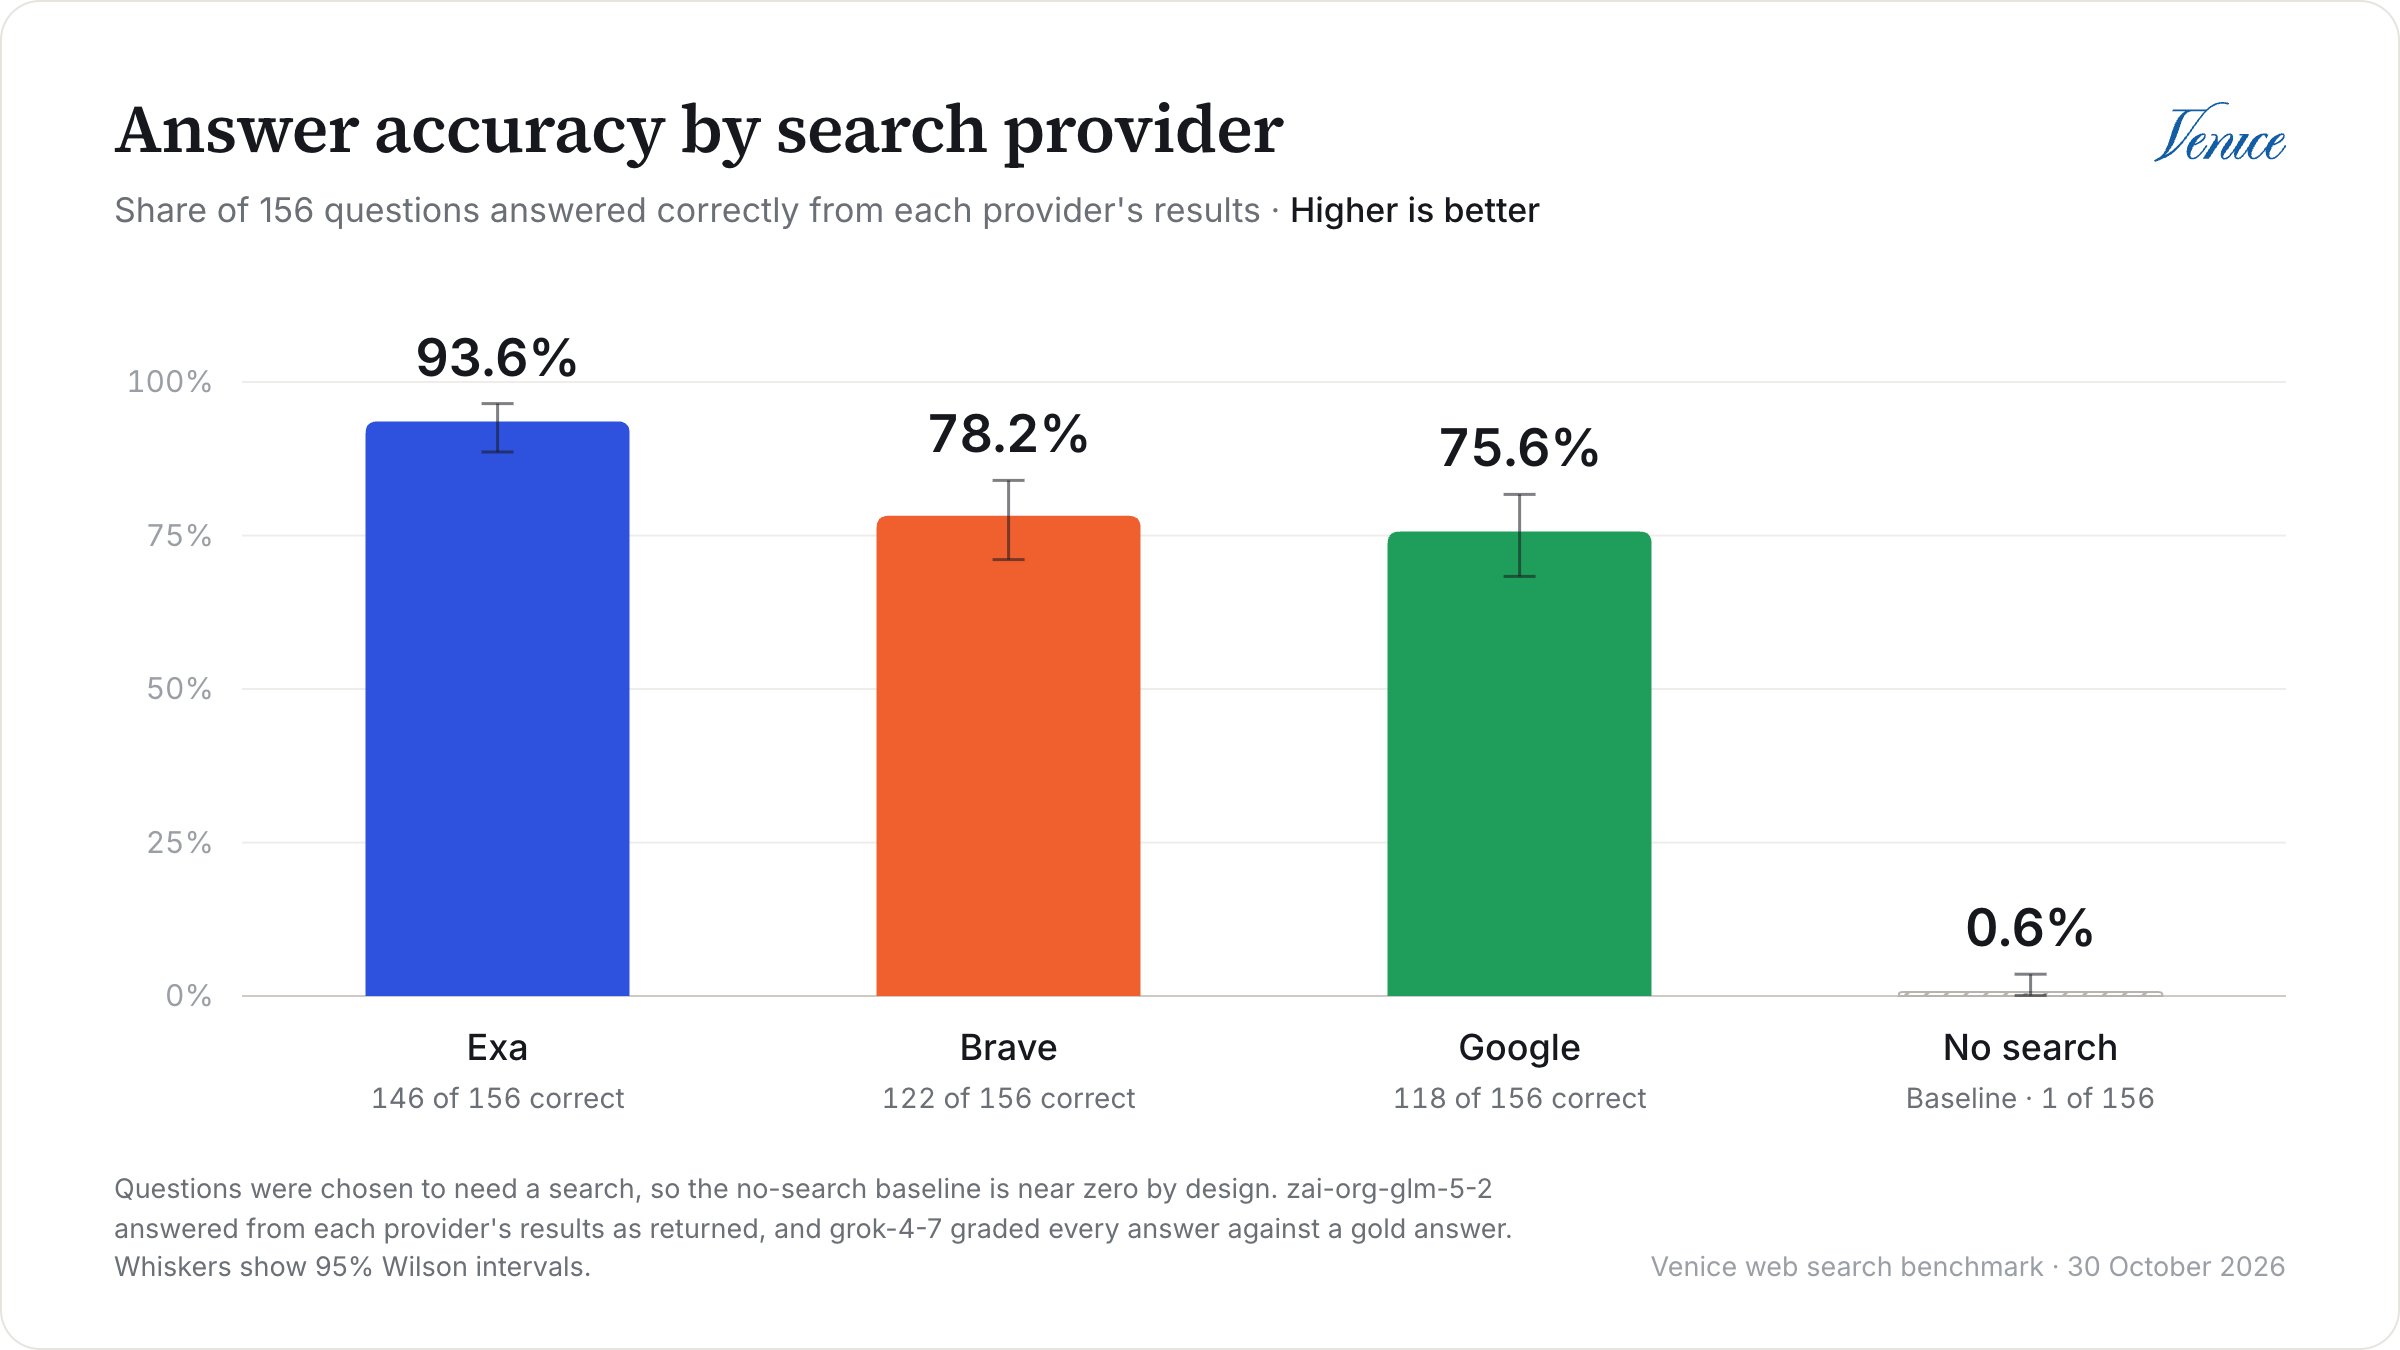
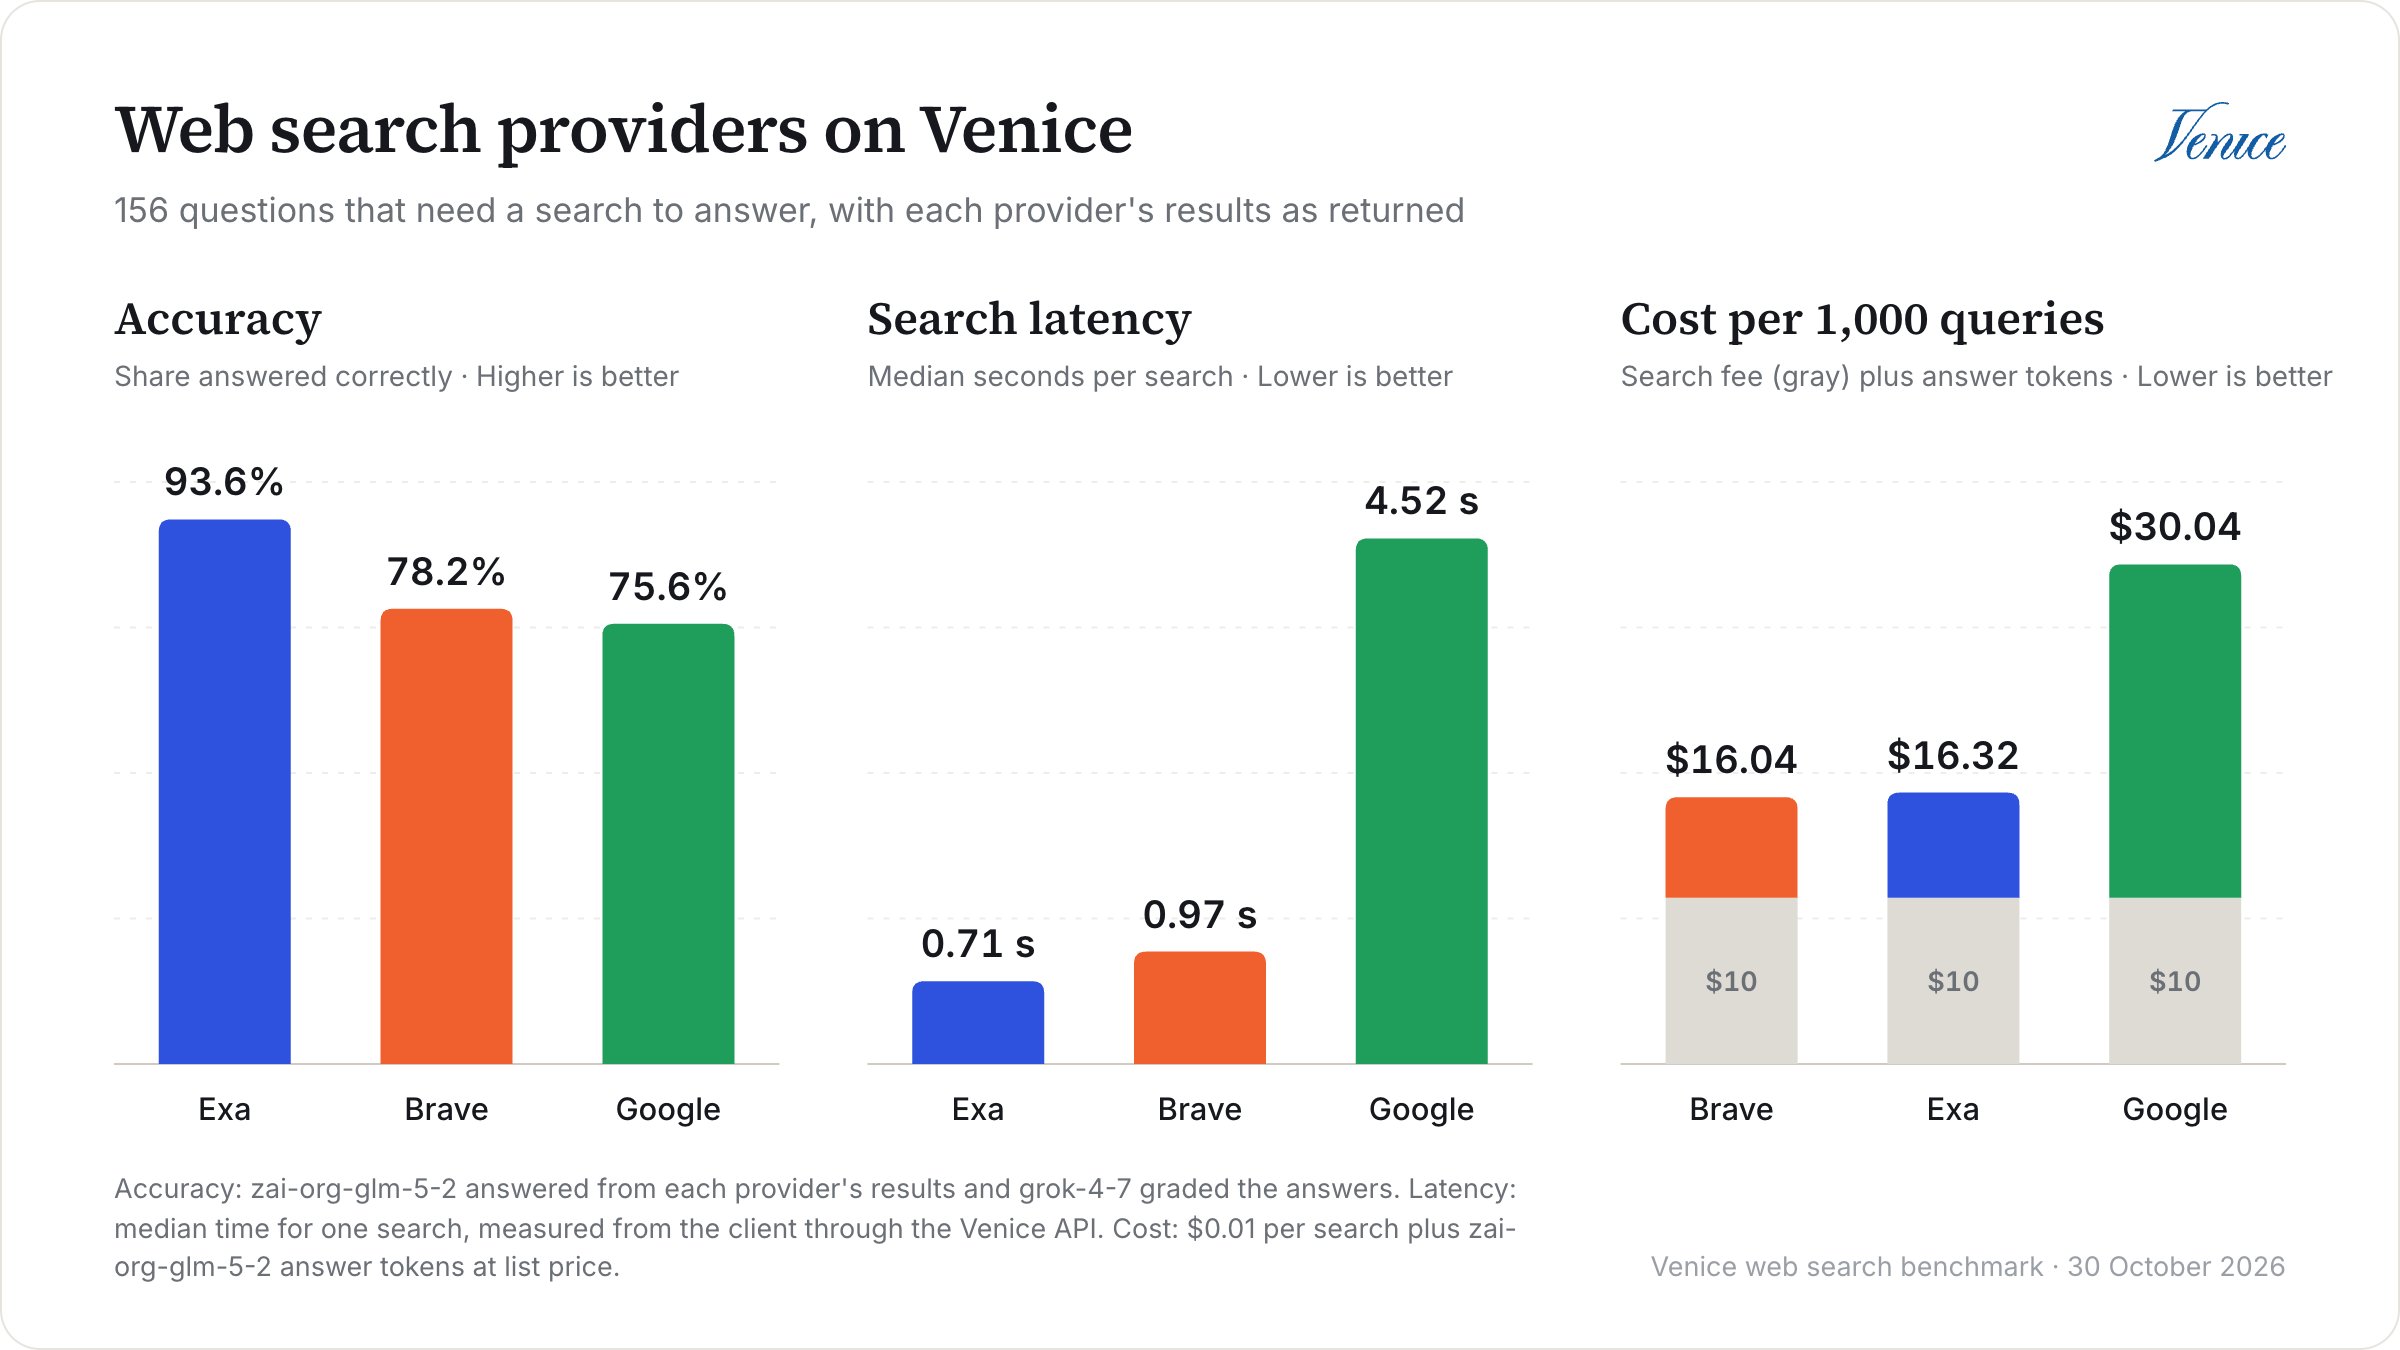
Con tutti i risultati così come restituiti, Exa ha risposto correttamente al 93,6% delle domande, circa 15 punti davanti a Brave e 18 davanti a Google. Questa volta il divario è netto: Exa ha risposto correttamente a 28 domande che Brave ha sbagliato, con solo 4 nel senso opposto, e a 33 che Google ha sbagliato, contro 5 (McNemar p < 0.001 per entrambi).
Per verificare che non fosse un caso isolato, abbiamo rieseguito l’intero benchmark l’11 novembre con le stesse impostazioni, e anche quei risultati sono nel repository. Exa è risultato di nuovo primo, con il 93,6% contro l’81,4% di Brave e il 72,4% di Google, e ha superato Brave di 12,2 punti (24 domande a 5, p = 0.001).
Brave contro Google è meno definito. In questa esecuzione erano alla pari, 22 domande a 18, ben dentro il rumore. Nella nuova esecuzione Brave è passato in vantaggio, 29 domande a 15 (9,0 punti, p = 0.049). Quindi Brave era alla pari con Google o davanti, a seconda dell’esecuzione.
Volevamo anche sapere se il vantaggio di Exa dipendesse da come erano formulate le domande, dato che le abbiamo cercate esattamente come erano scritte, mentre le applicazioni reali di solito le riscrivono prima come query di ricerca. Così in un’altra esecuzione, il 10 novembre, abbiamo fatto riscrivere al modello ogni domanda una volta come query per un motore di ricerca, abbiamo inviato la stessa query a tutti e tre i provider e abbiamo valutato le risposte alla domanda originale. Exa ha comunque superato Brave di 13,5 punti (24 domande a 3), e il punteggio di nessun provider è cambiato in modo significativo, quindi la formulazione non spiega il vantaggio di Exa.
Anche le risposte senza ricerca meritano un’occhiata. Senza ricerca, il modello ci ha detto di leggere un header
Retry-After dopo un 429 invece di x-ratelimit-reset-requests di Venice, ha inventato un suffisso -web-search per attivare la ricerca web tramite il nome del modello e ha elencato un provider di ricerca venice che non esiste. Se i tuoi utenti fanno domande su API nuove o di nicchia, la conoscenza propria del modello non basterà.
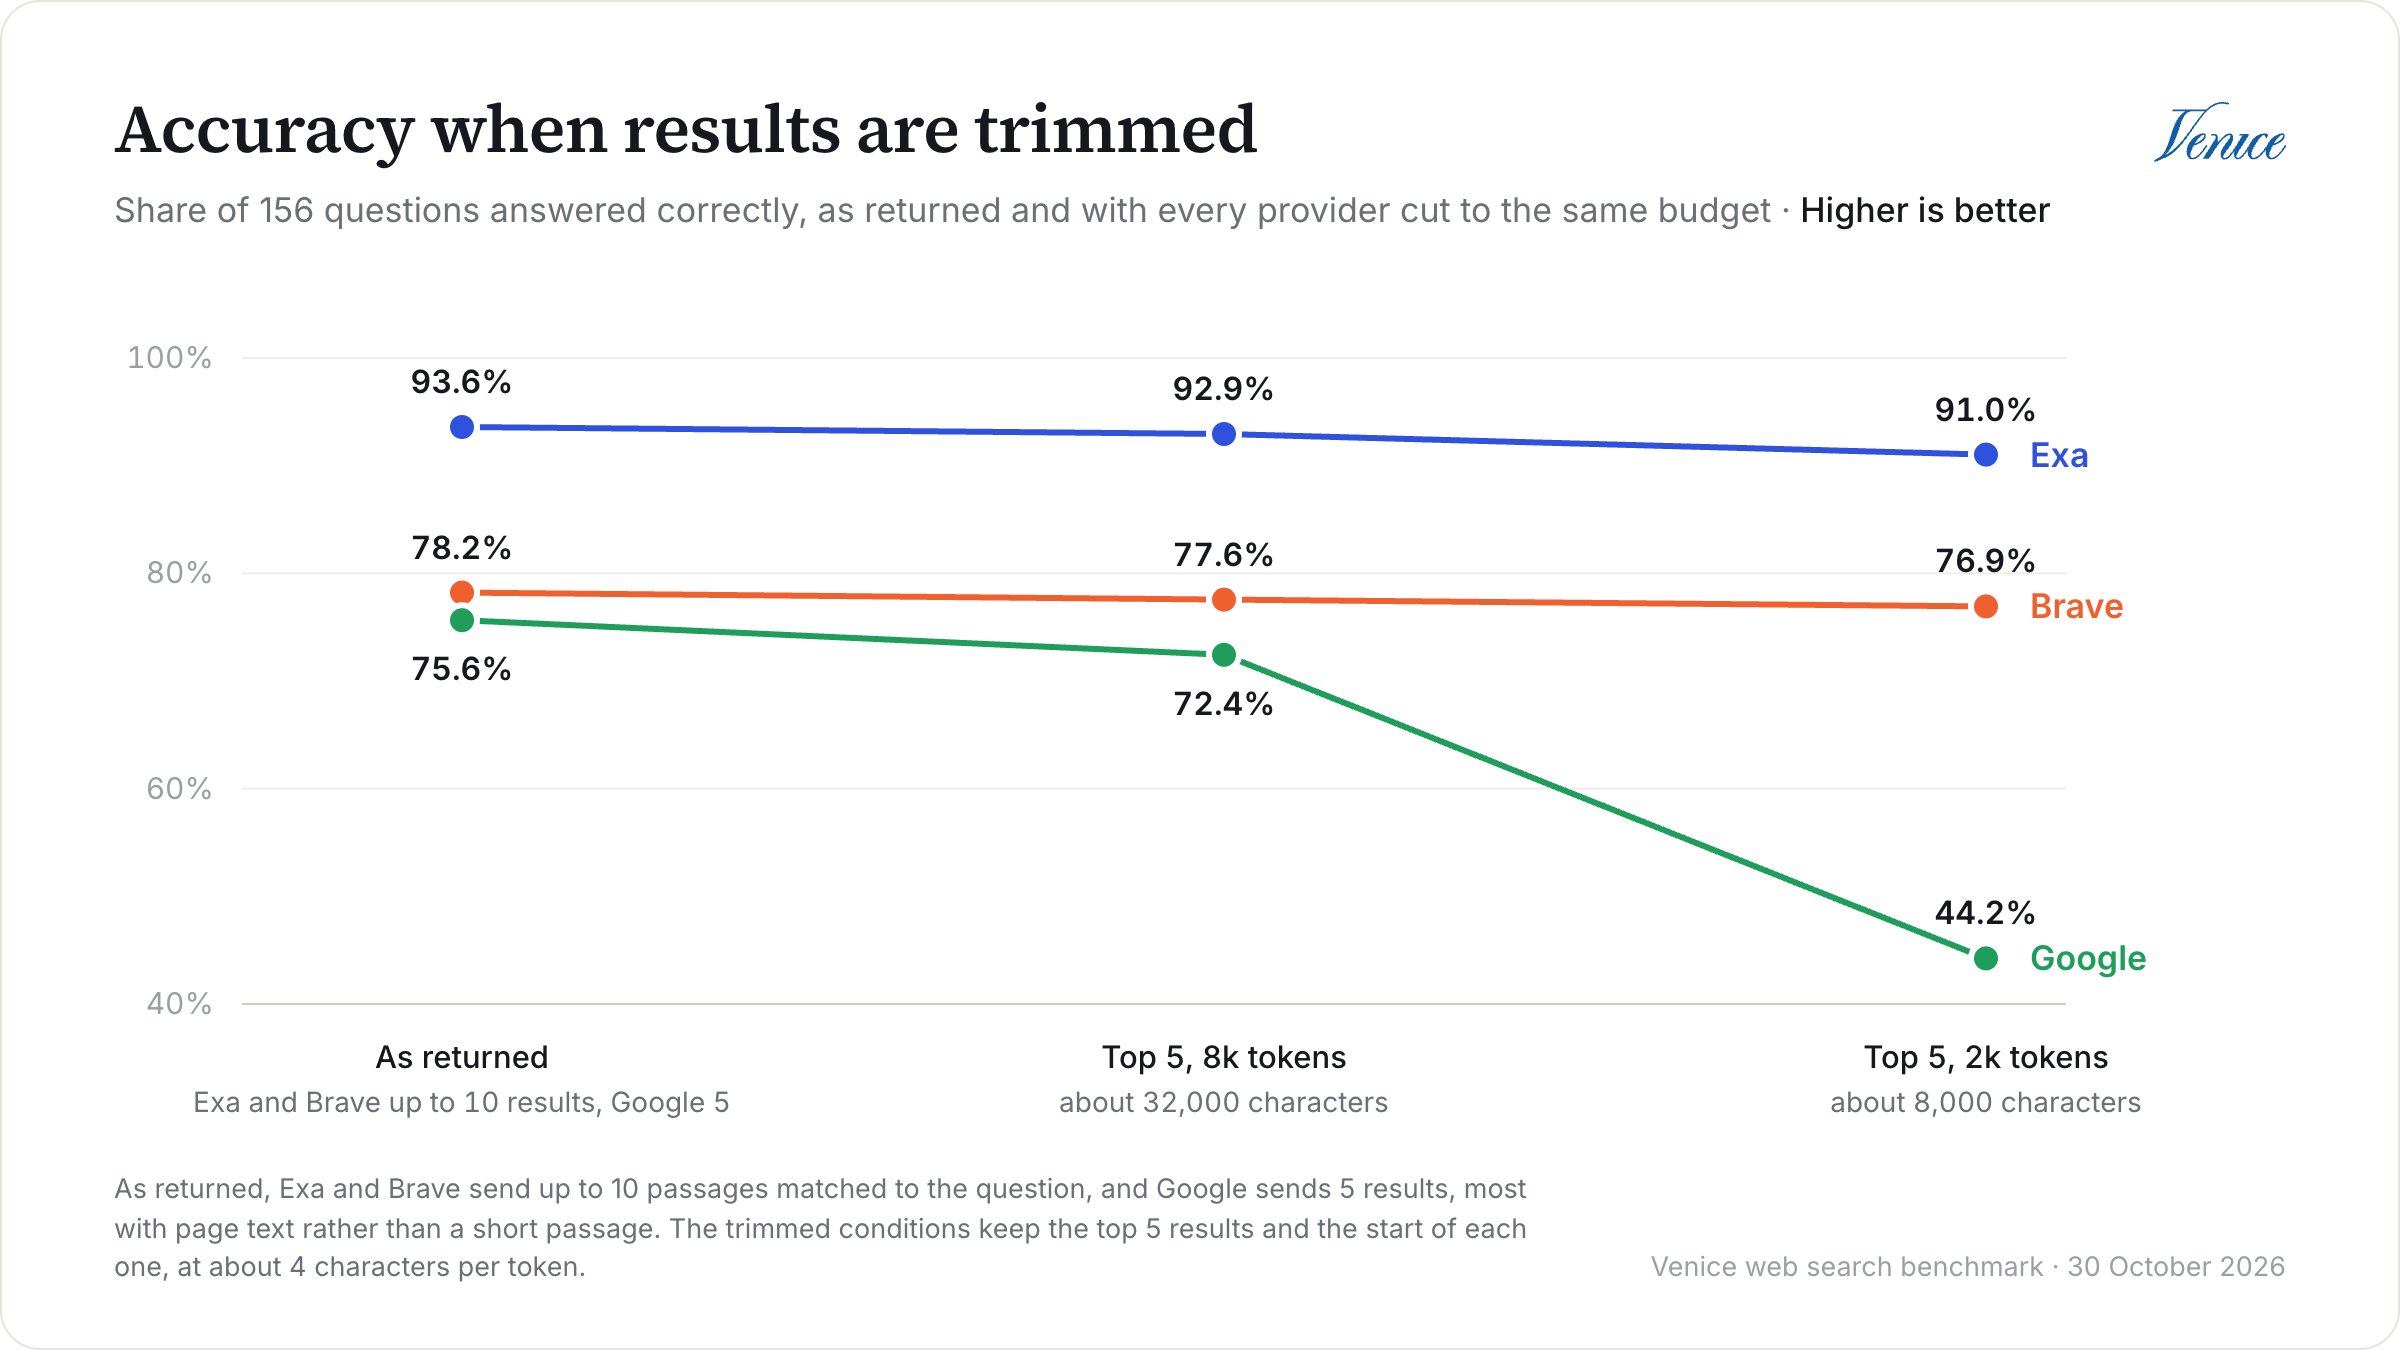
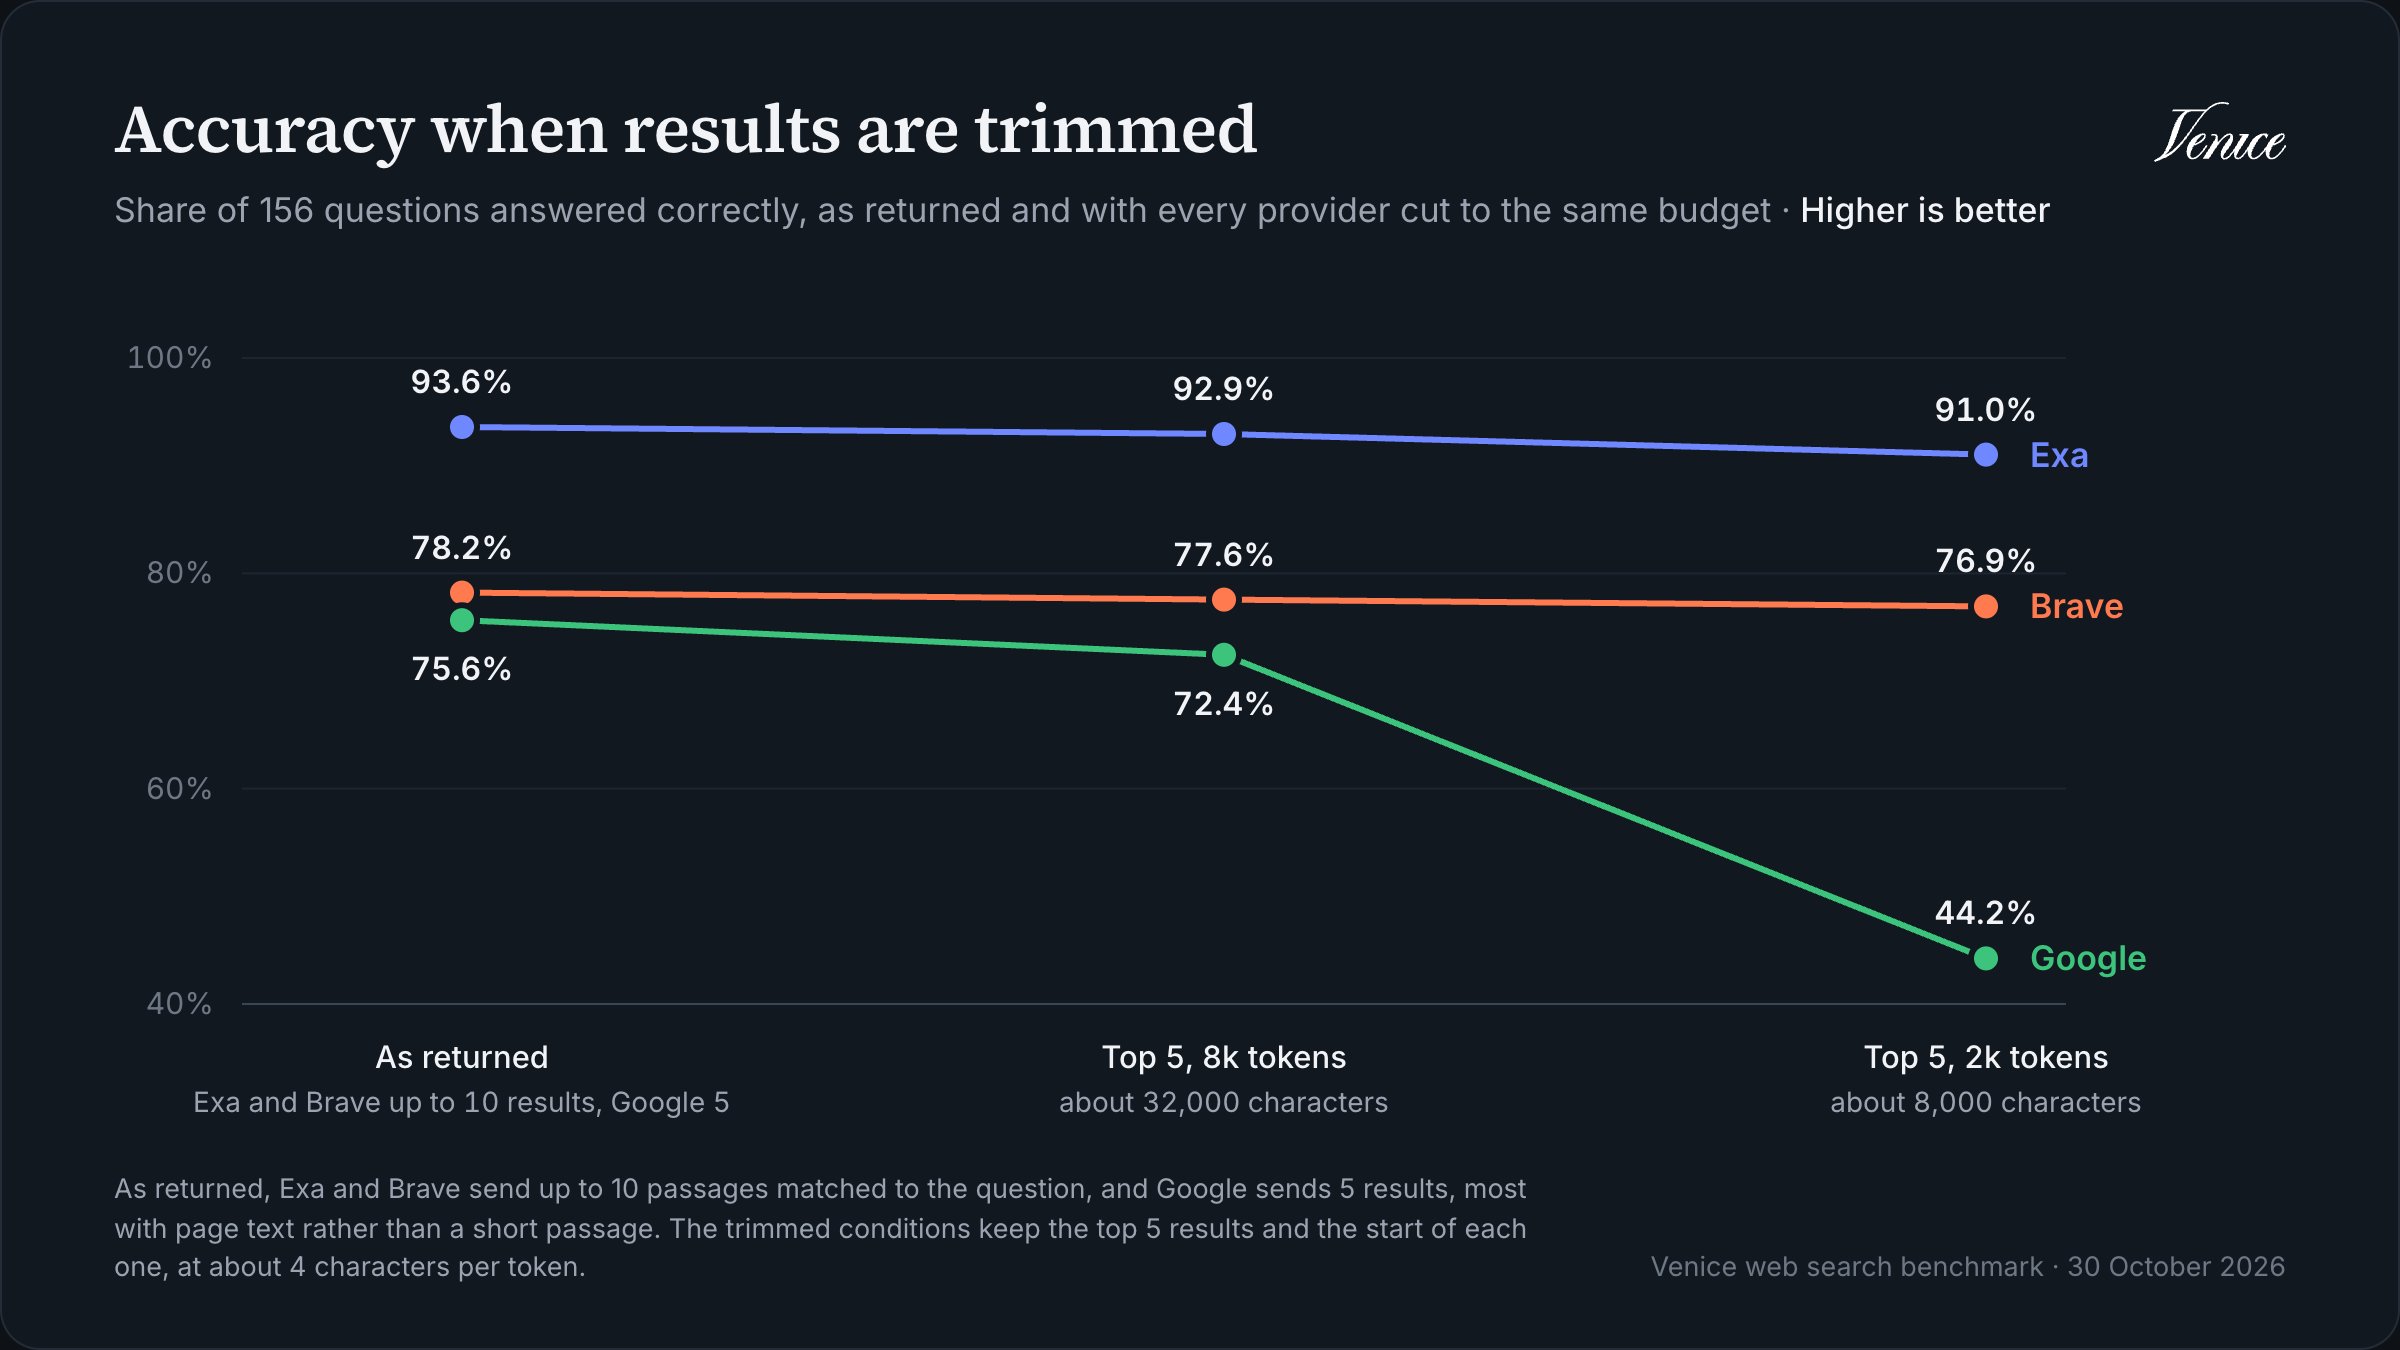
Le condizioni con budget sono quelle in cui Google cede. A 2.000 token, la sua accuratezza è scesa al 44,2%, e il modello non ha trovato una risposta per il 30% delle domande, contro il 10% quando aveva i risultati completi di Google. Poiché i risultati di Google partono dall’inizio della pagina, tagliarli per farli entrare ha mantenuto la navigazione e i banner ed eliminato la parte che rispondeva alla domanda. I risultati di Brave ed Exa sono già passaggi corrispondenti alla domanda, quindi tagliarli non ha cambiato quasi nulla. A 8.000 token, Google ha recuperato quasi tutto, arrivando al 72,4%.
Da dove viene il vantaggio di Exa
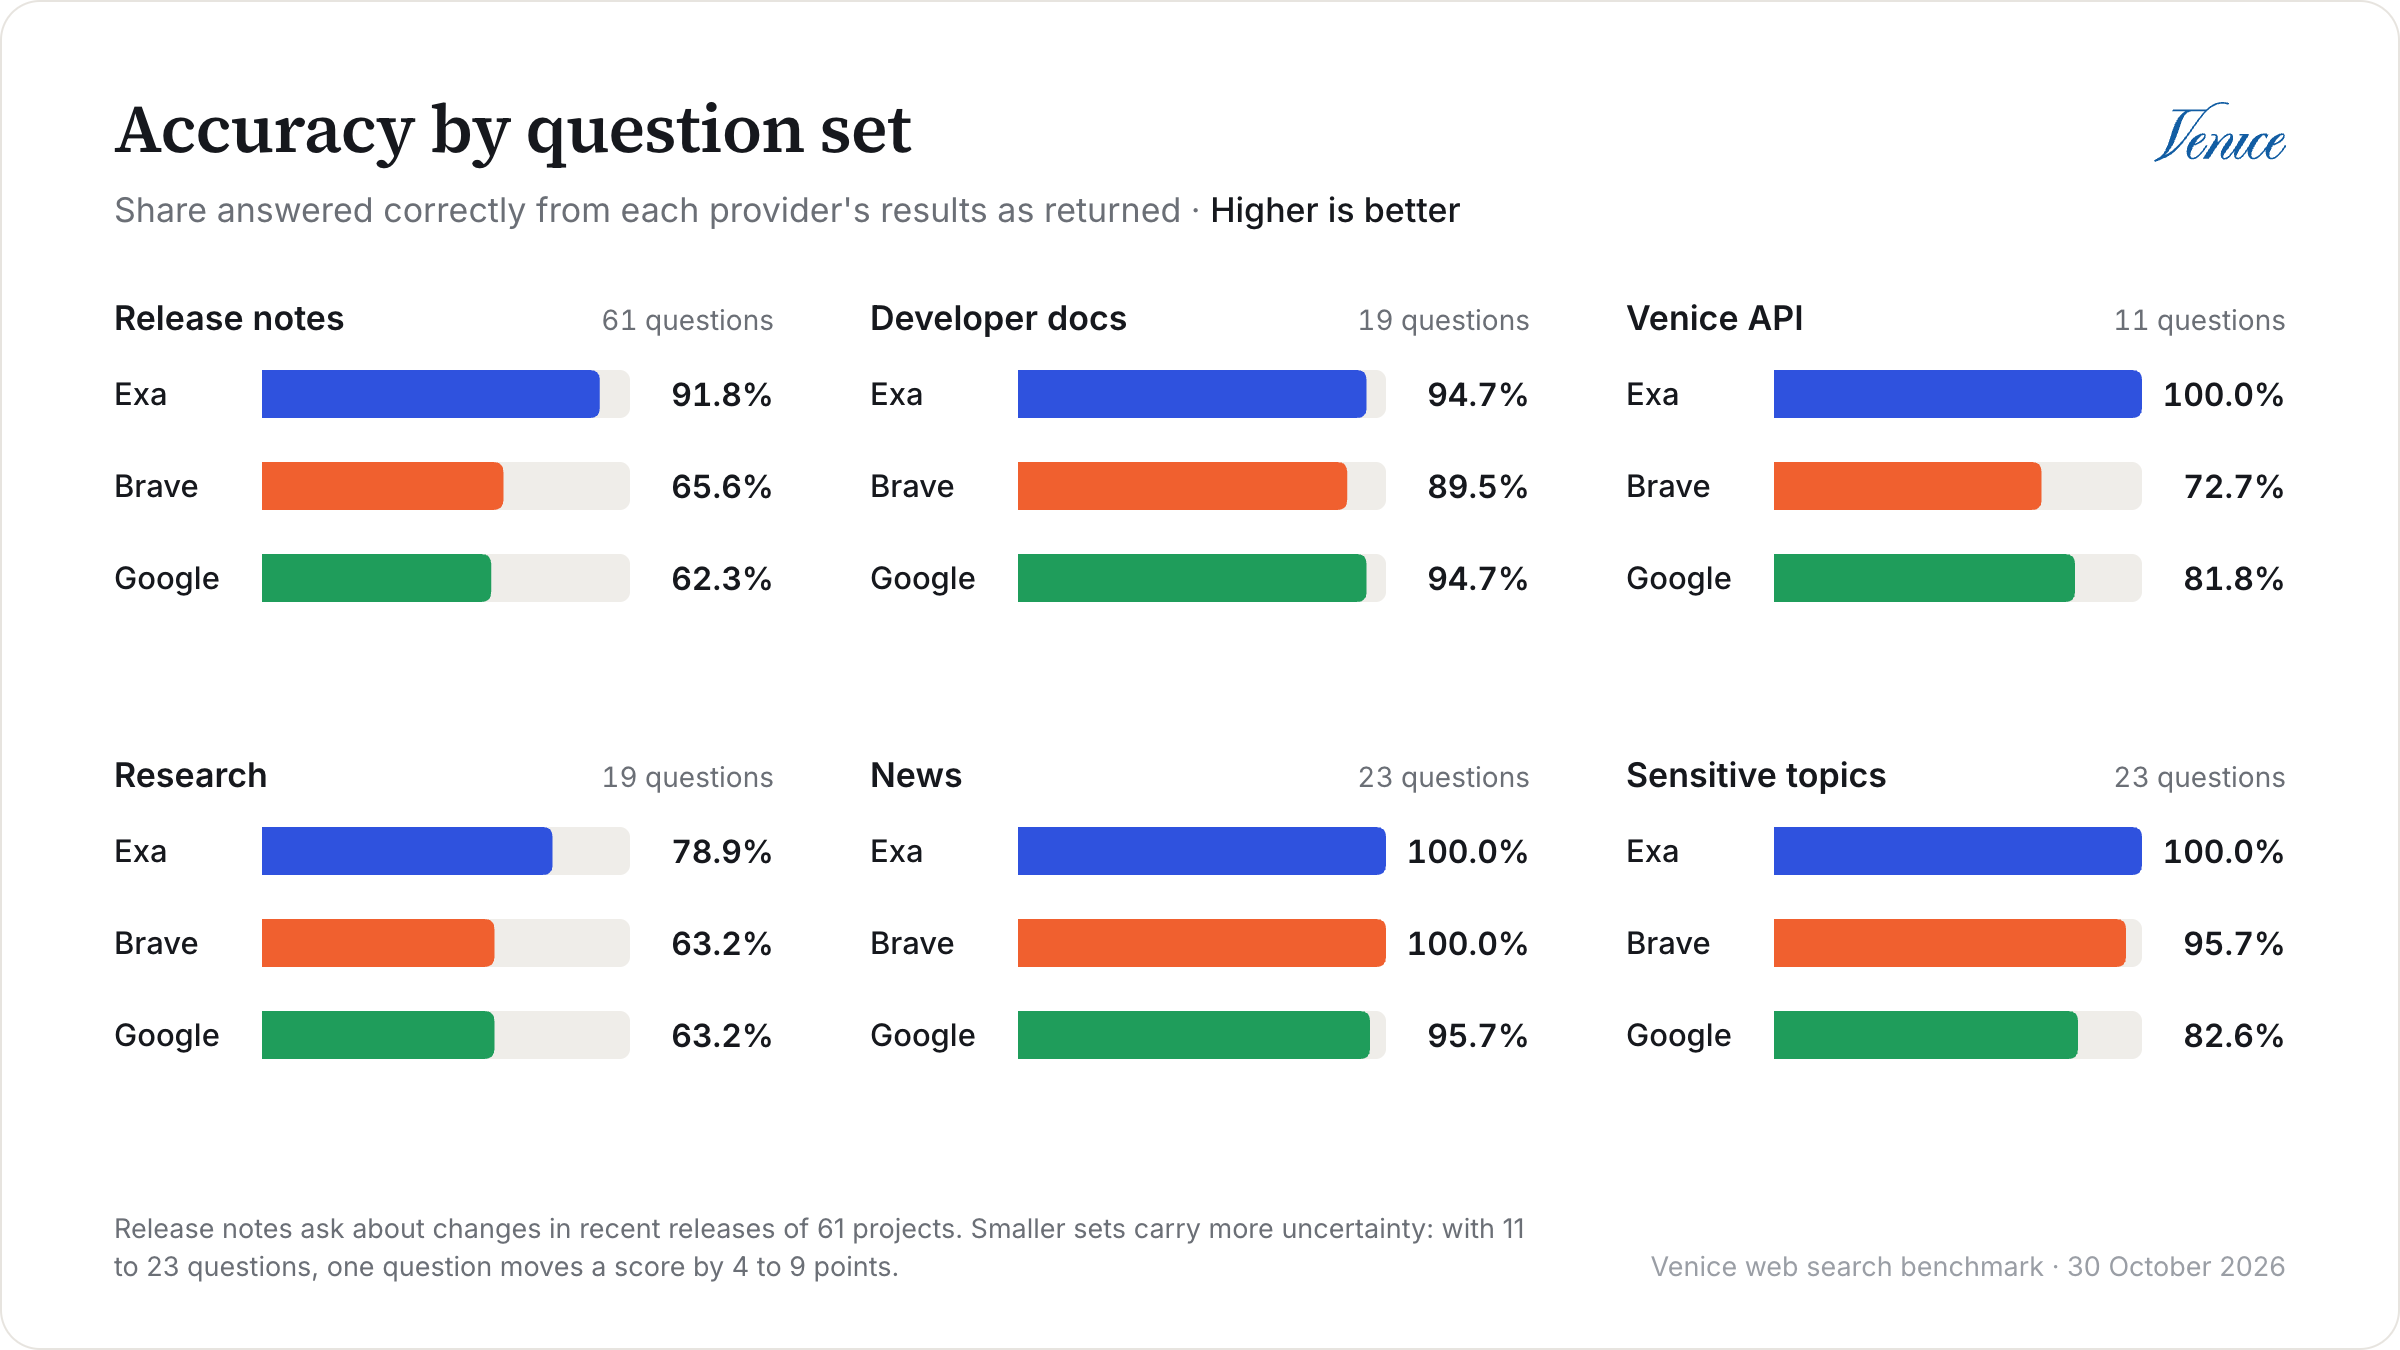
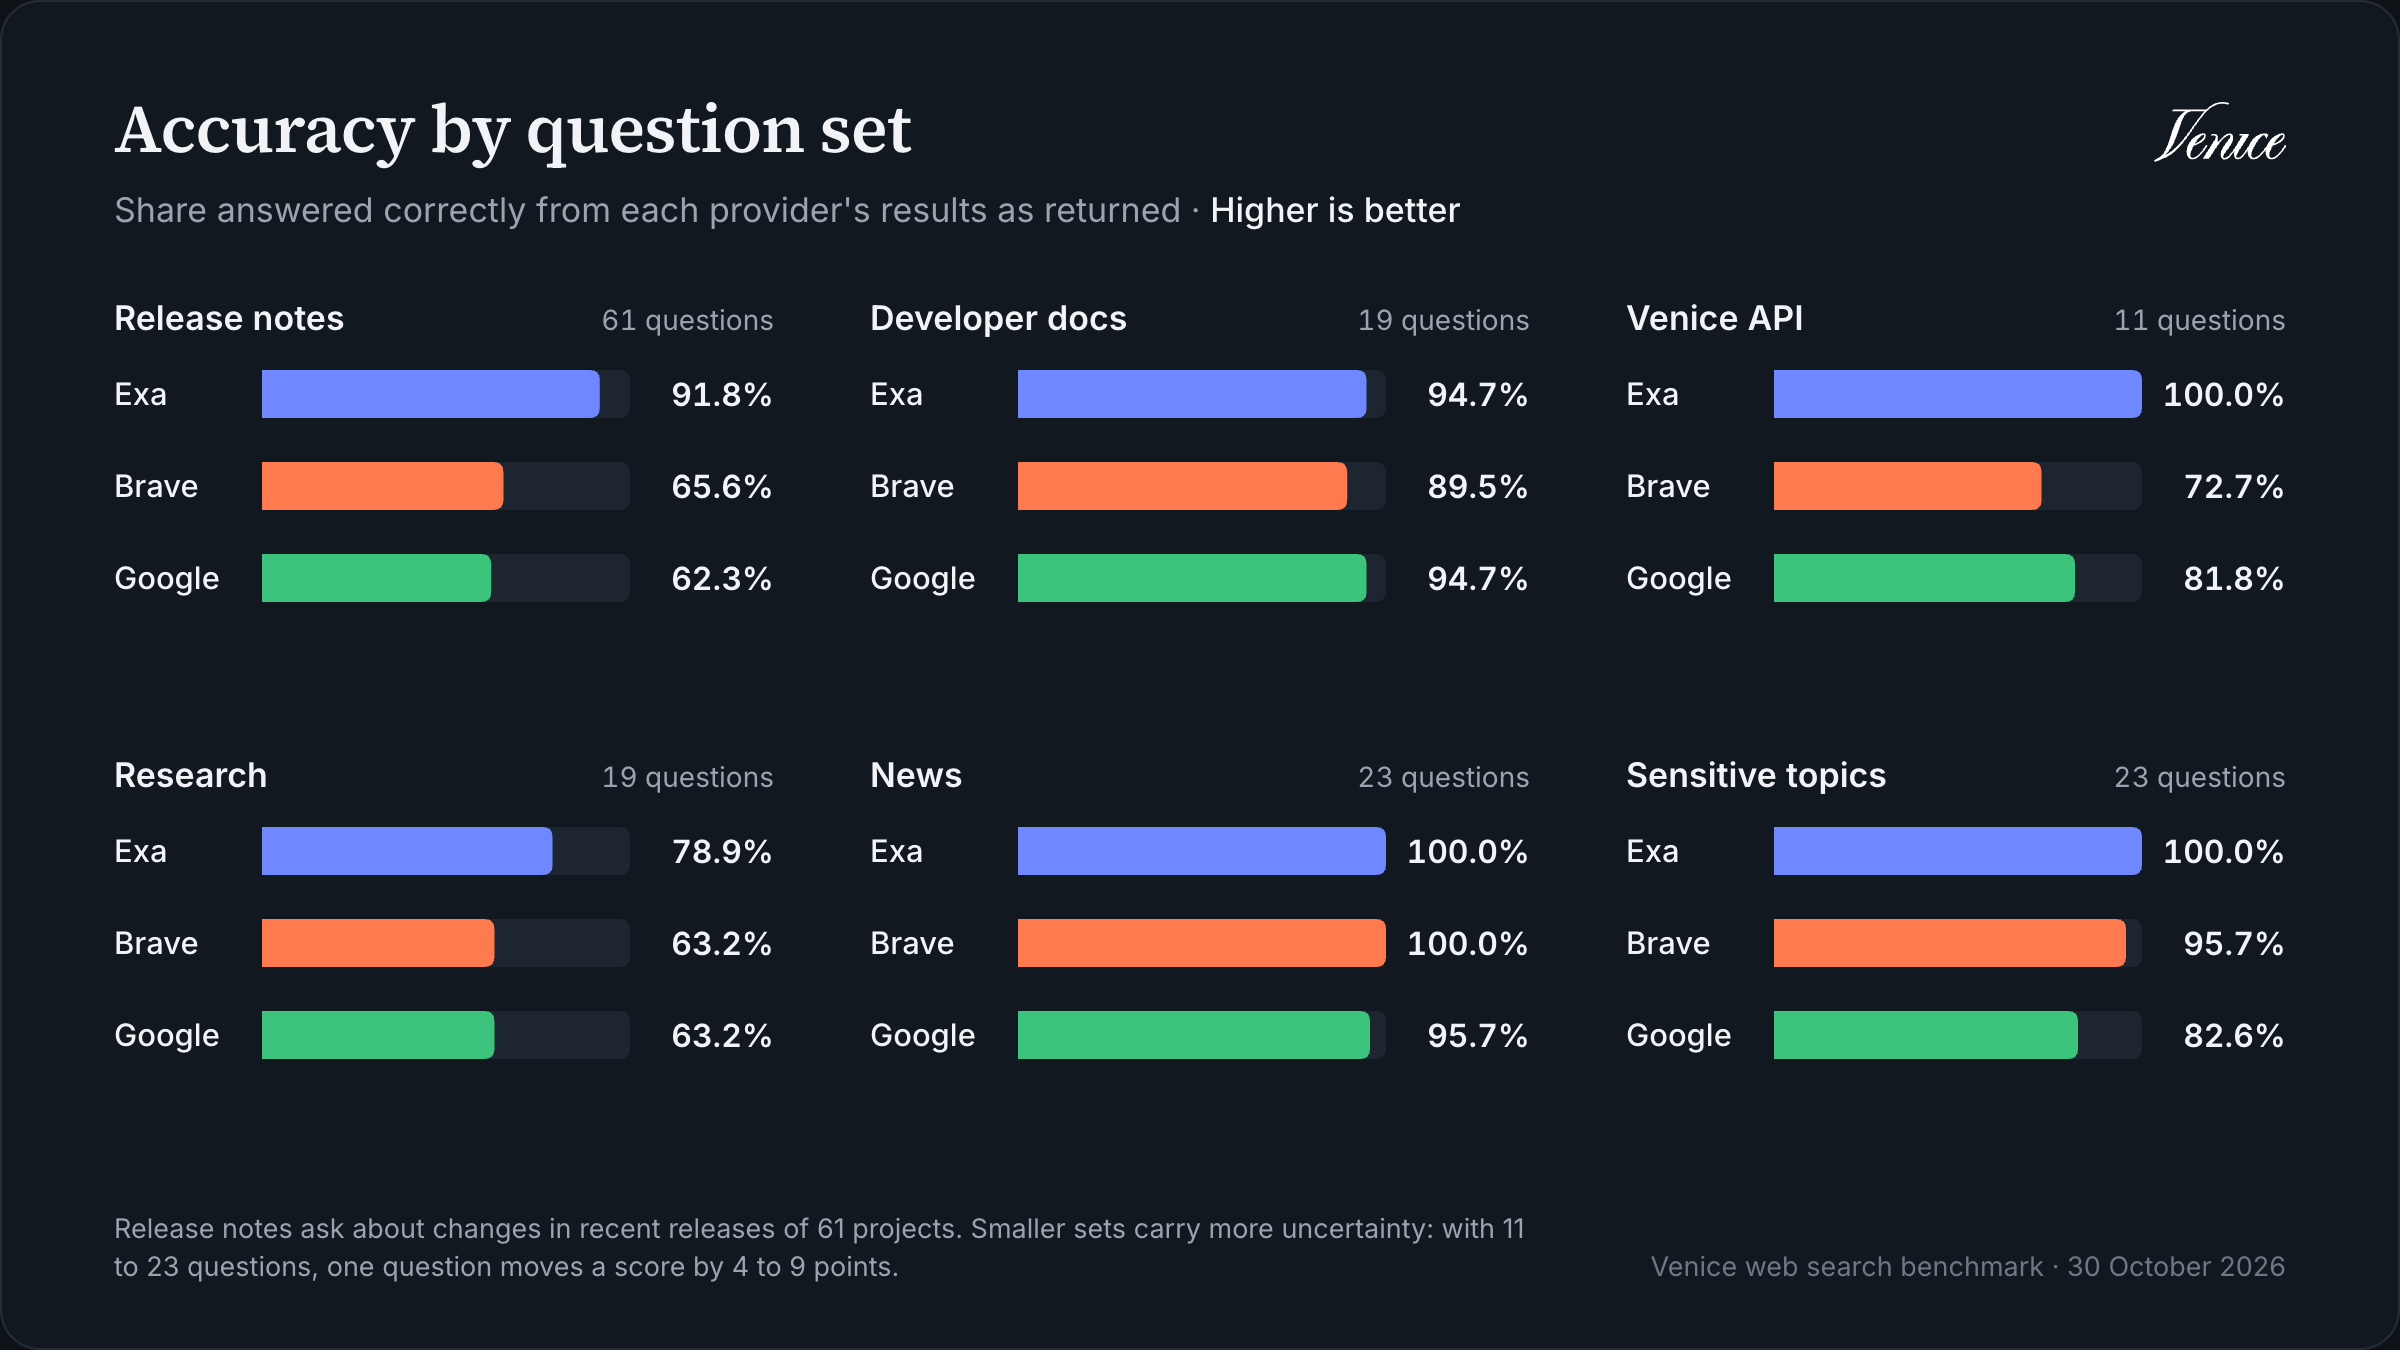
La maggior parte del divario viene da un solo punto: le note di rilascio. Exa ha risposto correttamente a 56 delle 61 domande sui rilasci, contro 40 di Brave e 38 di Google. La risposta a queste domande di solito si trova in una singola riga di un changelog, e i risultati di Exa avevano molte più probabilità di includerla. Nelle domande sui rilasci con un identificatore noto, come un flag o una variabile d’ambiente, i risultati di Exa ne contenevano il 97% alla lettera, contro il 76% di Brave e il 68% di Google. Nelle domande legate a una versione in tutti i set di programmazione, Exa ha risposto correttamente al 95% e gli altri due al 55%.
Le domande di ricerca sono state le più difficili per tutti, perché richiedono due fatti da due pagine diverse, e anche Exa ne ha azzeccate solo 15 su 19. Su notizie e documentazione per sviluppatori, invece, tutti e tre i provider hanno risposto quasi a tutto. Se le domande dei tuoi utenti somigliano a queste, il provider che scegli conta molto meno.
E i temi sensibili?
Alcuni servizi di ricerca filtrano o nascondono i risultati sui temi sensibili, quindi abbiamo aggiunto 23 domande per verificare se qualcuno dei tre provider lo facesse. Coprono temi come leggi sulle droghe, aborto, lavoro sessuale, armi da fuoco, sorveglianza e blocchi di internet, e ognuna ha una risposta fattuale da una fonte ufficiale, come una sentenza o un avviso governativo. Nessun provider è tornato vuoto o con un errore su nessuna di esse, e il modello non si è mai rifiutato di rispondere a causa del tema. Exa ha risposto correttamente a tutte e 23, Brave a 22 e Google a 19. Gli errori erano normali errori di ricerca, in cui i risultati non contenevano il fatto o riportavano una data diversa, tranne una risposta di Google che era esitante ma dava la data giusta, su cui il giudice è stato troppo severo. Nota che 23 domande possono solo mostrare che non abbiamo visto filtri, non che non ce ne siano da nessuna parte.Exa ha restituito il testo più utile
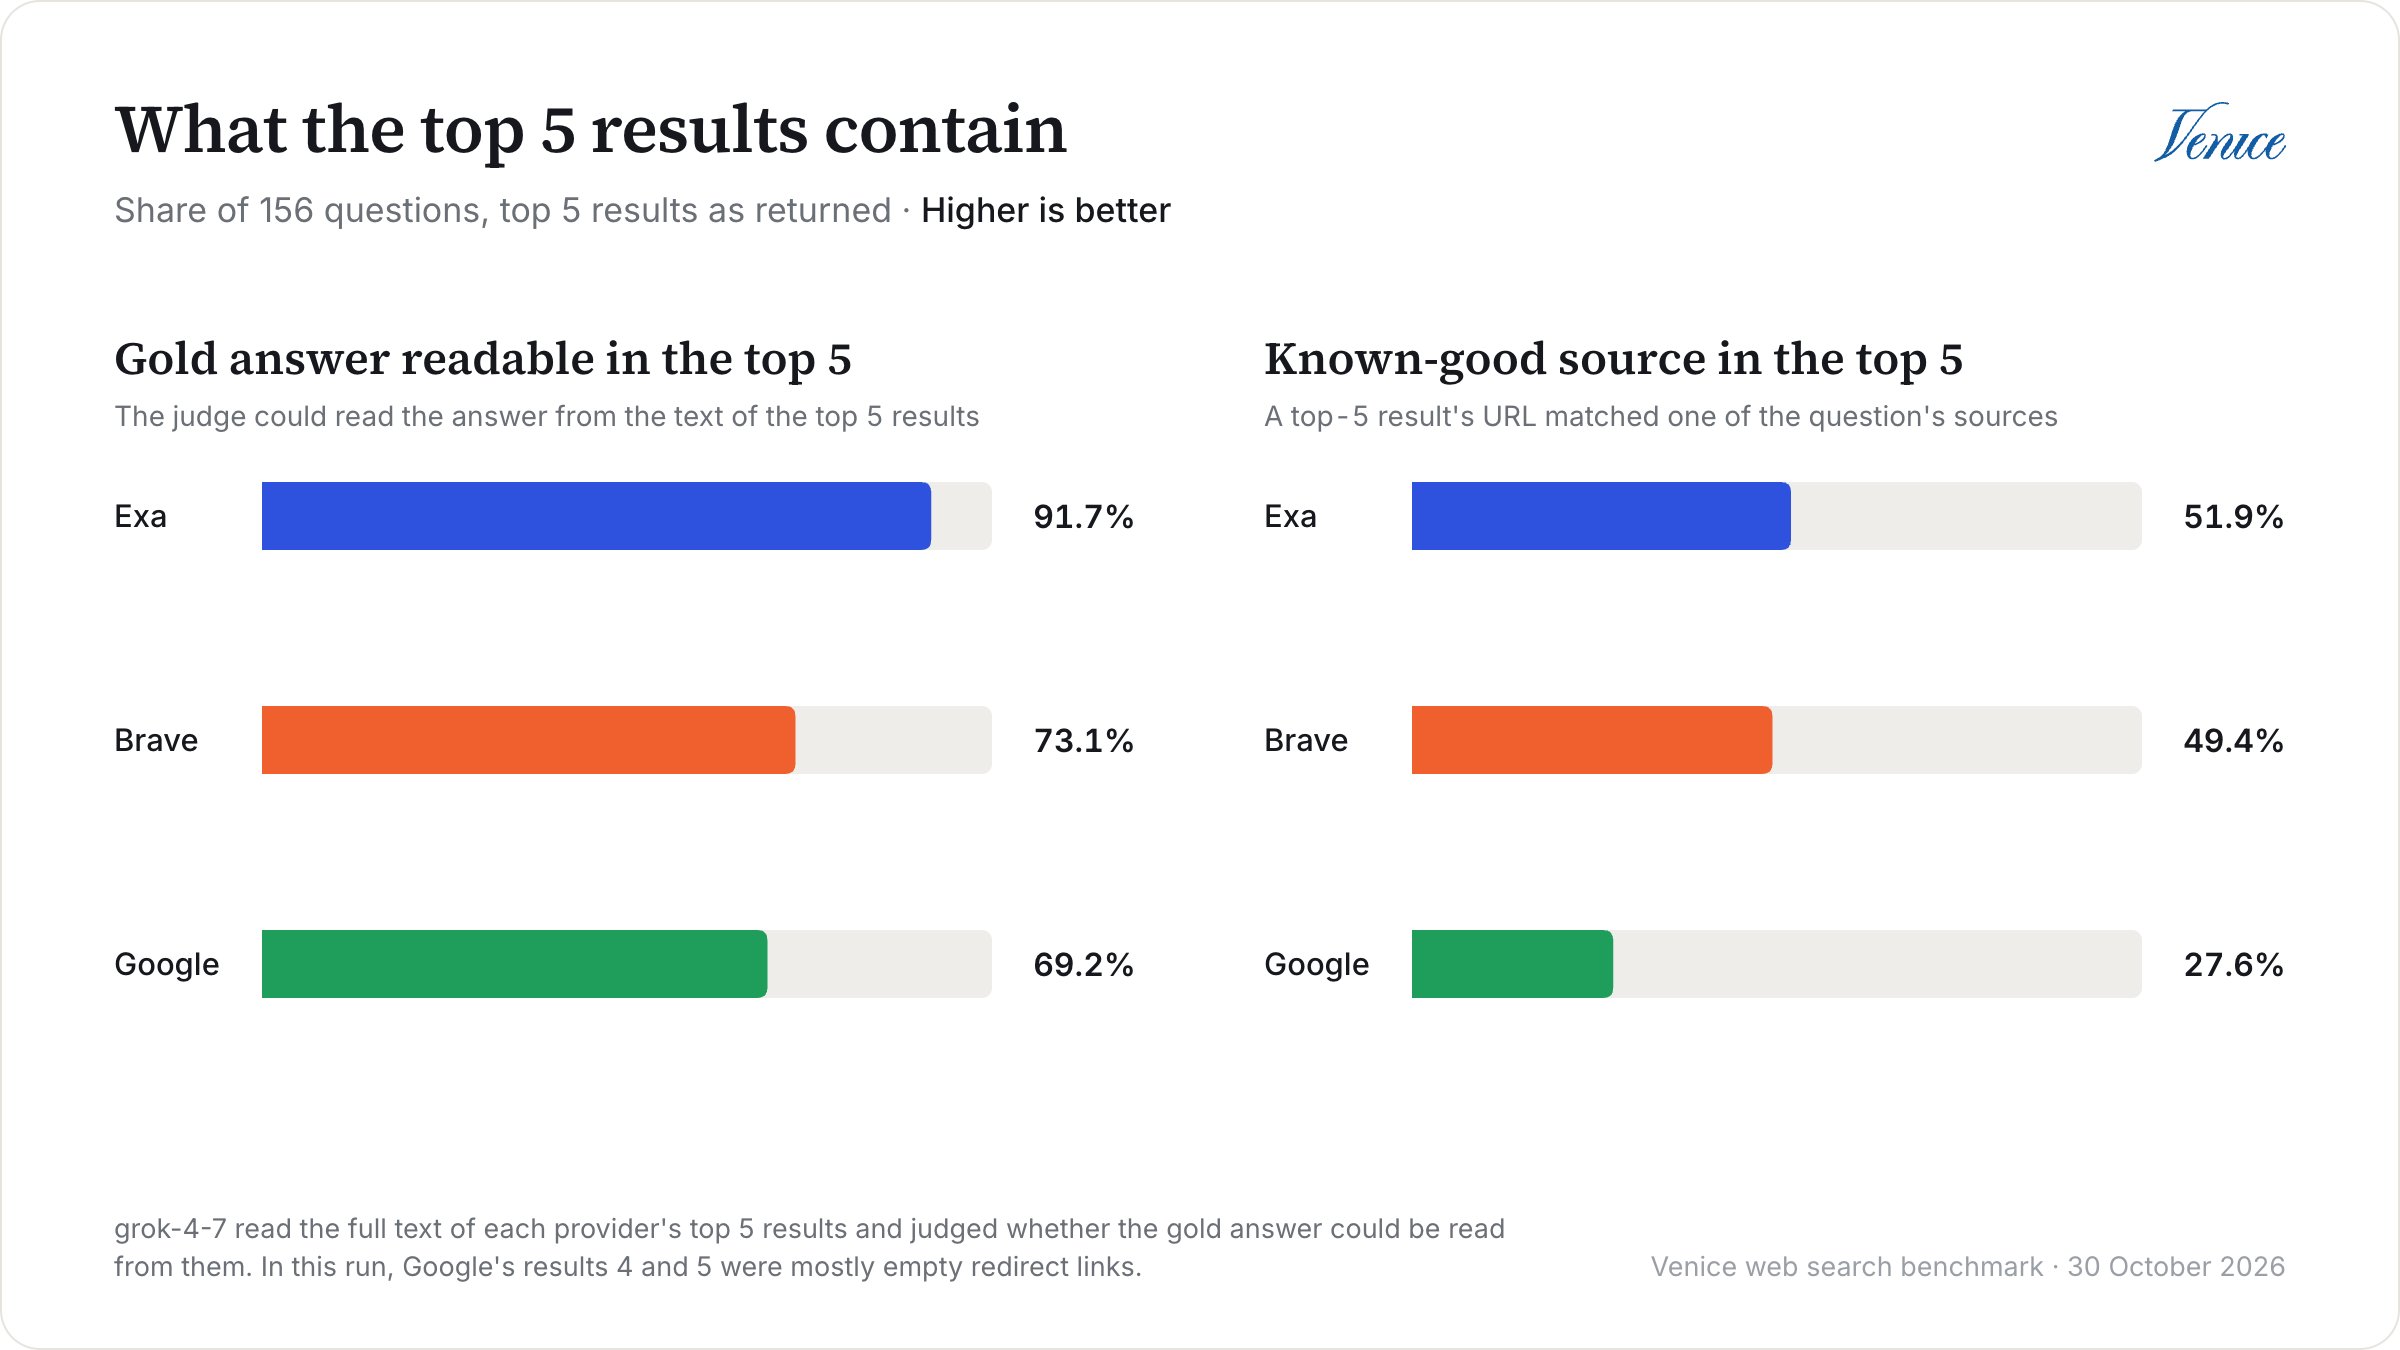
Anche i risultati di Exa sono stati i più pertinenti. Il suo nDCG@5 è stato superiore di 0,15 a quello di Brave (IC 95% da 0,11 a 0,19) e di 0,32 a quello di Google (IC 95% da 0,28 a 0,36), e Brave era 0,17 davanti a Google.
I numeri di Google qui includono però un problema che nel frattempo è stato risolto. In questa esecuzione, i risultati 4 e 5 di Google erano link di reindirizzamento
google.com/goto?url=… in 144 delle 162 ricerche, e la maggior parte non conteneva quasi testo, quindi circa un terzo dei primi 5 risultati di Google era praticamente vuoto. Erano spariti nella nuova esecuzione dell’11 novembre, dove l’nDCG@5 di Google è salito da 0,43 a 0,47 e il suo gold URL hit@5 dal 27,6% al 31,4%. Exa e Brave sono rimasti davanti.
Quel punteggio riguarda però il testo restituito da ciascun provider, non solo le pagine scelte. Quando due provider hanno restituito la stessa pagina, il giudice ha dato lo stesso punteggio a entrambe le copie nel 71% dei casi, e quando i punteggi differivano, la copia più corta ha ottenuto un punteggio più basso nel 69% dei casi. Per separare le due cose, l’harness assegna anche a ogni pagina il voto migliore ottenuto da una qualsiasi sua copia di qualunque provider. Con questa misura per pagina, il vantaggio di Exa su Brave si riduce a 0,09 (IC 95% da 0,05 a 0,13), ma non scompare, ed entrambi hanno scelto pagine migliori di Google. Nota che questo pareggia i conti solo per le pagine restituite da più di un provider. Tutto il resto viene ancora valutato sul testo del provider stesso.
Brave ed Exa costano più o meno uguale, e Google costa di più
La ricerca in sé costa gli stessi $10 per 1.000 query su ogni provider, quindi la differenza di costo deriva dai token che invii al modello dopo. Brave ed Exa sono risultati più o meno uguali, mentre il testo di pagina di Google ha reso i prompt di risposta circa 3,6 volte più grandi di quelli di Brave, il che ha quasi raddoppiato il costo per query. Questi costi usano i prezzi di listino di
zai-org-glm-5-2 senza sconto per la cache, quindi le cifre esatte dipendono dal tuo modello, ma i rapporti tra provider restano validi.
Questa volta Exa è stato il più veloce in mediana, con 0,71 secondi contro 0,97 di Brave, ma non classificheremmo questi due: Brave è stato più veloce nella nostra prima esecuzione, il giorno prima, quando la mediana di Exa era di 1,73 secondi, e di nuovo nella nuova esecuzione dell’11 novembre, con 0,99 secondi contro 1,54. La latenza è misurata lato client tramite l’API di Venice, quindi include il tempo di rete e l’overhead di Venice, e varia tra un’esecuzione e l’altra. Ciò che è rimasto costante in tutte e tre le esecuzioni è che Brave ed Exa sono rimasti entrambi sotto i 2 secondi in mediana, e Google è stato il più lento ogni volta, con 4,52 secondi qui e 5,36 nella nuova esecuzione.
Le domande generali
Le 6 domande generali non hanno una risposta di riferimento, quindi il giudice ha confrontato testa a testa le risposte di ogni coppia di provider, due volte invertendo l’ordine. Le risposte di Exa hanno battuto quelle di Google in 4 casi, ma con solo 6 domande non è qualcosa su cui faremmo affidamento. Il dettaglio completo è nel report.Quindi quale dovresti usare?
In base a questa esecuzione, ecco come sceglieremmo:- Exa, per la maggior parte dei carichi di lavoro che passano i risultati direttamente a un modello, soprattutto assistenti di programmazione e agenti di ricerca. Ha avuto l’accuratezza migliore, o pari alla migliore, in ogni set di domande e i risultati più pertinenti, a un costo per query quasi uguale a quello di Brave.
- Brave, se le tue domande somigliano di più alle nostre domande su notizie e documentazione, dove era alla pari con Exa, o se ti serve soprattutto trovare la pagina ufficiale di qualcosa, cosa che ha fatto quasi con la stessa frequenza di Exa. È il predefinito, ed è veloce ed economico.
- Google, se vuoi il testo della pagina direttamente nella risposta di ricerca, senza uno scraping separato. La maggior parte dei risultati è la pagina completa, ma circa un quarto è solo lo snippet, quando il sito blocca lo scraping. Dovrai mettere in conto token e latenza extra e, se tagli i risultati, conserva i passaggi che corrispondono alla domanda invece dell’inizio di ogni pagina.
Avvertenze
Ci sono alcune cose da tenere a mente prima di trarre troppe conclusioni da questi numeri:- Le domande sono state scelte per richiedere una ricerca. Abbiamo scartato ogni domanda a cui il modello sapeva rispondere da solo, quindi il set è più difficile del traffico quotidiano.
- Le domande le hanno scritte agenti AI. Ognuna è stata verificata rispetto alle fonti e revisionata, ma una risposta di riferimento può comunque essere sbagliata. Se ne trovi una, apri una issue sul repository.
- Le note di rilascio sono una parte consistente del set. Sono 61 delle 156 risposte di riferimento, ed è da lì che viene la maggior parte del vantaggio di Exa, quindi confronta la tabella per set di domande con il tuo carico di lavoro.
- I voti vengono da un modello. Abbiamo esaminato ogni risposta che il giudice non ha segnato come corretta con i risultati così come restituiti, 82 in tutto, più 30 che ha segnato come corrette. Ne cambieremmo 6, tutte da sbagliata a corretta: 3 per Brave, 2 per Google e 1 per Exa. Questo porterebbe Brave all’80,1%, Google al 76,9% ed Exa al 94,2%, quindi la classifica non cambia, ma il giudice tende a essere un po’ severo.
- I risultati di ricerca cambiano. Questi numeri sono un’istantanea di ottobre 2026, e le risposte di riferimento legate al tempo, soprattutto quelle sulle notizie, invecchiano. La nostra esecuzione dell’11 novembre ha mantenuto la stessa classifica per Exa, ma ha spostato Brave rispetto a Google e i punteggi di pertinenza di Google.
- La nostra esecuzione principale ha cercato ogni domanda esattamente come era scritta. Riscrivere le domande come query di ricerca non ha cambiato la classifica nella nostra esecuzione del 10 novembre, ma la riscrittura della tua applicazione potrebbe farlo.
- Abbiamo testato i provider tramite l’API di Venice. Ognuno restituisce i risultati nel proprio formato, quindi questi numeri descrivono le tre opzioni come le restituisce l’API, non i motori di ricerca in generale.
- I punteggi di pertinenza dipendono da quanto testo viene restituito. Un estratto breve può ottenere un punteggio più basso di una copia più lunga della stessa pagina. Il punteggio per pagina corregge questo aspetto per le pagine restituite da più di un provider, ma non per le altre.
- Le condizioni con budget tagliano dalla fine. Una pipeline che sceglie i passaggi per pertinenza tratterebbe i risultati di Google meglio della nostra.
- Un solo modello ha scritto tutte le risposte, e lo stesso modello ha filtrato le domande. Un modello diverso potrebbe sfruttare meglio (o peggio) i risultati lunghi, e potrebbe già conoscere alcune risposte.
Eseguirlo da solo
L’harness è un piccolo progetto Bun e TypeScript senza dipendenze di runtime. Dopo aver clonato il repository, installa le dipendenze di sviluppo ed esegui i test:.env nel repository:
--budget, che per impostazione predefinita è $5. La nostra esecuzione completa è costata $36.10: $4.86 per 486 ricerche, più i token di risposta e del giudice. La stima non considera gli sconti per la cache, quindi risulta più alta, circa $50. Ogni esecuzione scrive un report.md con le tabelle complete alla base di questo articolo, un results.csv con una riga per domanda, provider e condizione, un summary.json e due file con ogni risposta e l’elenco dei risultati di ogni provider.
Se vuoi solo esplorare i nostri numeri, non devi eseguire nulla, perché la cartella results del repository contiene tutto questo per questa esecuzione.
Il vero valore, però, sta nell’eseguirlo sulle tue domande. Scrivile in formato JSON Lines, con un oggetto per domanda:
goldAnswer ricevono comunque i punteggi di recupero, quindi puoi iniziare con un elenco di query reali dai tuoi log e aggiungere le risposte di riferimento in seguito. Prima di fidarti dei numeri sull’accuratezza, però, controlla a quante delle tue domande il modello risponde correttamente con --arms none, perché le domande di cui conosce già la risposta non distingueranno i tuoi provider.