

brave, google, exa 세 가지 검색 제공자 중 하나를 선택할 수 있습니다. 모두 검색당 $0.01로 비용이 같으니, 자연스럽게 실제로 어떤 것을 써야 하는지 궁금해집니다.
이 글에서 그 답을 찾아보겠습니다. 같은 질문 162개를 각 제공자에 보내고, 같은 모델이 각 제공자의 결과로 답변하게 한 뒤, 결과와 답변을 모두 평가하는 벤치마크를 만들었습니다. 질문을 어떻게 골랐는지, 무엇을 발견했는지, 그리고 직접 실행하는 방법을 살펴보겠습니다.
전체 코드가 궁금하다면 GitHub 저장소를 확인하세요. 이번 실행의 모든 답변과 각 제공자의 결과 목록도 들어 있어서, 비용을 들여 실행하지 않고도 결과를 검증할 수 있습니다.
측정한 항목
검색 제공자가 잘할 수 있는 일은 두 가지이며, 둘이 항상 일치하지는 않습니다.- 검색(Retrieval): 결과가 관련성이 있고 실제로 답을 담고 있나요?
- 답변: 그 결과를 모델에 넘겼을 때 모델이 정확하게 답하나요?
POST /augment/search에 보내며, limit은 10으로 설정합니다. 그런 다음 zai-org-glm-5-2가 각 제공자의 결과로 답변하고, grok-4-7이 temperature 0으로 모든 것을 평가합니다. 기준선으로 모델은 검색 없이도 답변합니다.
제공자마다 반환하는 텍스트의 양은 물론 종류도 다르다는 점에 유의하세요. 이번 실행에서 Exa는 검색당 결과 10개를, Brave는 7limit을 어떻게 설정하든 Venice API가 google에 대해 반환하는 개수입니다. 대부분은 페이지 상단부터 시작하는 전체 텍스트로, 내비게이션과 쿠키 배너까지 모두 포함되어 있었습니다. 하지만 전부는 아닙니다. Reddit, Facebook, Stack Overflow, YouTube처럼 사이트가 스크래핑을 차단하면 결과는 검색 스니펫뿐입니다. 11월 11일에 다시 실행했을 때 Google 상위 5개 결과 중 4분의 1은 텍스트가 300자 미만이었습니다. 평균적으로 결과당 약 9,700자, 검색당 48,000자였으며, Brave와 Exa는 약 14,000자였습니다. 텍스트가 많으면 더 나은 답변을 얻을 수도 있지만, 요청마다 입력 토큰도 늘어납니다. 양이 얼마나 중요한지 보기 위해 모델은 각 제공자의 결과로 세 가지 방식으로 답변합니다.
예산이 있는 두 조건에서는 모든 제공자가 같은 개수의 결과와 같은 공간을 받습니다. 하네스는 각 결과의 앞부분을 유지하므로, 이 조건들은 결과를 잘라 낼 때 각 제공자의 결과가 얼마나 잘 버티는지도 테스트합니다. 실제 파이프라인 상당수가 이렇게 합니다.
질문
이 벤치마크의 첫 번째 버전에는 문제가 있었습니다. 검색 없이도 모델이 채점 가능한 질문의 72%를 이미 맞혀서, 세 제공자가 거의 비슷해 보였습니다. 모델이 이미 답을 알고 있다면 검색은 큰 차이를 만들 수 없고, 어떤 제공자가 더 나은지도 알려 줄 수 없습니다. 그래서 이번 실행에서는 답이 반드시 검색에서 나와야 하는, 정답이 있는 질문 156개를 모았습니다.
코딩 질문은 붙여 넣은 오류 메시지부터 “Which ripgrep version started respecting the GIT_CONFIG_GLOBAL environment variable?”처럼 특정 버전을 묻는 질문까지 여러 형태로 구성했습니다. 의도한 것입니다. 자연어에는 강한 검색 엔진도 오류 문자열에서는 무너질 수 있습니다. 또한 긴 대화형 질문처럼 정답이 없는 일반 질문 6개가 있는데, 이는 뒤에서 다시 다루겠습니다.
정답이 있는 모든 질문은 채택되기 전에 같은 검증을 거쳤습니다. 각 질문은 릴리스 노트나 공식 보도 자료 같은 1차 출처를 바탕으로 AI 에이전트가 초안을 작성했고, 스크립트가 모든 출처를 가져와 정답의 근거가 되는 인용문이 실제로 페이지에 있는지 확인했습니다. 그런 다음 모델이 검색 없이 각 질문에 두 번 답하게 했고, 한 번이라도 맞힌 질문은 제외했습니다.
뉴스와 민감한 주제 질문에서는 출처 인용문을 검색 결과로 모델에 제공하고, 두 번 모두 정확히 답한 질문만 남겼습니다. 이렇게 하면 모호한 질문을 걸러 내고, 모델이 출처를 가지고 있을 때 민감한 질문에도 답하는지 확인할 수 있습니다. 마지막으로 다른 에이전트가 모든 질문과 정답을 출처와 대조해 다시 검토했고, 그 결과 47건을 수정하고 3개를 추가로 제외했으며, 수정된 질문은 모두 검색 없는 선별 과정을 다시 거쳤습니다.
이 때문에 검색 없는 기준선은 설계상 거의 0에 가깝습니다. 따라서 검색이 일반적으로 얼마나 자주 도움이 되는지는 알려 주지 않습니다. 대신 세트의 모든 질문에 검색이 필요하다는 것을 알려 주며, 이는 검색 제공자를 비교할 때 정확히 원하는 조건입니다.
지표
정확도에는 95% 신뢰 구간이 함께 표시되며, 제공자 간 차이는 같은 질문에 대한 쌍대 비교, 즉 bootstrap 구간과 정확 McNemar 검정에서 나옵니다. 정답이 156개이므로 질문 하나는 약 0.6퍼센트포인트에 해당하고, 정확도의 구간은 최대 약 ±7포인트이므로, 작은 차이를 해석하기 전에 쌍대 비교를 확인하는 것이 좋습니다.
결과
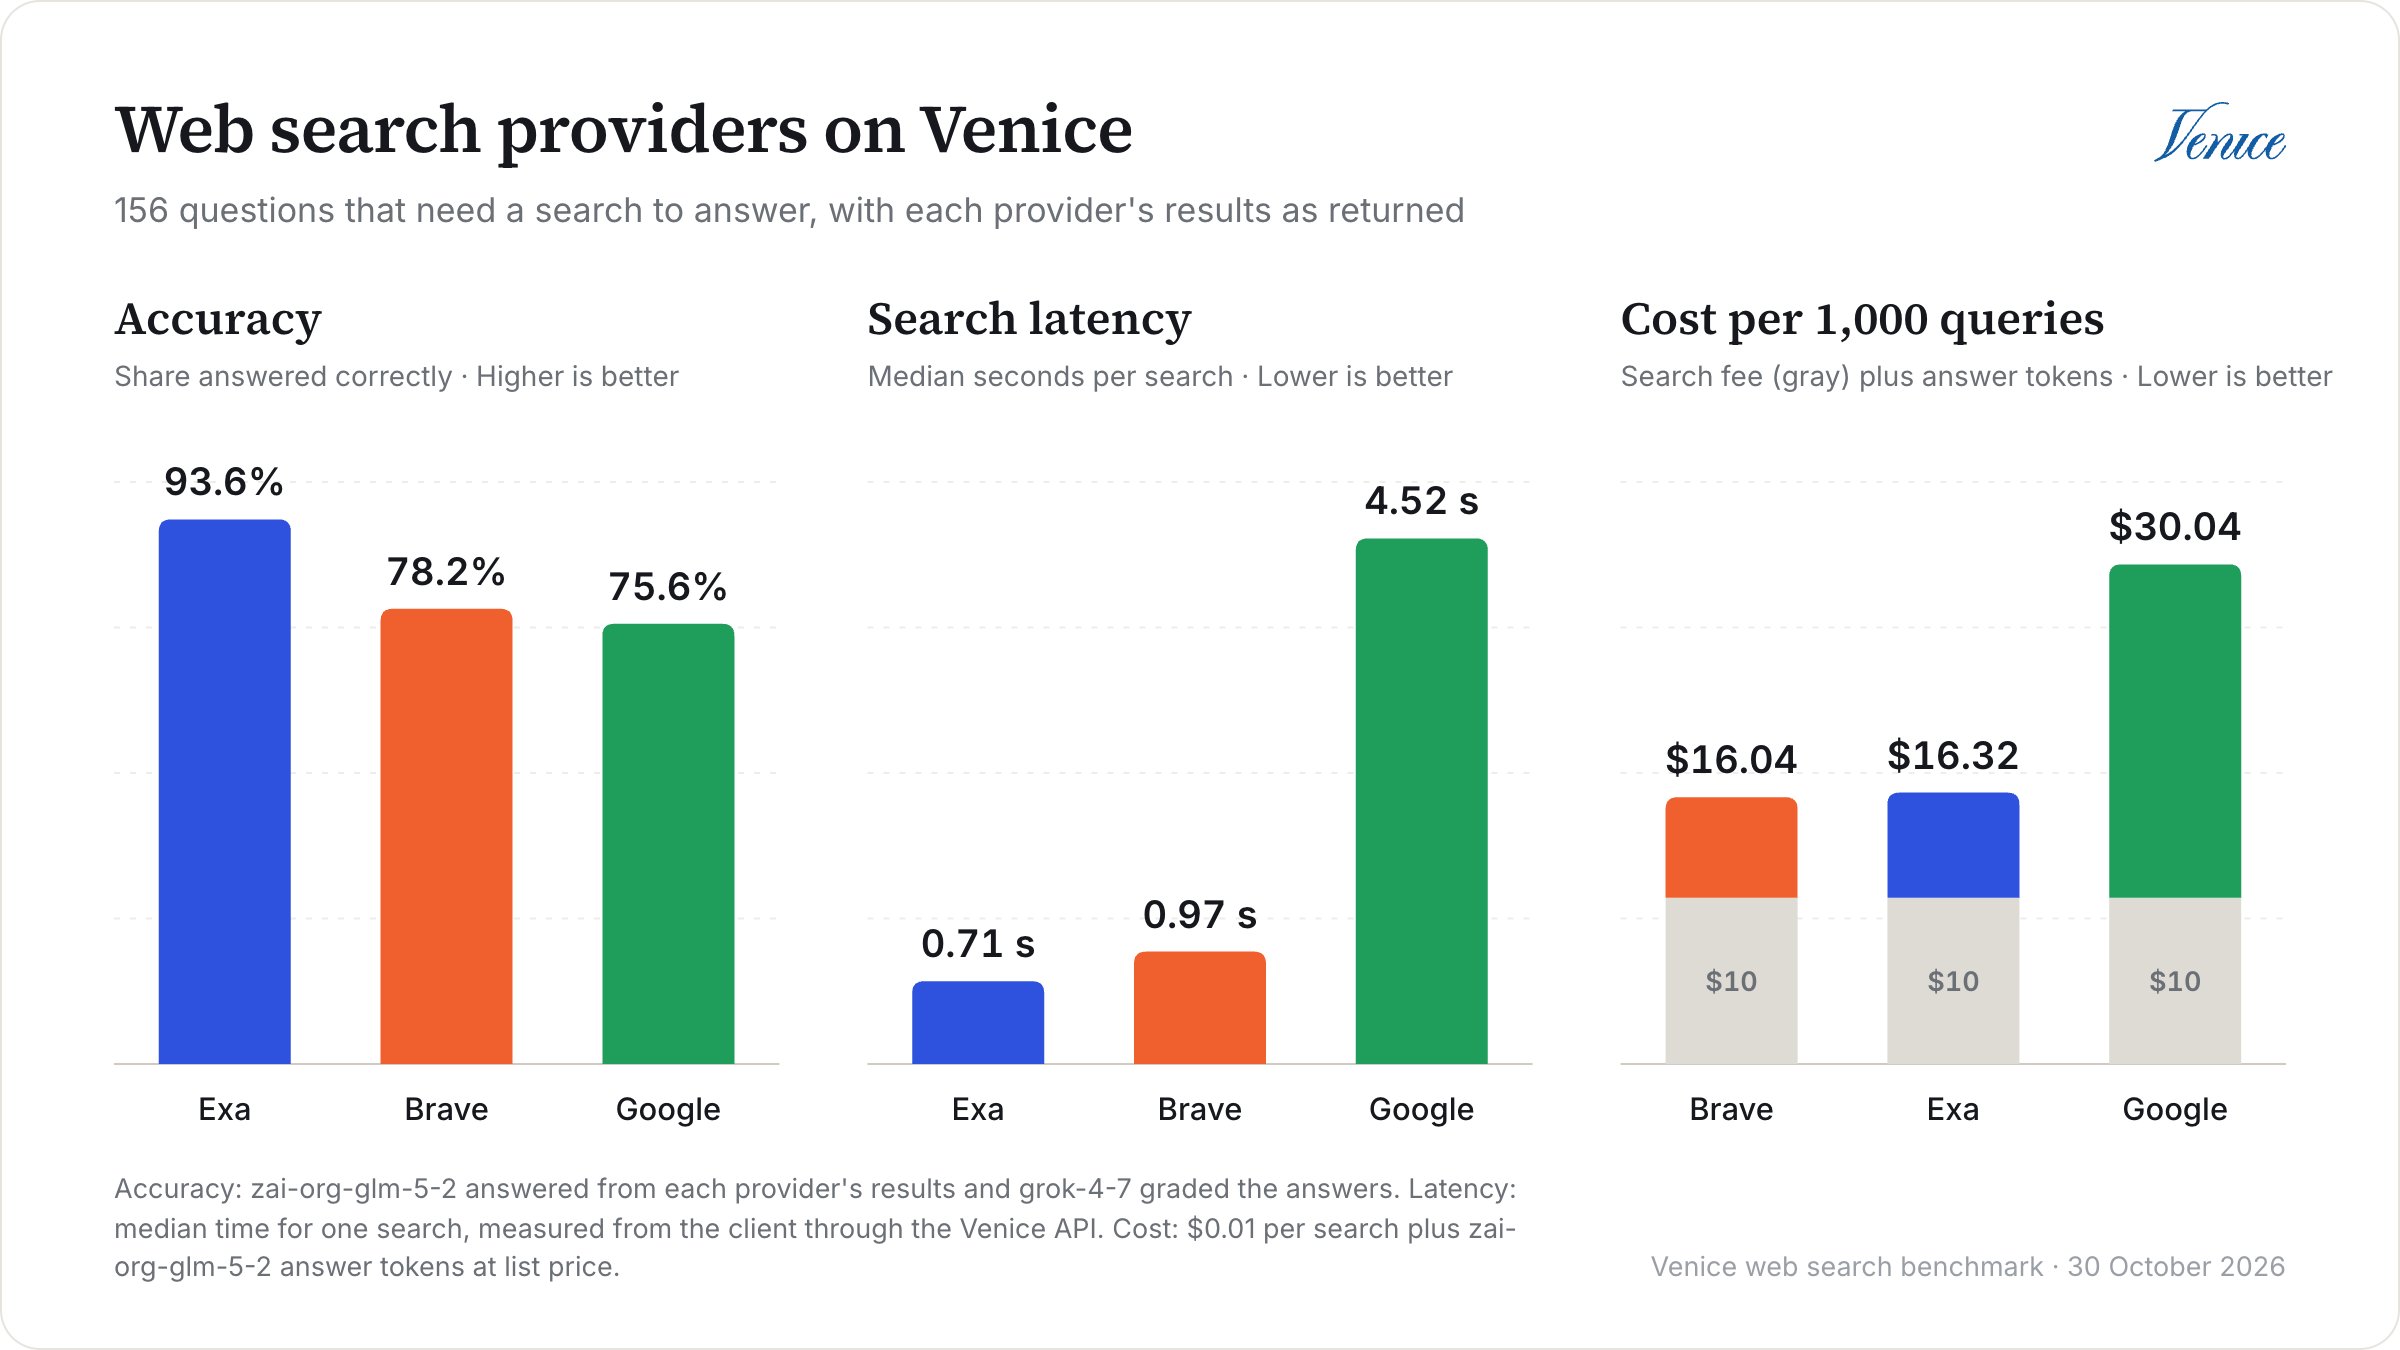
Exa가 가장 많은 질문에 정확히 답했습니다
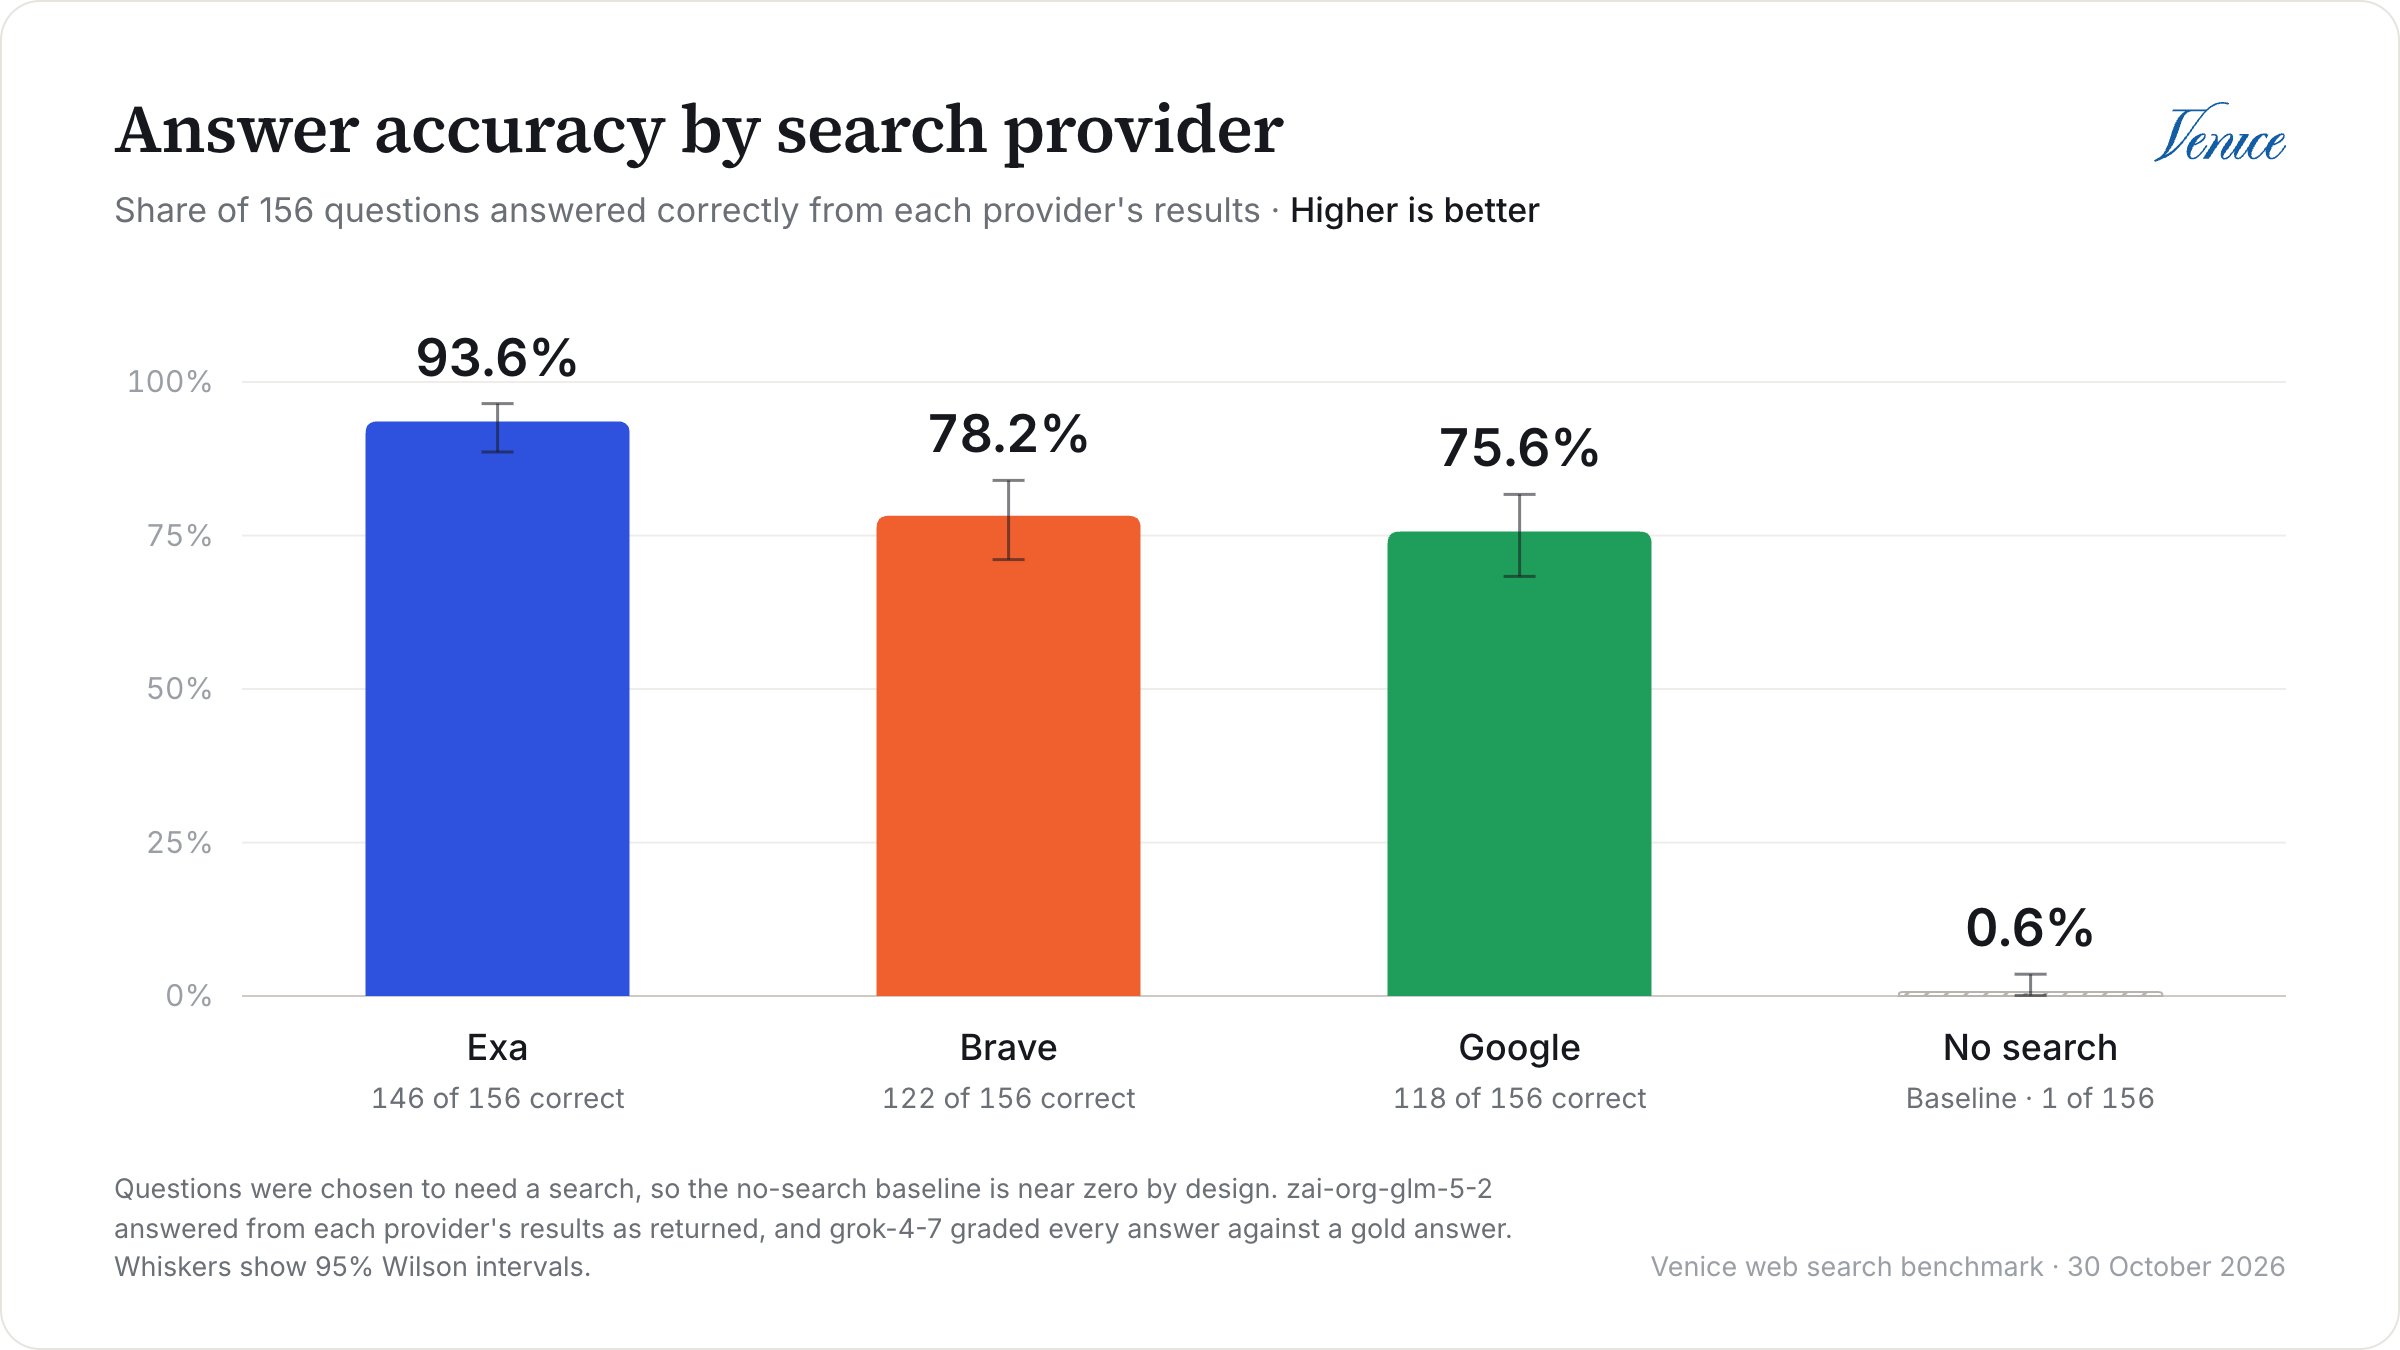
반환된 결과를 모두 그대로 사용했을 때 Exa는 질문의 93.6%에 정확히 답해 Brave보다 약 15포인트, Google보다 18포인트 앞섰습니다. 이번에는 차이가 분명합니다. Exa는 Brave가 틀린 28개 질문을 맞혔고 반대는 4개뿐이었으며, Google이 틀린 33개 질문을 맞혔고 반대는 5개였습니다(두 경우 모두 McNemar p < 0.001).
일회성 결과가 아닌지 확인하기 위해 11월 11일에 같은 설정으로 전체 벤치마크를 다시 실행했으며, 그 결과도 저장소에 있습니다. Exa가 다시 1위를 차지해 93.6%를 기록했고 Brave는 81.4%, Google은 72.4%였으며, Exa는 Brave를 12.2포인트 앞섰습니다(24개 질문 대 5개, p = 0.001).
Brave와 Google의 비교는 덜 명확합니다. 이번 실행에서 둘은 22개 질문 대 18개로 비슷했는데, 이는 충분히 잡음 범위 안에 있습니다. 재실행에서는 Brave가 29개 질문 대 15개로 앞섰습니다(9.0포인트, p = 0.049). 따라서 실행에 따라 Brave는 Google과 비슷하거나 앞섰습니다.
또한 Exa의 우위가 질문의 표현 방식에서 오는지도 알고 싶었습니다. 질문을 작성된 그대로 검색했지만, 실제 애플리케이션은 보통 질문을 먼저 검색 쿼리로 바꿔 쓰기 때문입니다. 그래서 11월 10일의 또 다른 재실행에서는 모델이 각 질문을 검색 엔진 쿼리로 한 번 바꿔 쓰게 하고, 같은 쿼리를 세 제공자 모두에 보낸 뒤 원래 질문에 대한 답변을 평가했습니다. Exa는 여전히 Brave를 13.5포인트 앞섰고(24개 질문 대 3개), 어떤 제공자의 점수도 유의미하게 바뀌지 않았으므로, 표현 방식은 Exa의 우위를 설명하지 못합니다.
검색 없는 답변도 살펴볼 만합니다. 검색 없이 모델은 429 이후 Venice의
x-ratelimit-reset-requests 대신 Retry-After 헤더를 읽으라고 했고, 모델 이름으로 웹 검색을 켜는 -web-search 접미사를 지어냈으며, 존재하지 않는 venice 검색 제공자를 언급했습니다. 사용자가 새롭거나 틈새 API에 관해 묻는다면 모델 자체의 지식만으로는 부족합니다.
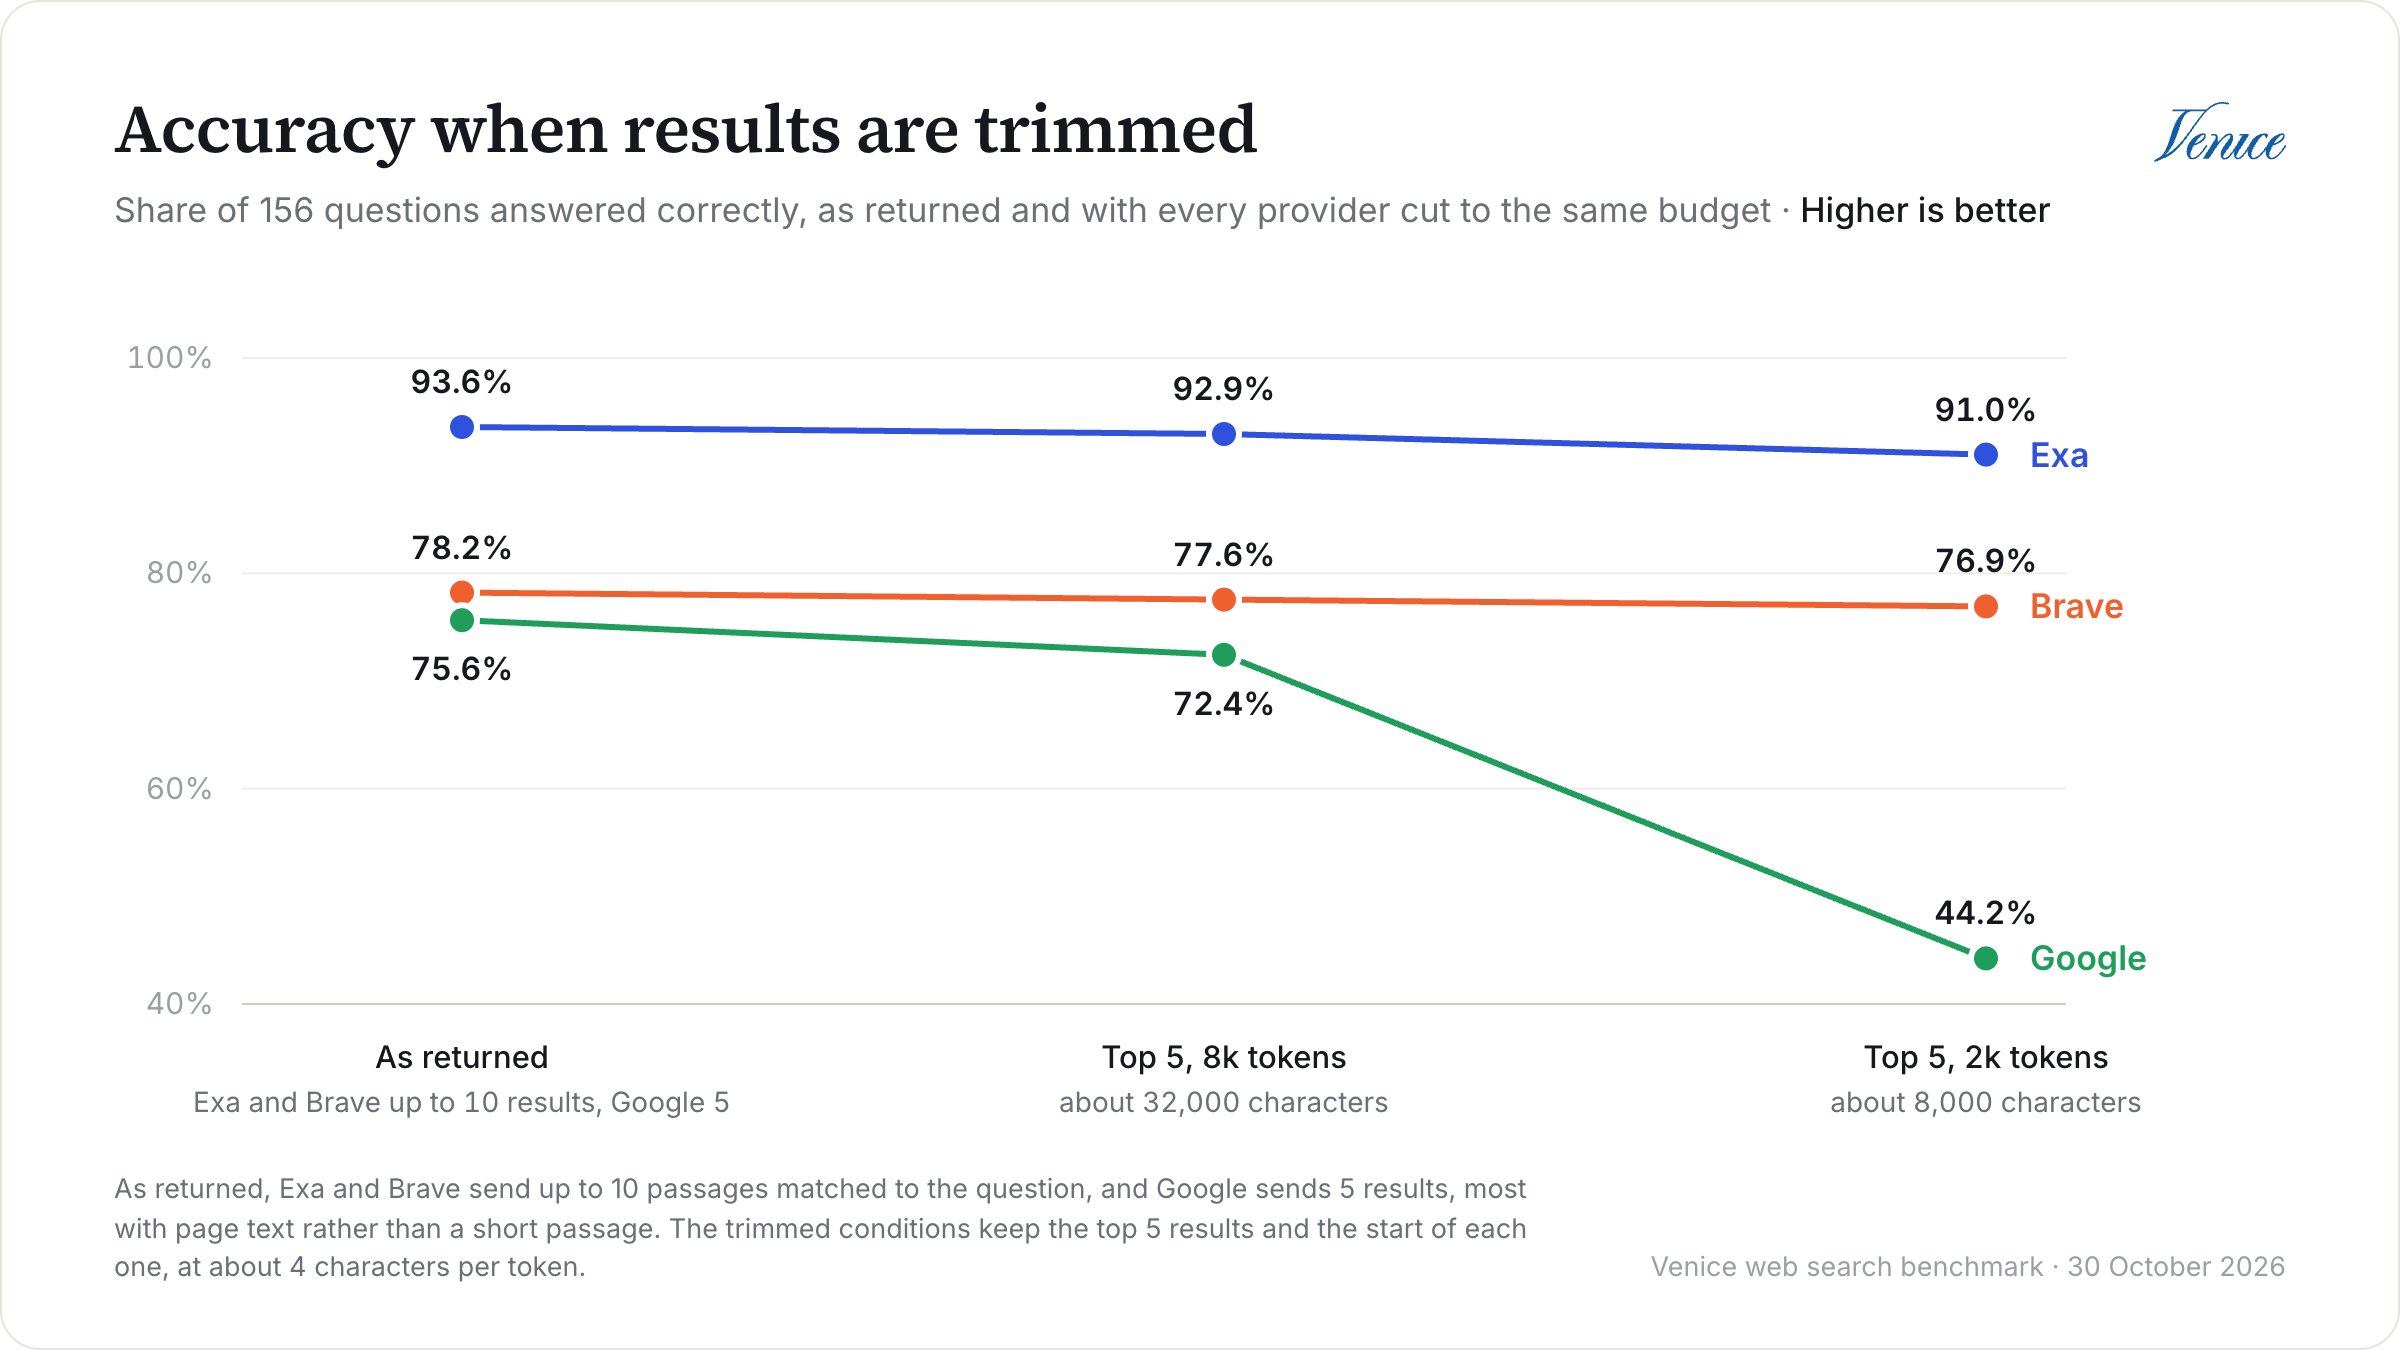
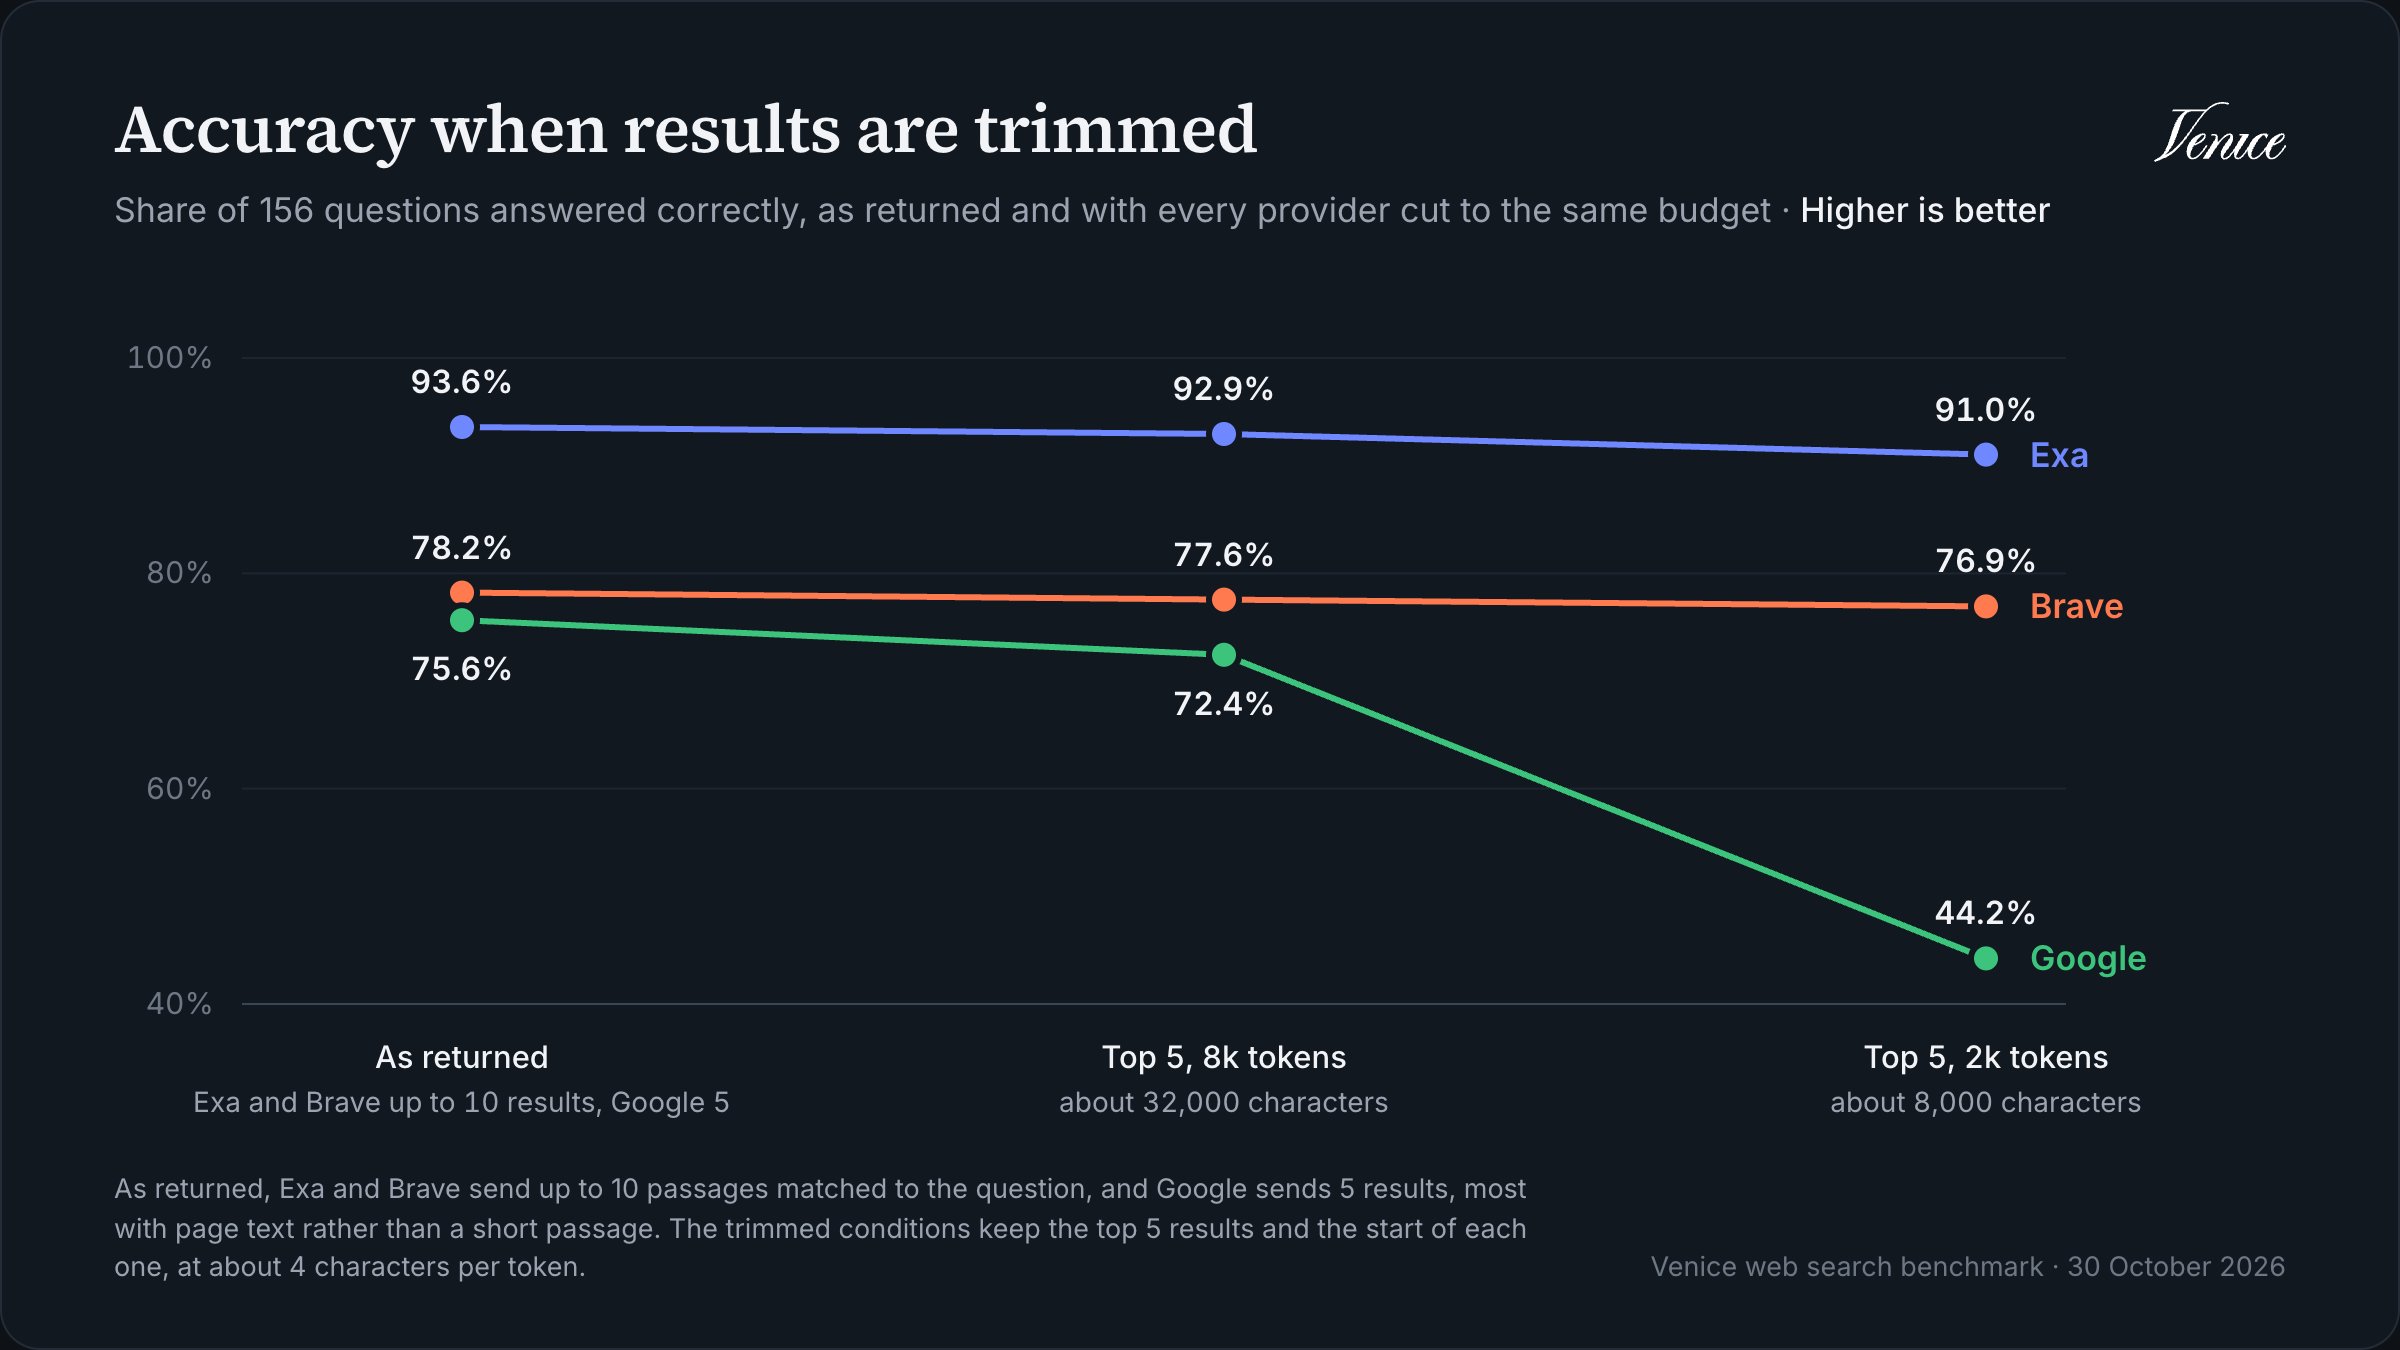
예산이 있는 조건에서 Google이 크게 뒤처집니다. 2,000토큰에서 정확도는 44.2%로 떨어졌고, 모델은 질문의 30%에서 답을 찾지 못했습니다. Google의 전체 결과를 사용했을 때는 10%였습니다. Google의 결과는 페이지 상단부터 시작하므로, 잘라 내면 내비게이션과 배너는 남고 질문에 답하는 부분은 잘려 나갔습니다. Brave와 Exa의 결과는 이미 질문에 맞춘 구절이므로 잘라 내도 거의 차이가 없었습니다. 8,000토큰에서는 Google이 72.4%까지 대부분 회복했습니다.
Exa의 우위는 어디에서 오는가
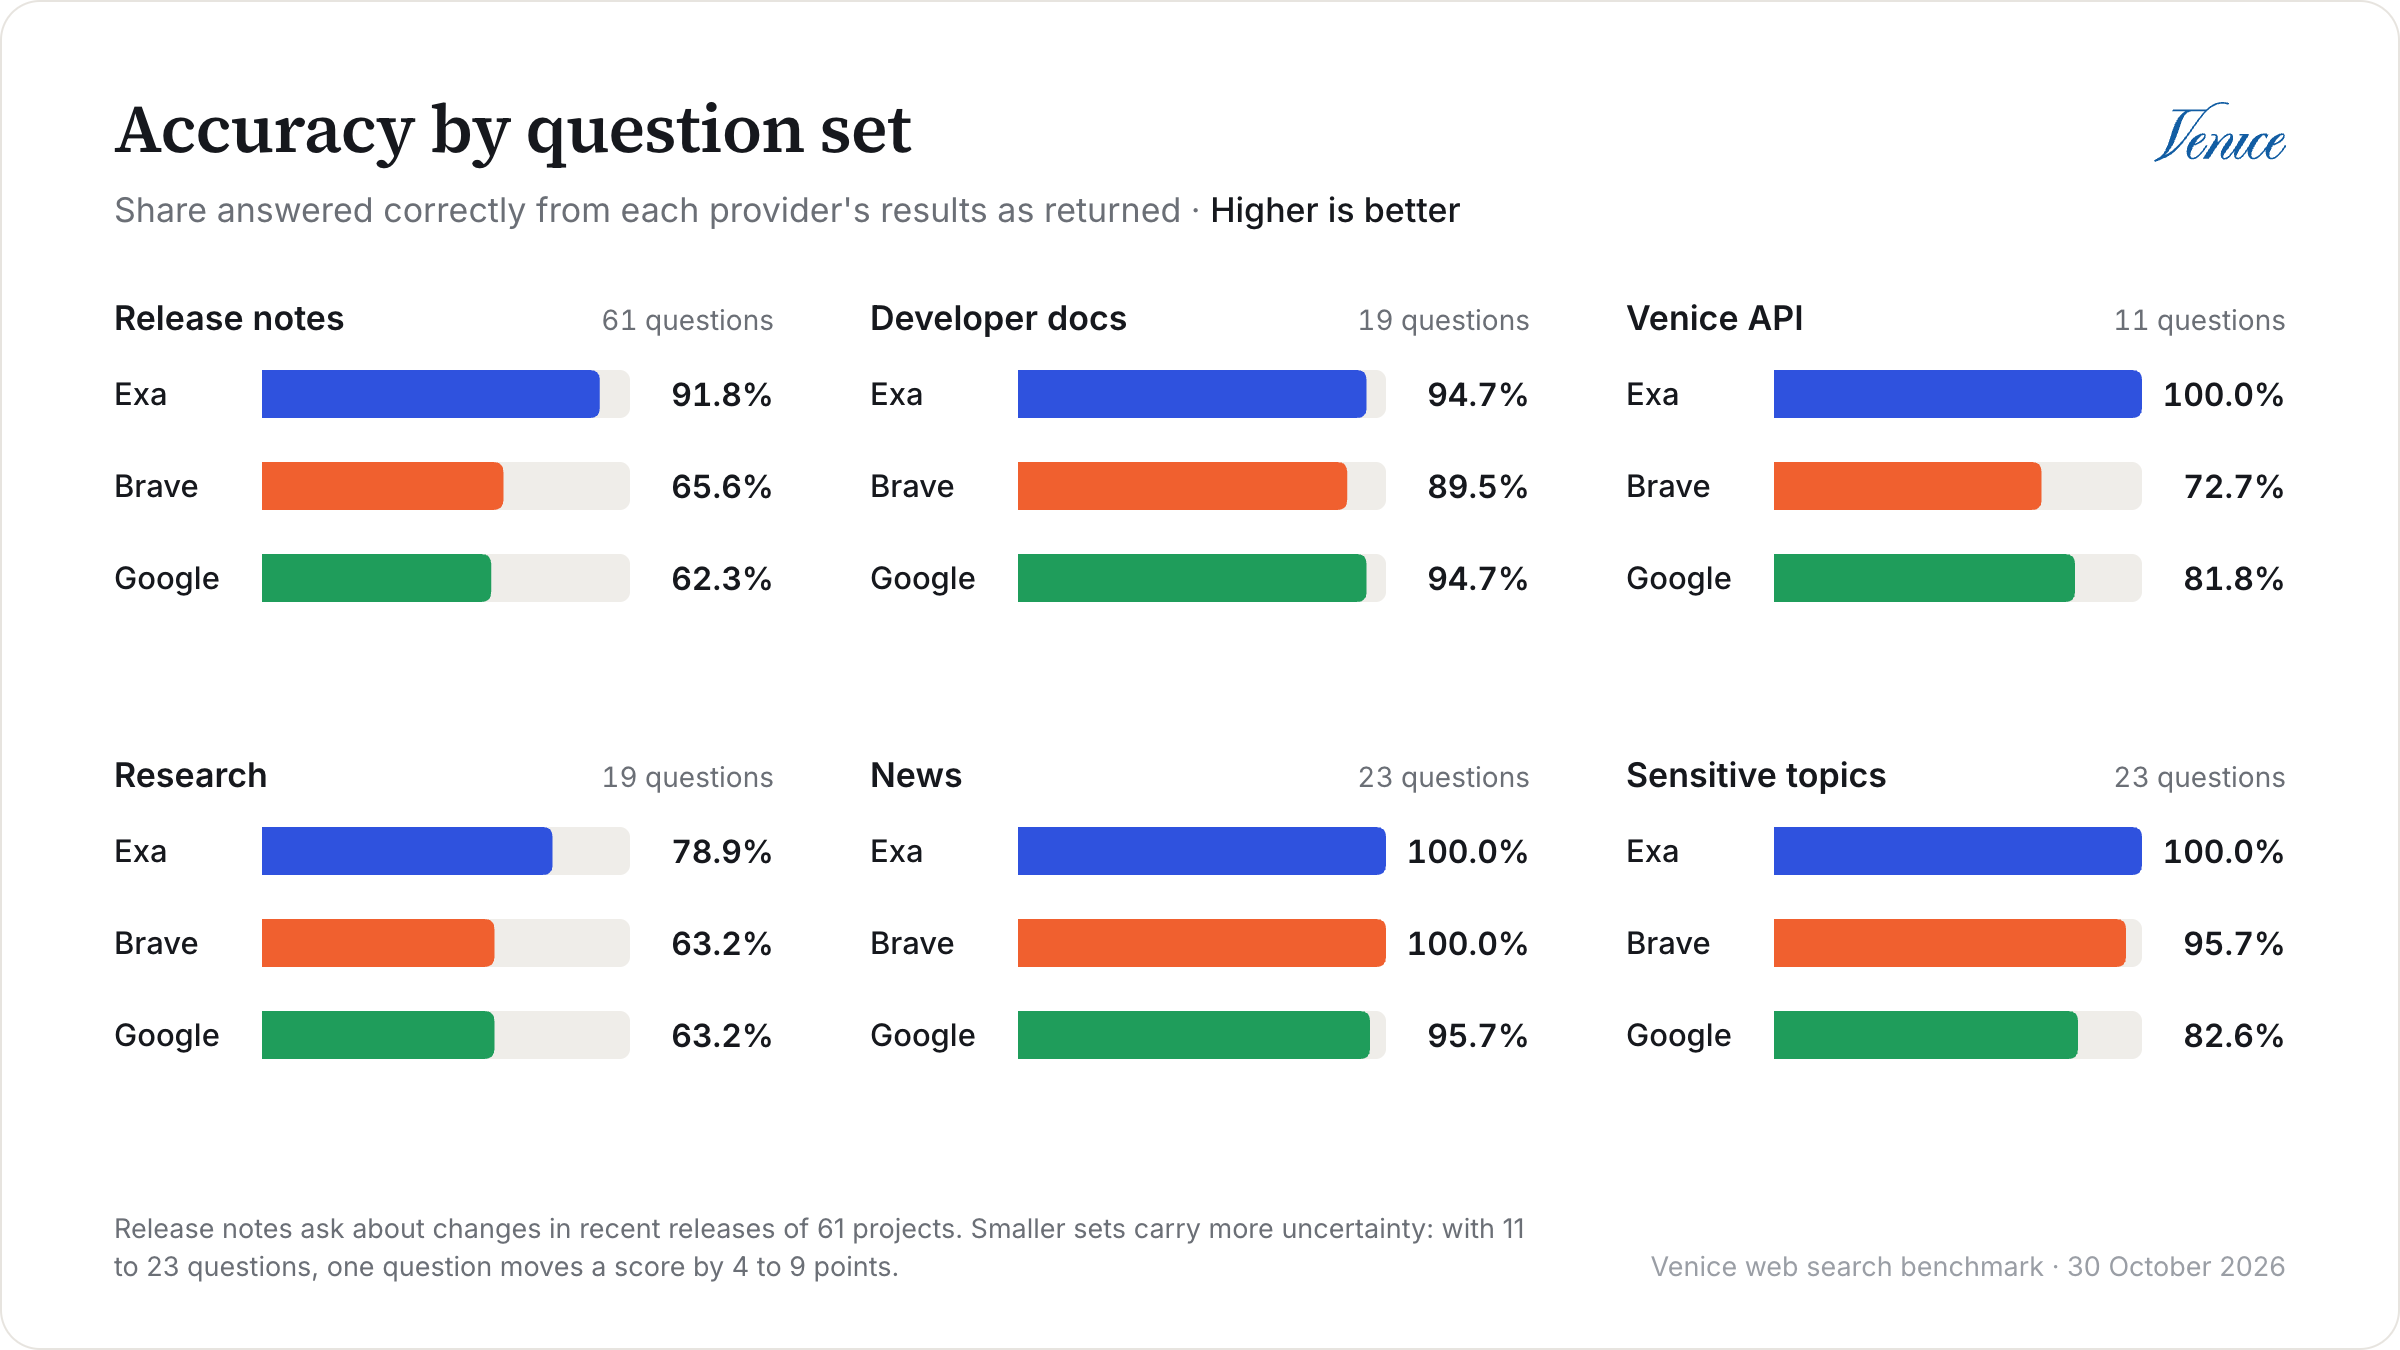
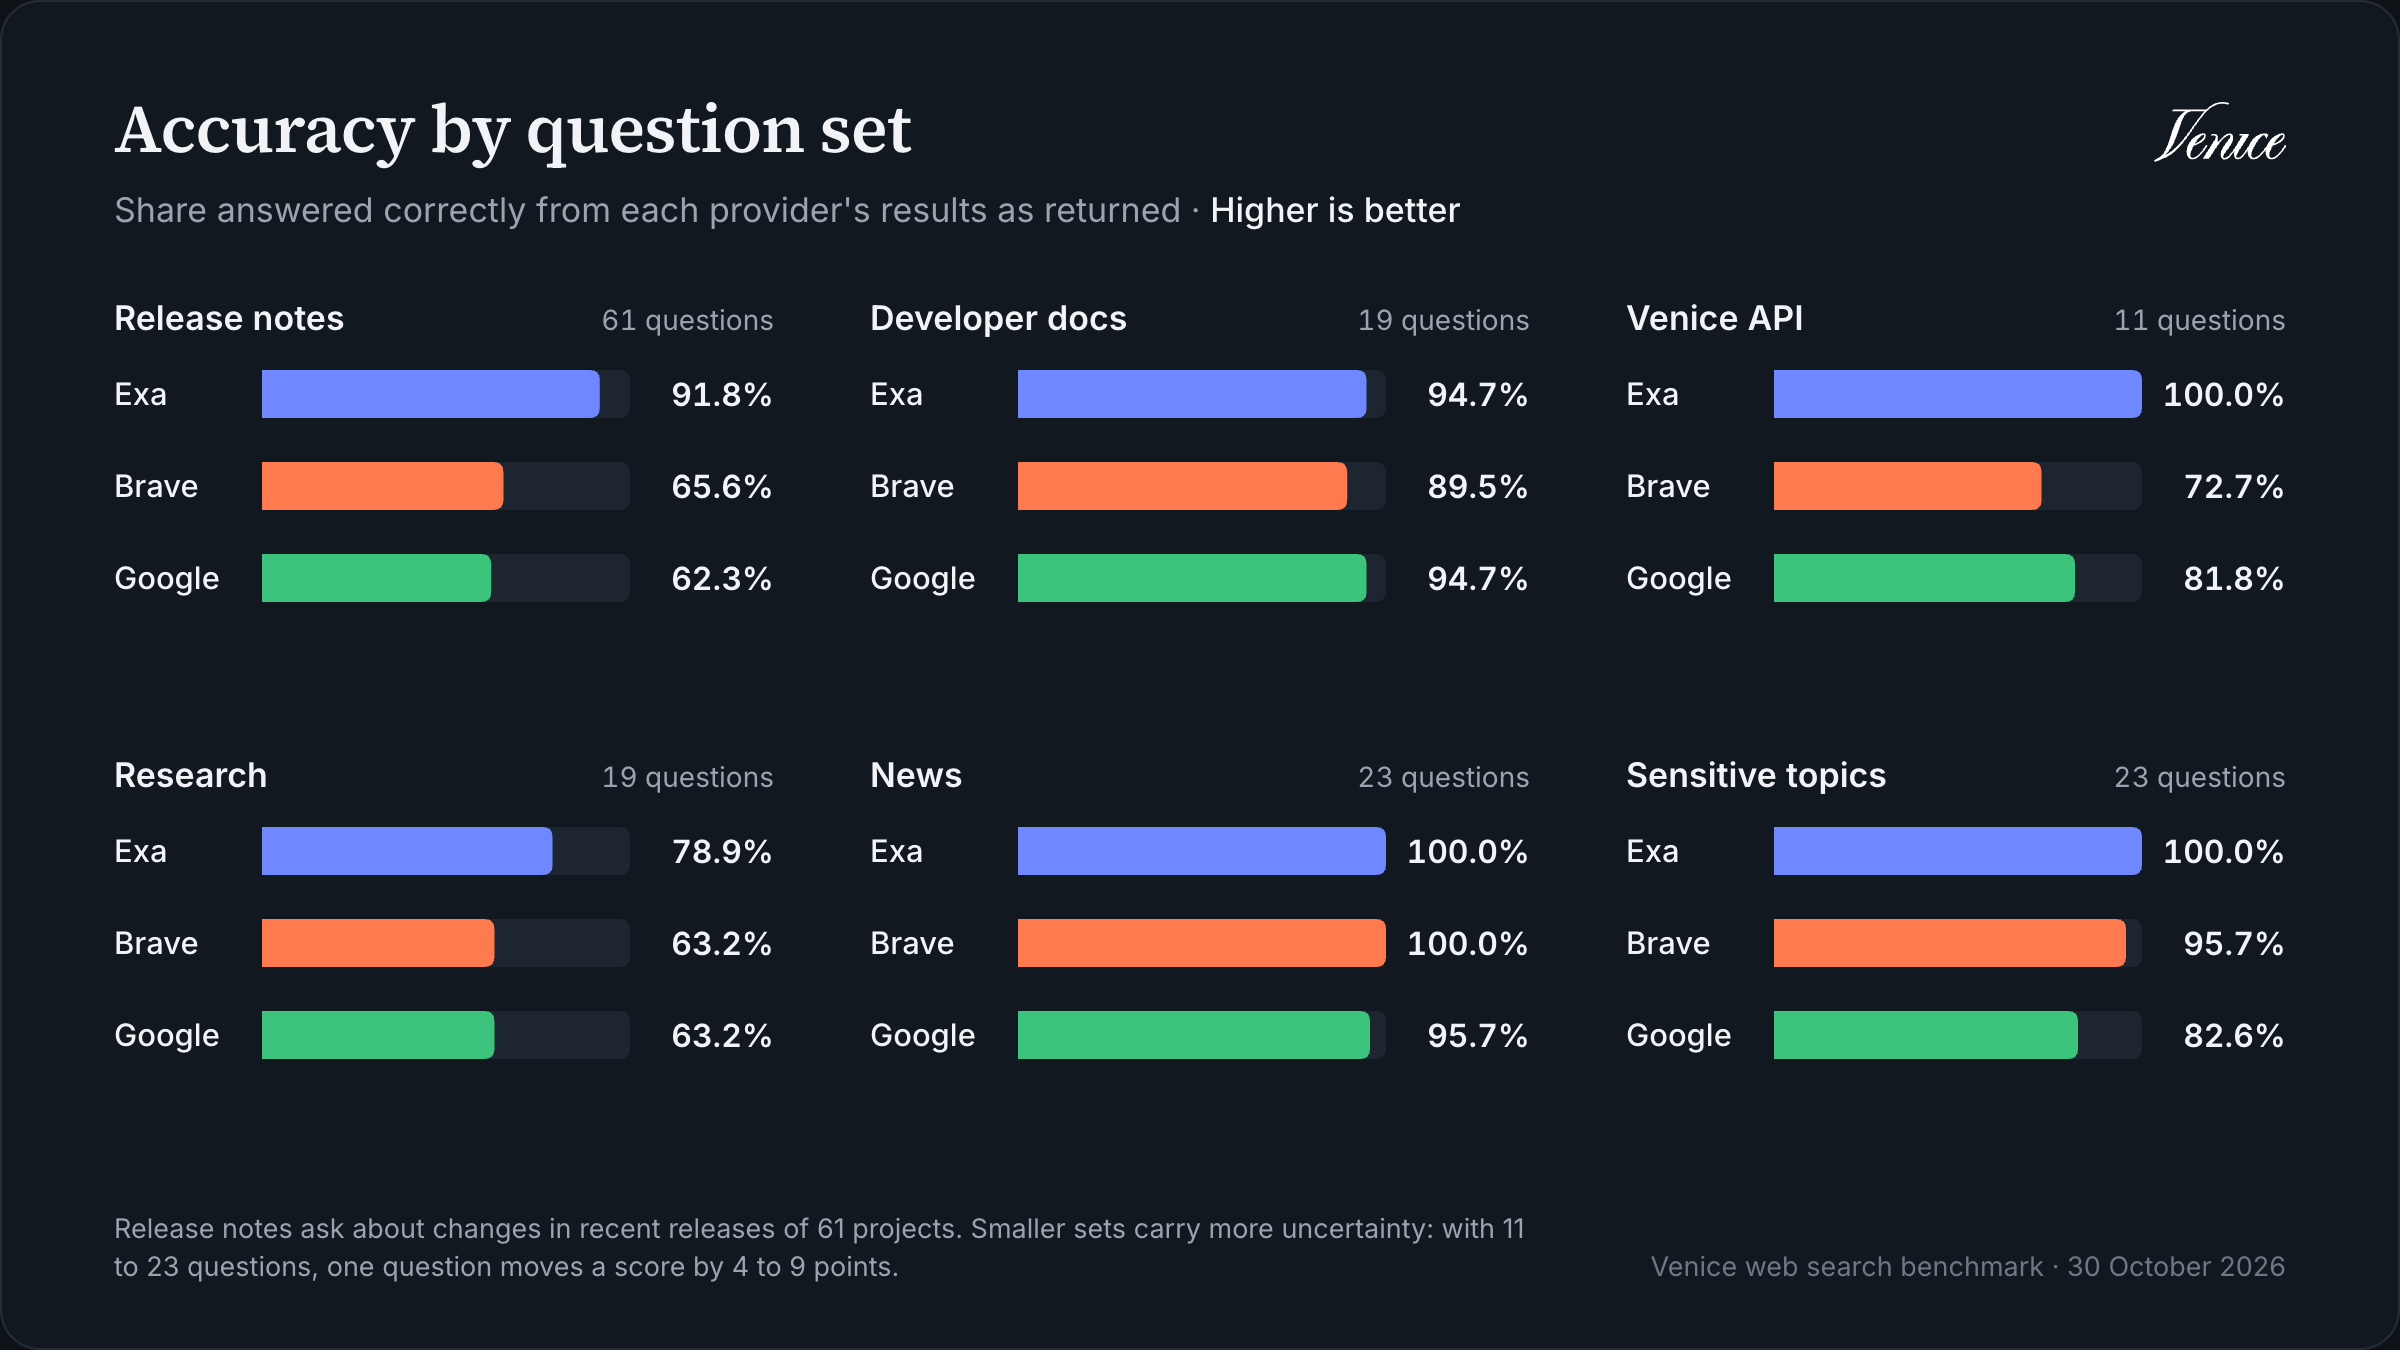
차이의 대부분은 한 곳, 즉 릴리스 노트에서 나옵니다. Exa는 릴리스 질문 61개 중 56개에 정확히 답했고, Brave는 40개, Google은 38개였습니다. 이런 질문의 답은 보통 changelog의 한 줄에 있으며, Exa의 결과는 그 줄을 포함할 가능성이 훨씬 높았습니다. 플래그나 환경 변수처럼 알려진 식별자가 있는 릴리스 질문에서 Exa의 결과는 그중 97%를 글자 그대로 포함했고, Brave는 76%, Google은 68%였습니다. 모든 코딩 세트의 특정 버전을 묻는 질문에서 Exa는 95%를 맞혔고 나머지 둘은 55%였습니다.
리서치 질문은 서로 다른 두 페이지에서 두 가지 사실을 찾아야 하므로 모두에게 가장 어려웠고, Exa조차 19개 중 15개만 맞혔습니다. 반면 뉴스와 개발자 문서에서는 세 제공자 모두 거의 전부 답했습니다. 사용자의 질문이 이런 유형이라면 어떤 제공자를 고르는지는 훨씬 덜 중요합니다.
민감한 주제는 어떨까요?
일부 검색 서비스는 민감한 주제의 결과를 필터링하거나 뒤로 밀어내므로, 세 제공자 중 그런 곳이 있는지 확인하기 위해 질문 23개를 추가했습니다. 마약 관련 법, 낙태, 성노동, 총기, 감시, 인터넷 차단 같은 주제를 다루며, 각 질문에는 법원 판결이나 정부 고시 같은 공식 출처의 사실적인 답이 있습니다. 어느 제공자도 이 질문들에서 빈 결과나 오류를 반환하지 않았고, 모델도 주제 때문에 답변을 거부한 적이 없습니다. Exa는 23개 모두, Brave는 22개, Google은 19개를 맞혔습니다. 틀린 경우는 결과에 사실이 없거나 다른 날짜가 있는 평범한 검색 실패였으며, 예외적으로 Google 답변 하나는 확신 없이 말했지만 올바른 날짜를 제시했는데 평가자가 너무 엄격하게 판정했습니다. 질문 23개로는 필터링을 보지 못했다는 것만 보여 줄 수 있을 뿐, 어디에도 필터링이 없다는 것을 보여 주지는 못한다는 점에 유의하세요.Exa가 가장 유용한 텍스트를 반환했습니다
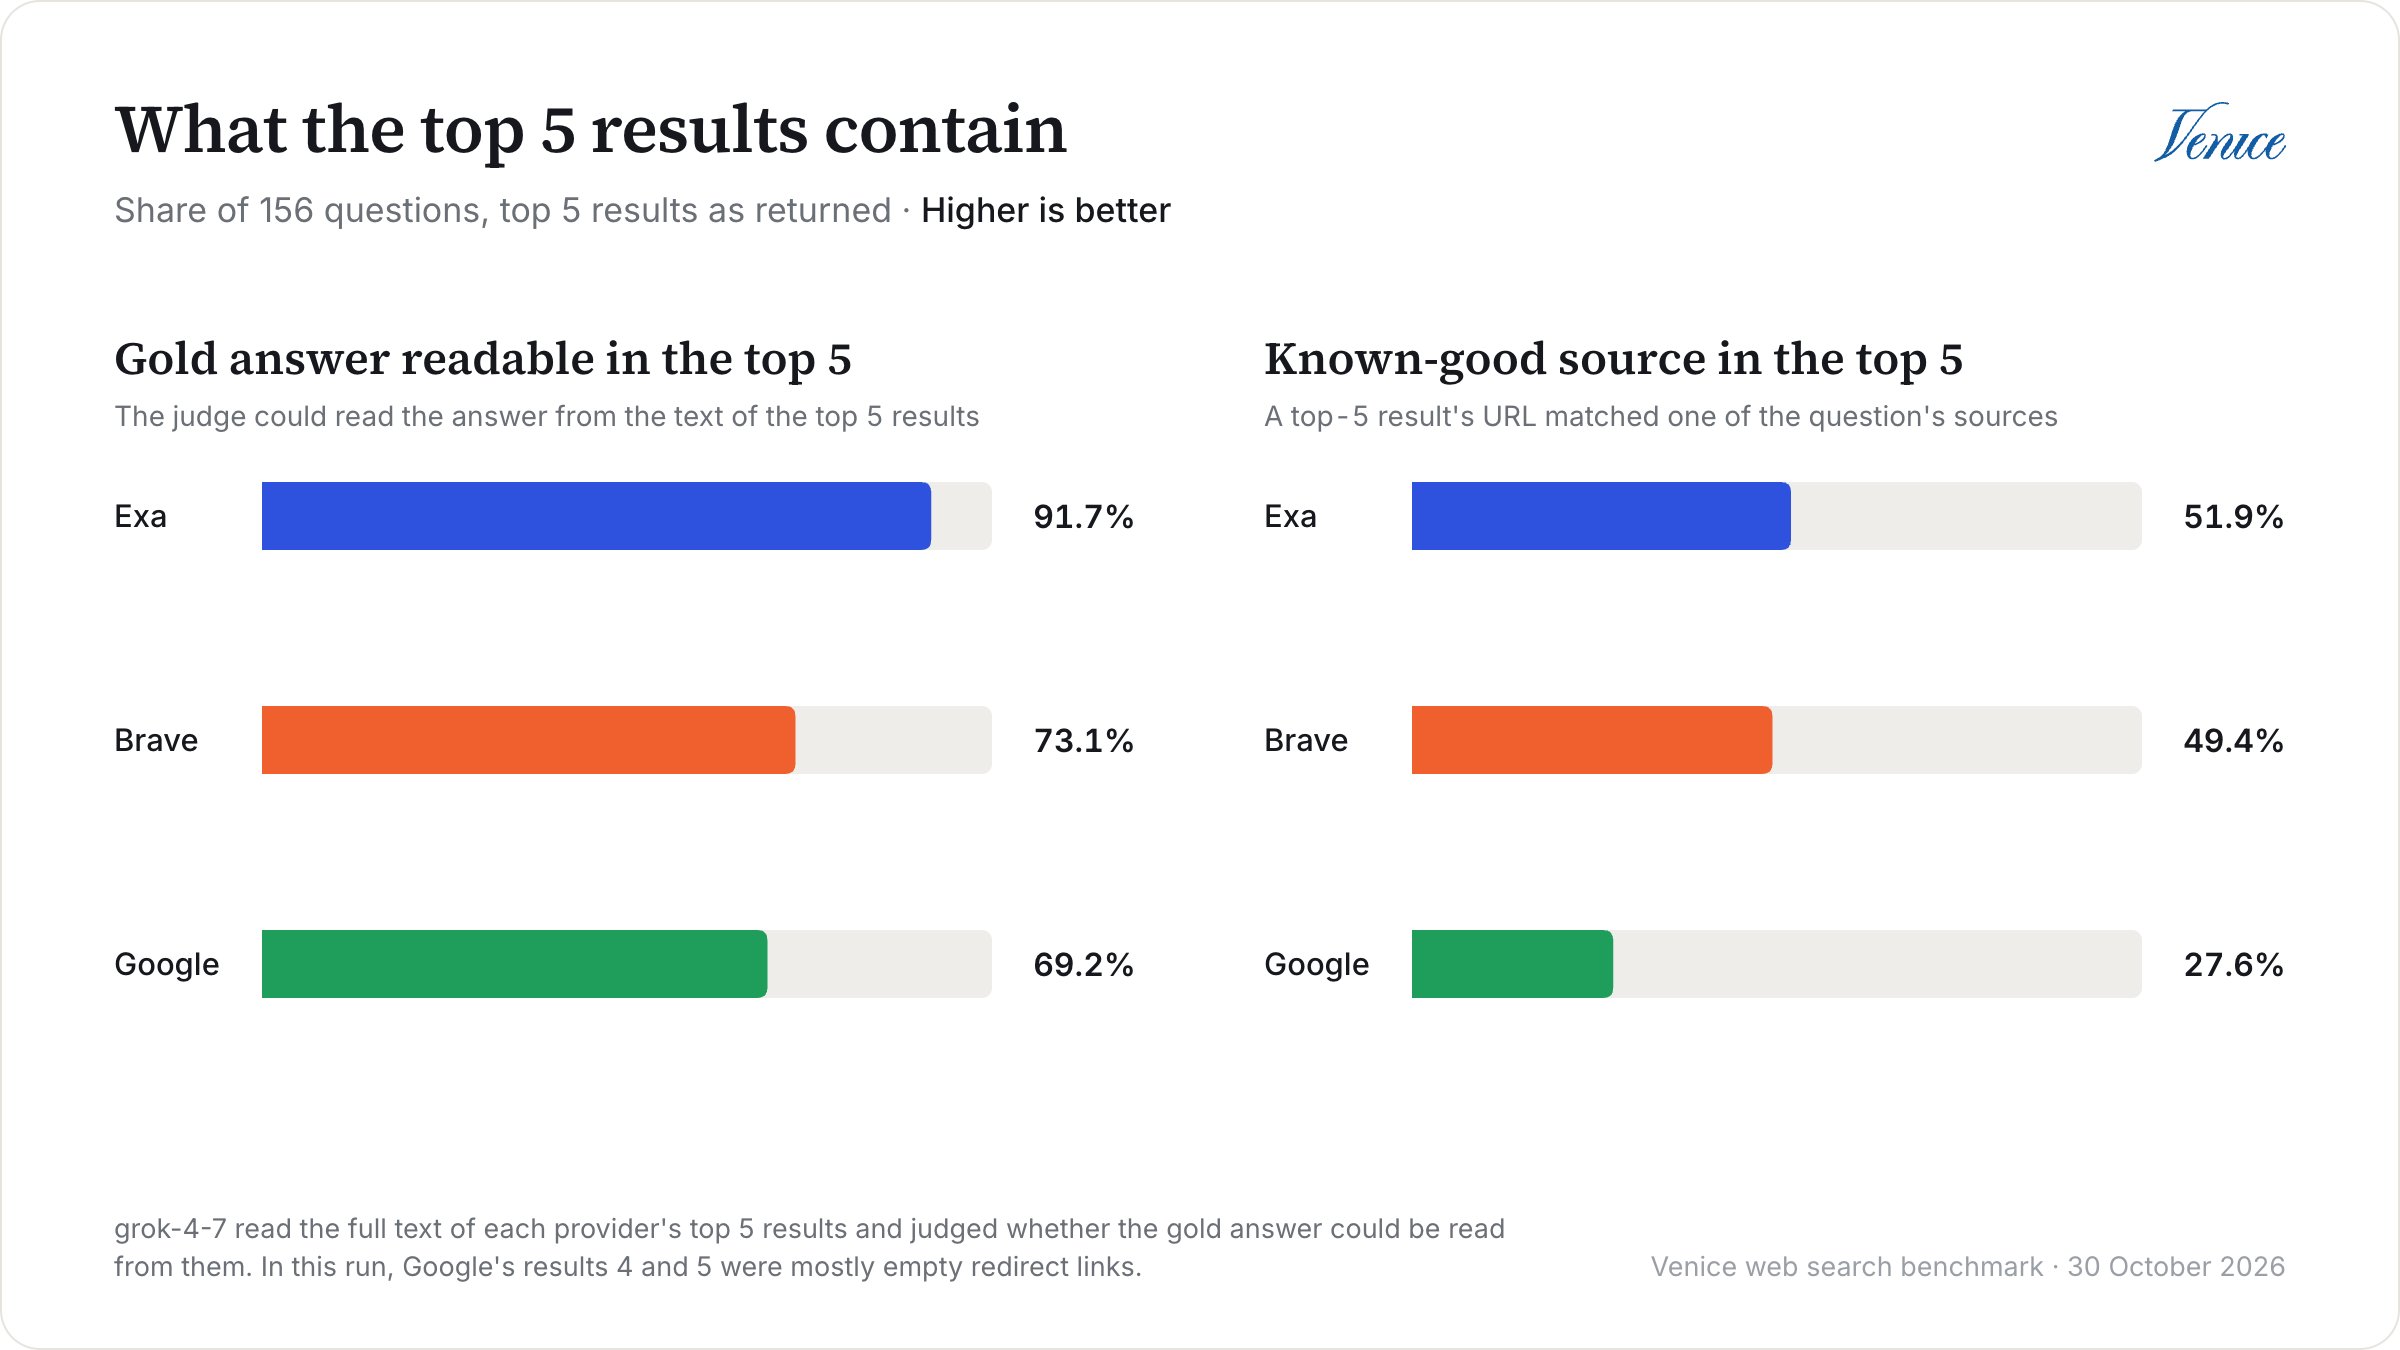
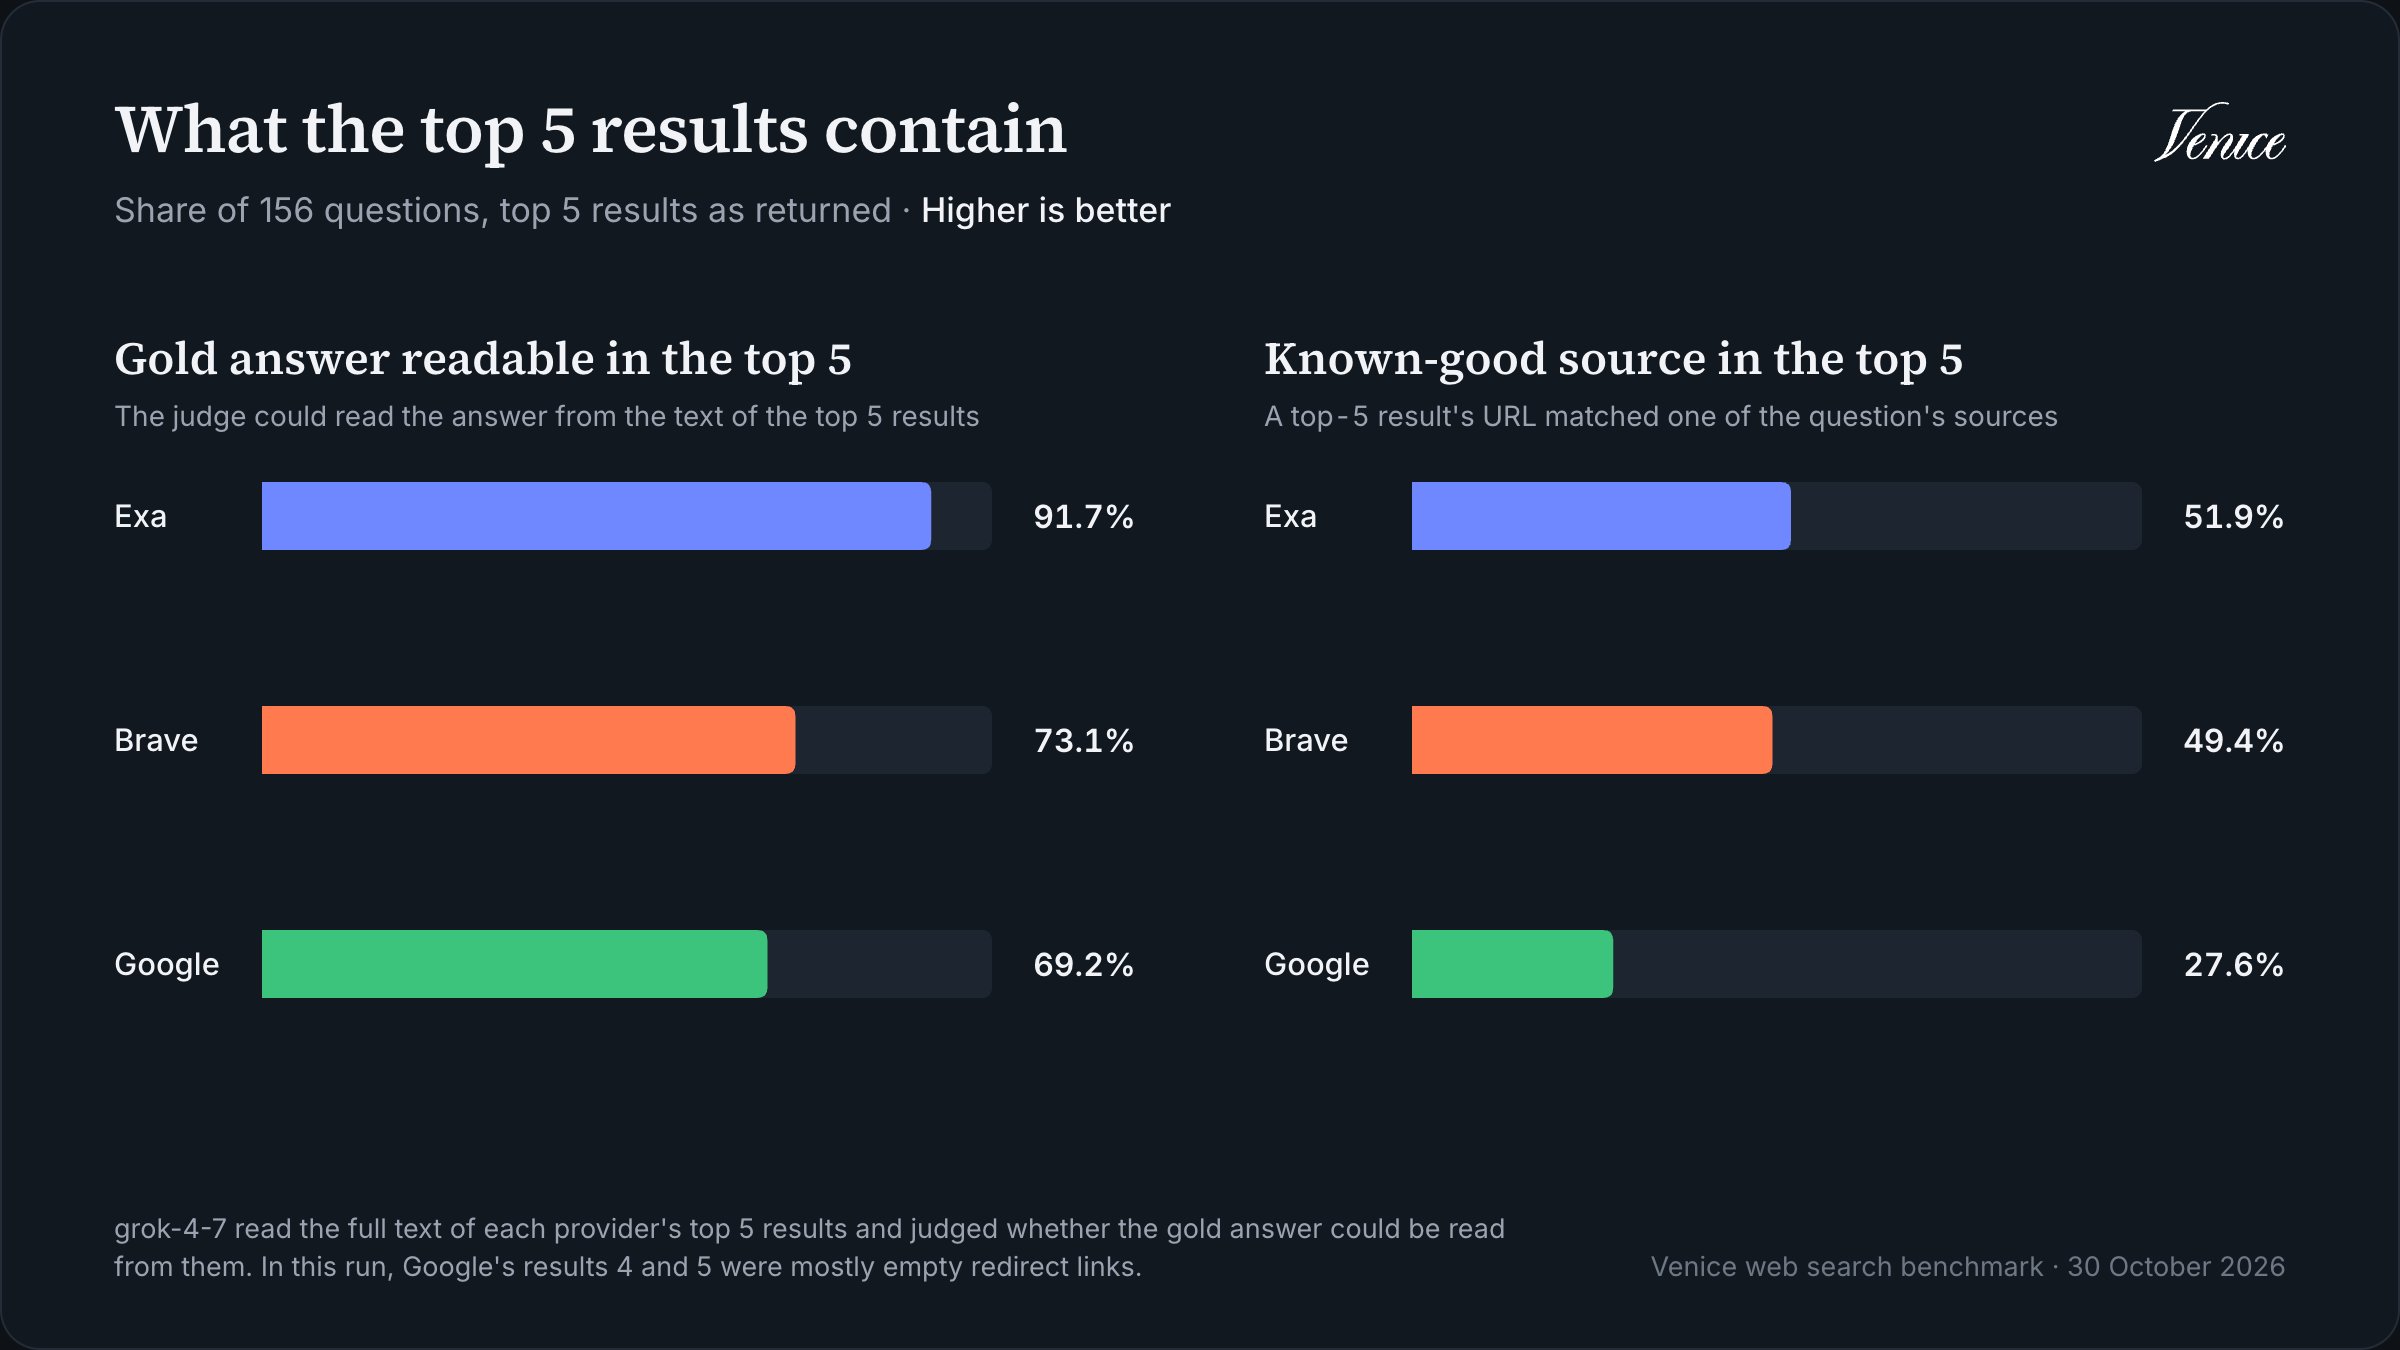
Exa의 결과는 관련성도 가장 높았습니다. Exa의 nDCG@5는 Brave보다 0.15(95% CI 0.11
google.com/goto?url=… 리디렉션 링크였고, 대부분 텍스트가 거의 없어서 Google 상위 5개 결과의 약 3분의 1이 거의 비어 있었습니다. 11월 11일 재실행에서는 이 링크가 사라졌고, Google의 nDCG@5는 0.43에서 0.47로, gold URL hit@5는 27.6%에서 31.4%로 올랐습니다. Exa와 Brave는 여전히 앞섰습니다.
하지만 이 점수는 각 제공자가 고른 페이지만이 아니라 반환한 텍스트를 평가합니다. 두 제공자가 같은 페이지를 반환했을 때 평가자는 71%의 경우 두 사본에 같은 점수를 주었고, 점수가 달랐을 때는 69%의 경우 더 짧은 사본이 낮은 점수를 받았습니다. 둘을 분리하기 위해 하네스는 각 페이지에 어느 제공자든 그 페이지 사본이 받은 최고 점수도 매깁니다. 이 페이지 기준 지표에서 Exa의 Brave 대비 우위는 0.09(95% CI 0.05~0.13)로 줄지만 사라지지는 않으며, 둘 다 Google보다 나은 페이지를 골랐습니다. 이 방식은 둘 이상의 제공자가 반환한 페이지에 대해서만 조건을 맞춘다는 점에 유의하세요. 나머지는 여전히 각 제공자 자체의 텍스트로 평가됩니다.
Brave와 Exa는 비용이 비슷하고 Google이 가장 비쌉니다
검색 자체는 모든 제공자에서 쿼리 1,000건당 $10로 같으므로, 비용 차이는 이후 모델에 보내는 토큰에서 생깁니다. Brave와 Exa는 거의 같았지만, Google의 페이지 텍스트 때문에 답변 프롬프트가 Brave의 약 3.6배가 되어 쿼리당 비용이 거의 두 배가 되었습니다. 이 비용은 캐시 할인 없이
zai-org-glm-5-2 정가를 사용한 것이므로 정확한 수치는 사용하는 모델에 따라 다르지만, 제공자 간 비율은 유지됩니다.
이번에는 Exa가 중앙값 기준으로 가장 빨라 0.71초, Brave는 0.97초였지만, 이 둘의 순위를 매기지는 않겠습니다. 전날 진행한 첫 실행에서는 Exa의 중앙값이 1.73초로 Brave가 더 빨랐고, 11월 11일 재실행에서도 0.99초 대 1.54초로 Brave가 더 빨랐습니다. 지연 시간은 Venice API를 통해 클라이언트에서 측정하므로 네트워크 시간과 Venice 자체 오버헤드가 포함되며, 실행마다 달라집니다. 세 번의 실행 모두에서 유지된 사실은 Brave와 Exa가 중앙값 기준 2초 미만이었고, Google이 매번 가장 느렸다는 것입니다. 여기서는 4.52초, 재실행에서는 5.36초였습니다.
일반 질문
일반 질문 6개에는 정답이 없으므로, 평가자는 대신 각 제공자 쌍의 답변을 순서를 바꿔 두 번씩 직접 비교했습니다. Exa의 답변이 그중 4개에서 Google을 이겼지만, 질문이 6개뿐이라 이를 근거로 삼지는 않겠습니다. 전체 세부 결과는 보고서에 있습니다.그래서 어떤 것을 써야 할까요?
이번 실행을 바탕으로 다음과 같이 선택하겠습니다.- Exa: 결과를 모델에 바로 넘기는 대부분의 워크로드, 특히 코딩 어시스턴트와 리서치 에이전트에 적합합니다. 모든 질문 세트에서 정확도가 가장 높거나 공동 1위였고 결과의 관련성도 가장 높았으며, 쿼리당 비용은 Brave와 거의 같습니다.
- Brave: 질문이 Exa와 비슷한 성적을 낸 뉴스 및 문서 질문에 더 가깝거나, 주로 어떤 것의 공식 페이지를 찾아야 한다면 적합합니다. 공식 페이지를 찾는 빈도는 Exa와 거의 같았습니다. 기본값이며 빠르고 저렴합니다.
- Google: 별도 스크래핑 없이 검색 응답에서 바로 페이지 텍스트를 받고 싶다면 적합합니다. 대부분의 결과는 전체 페이지지만, 사이트가 스크래핑을 차단하면 약 4분의 1은 스니펫뿐입니다. 추가 토큰과 지연 시간을 예산에 반영해야 하며, 결과를 잘라 낸다면 각 페이지의 앞부분 대신 질문과 일치하는 구절을 남기세요.
주의 사항
이 수치를 지나치게 해석하기 전에 염두에 둘 점이 몇 가지 있습니다.- 질문은 검색이 필요하도록 골랐습니다. 모델이 혼자 답할 수 있는 질문은 모두 제외했으므로, 이 세트는 일상적인 트래픽보다 어렵습니다.
- 질문은 AI 에이전트가 작성했습니다. 모든 질문을 출처와 대조하고 검토했지만, 정답이 여전히 틀렸을 수 있습니다. 발견하면 저장소에 issue를 열어 주세요.
- 릴리스 노트가 세트의 큰 부분을 차지합니다. 정답 156개 중 61개이며, Exa의 우위 대부분이 여기서 나옵니다. 질문 세트별 표를 자신의 워크로드와 비교해 보세요.
- 점수는 모델이 매겼습니다. 반환된 결과를 그대로 사용했을 때 평가자가 정답으로 판정하지 않은 답변 82개 전부와 정답으로 판정한 30개를 검토했습니다. 그중 6개는 모두 오답에서 정답으로 바꾸겠습니다. Brave 3개, Google 2개, Exa 1개입니다. 그러면 Brave는 80.1%, Google은 76.9%, Exa는 94.2%가 되어 순위는 바뀌지 않지만, 평가자가 약간 엄격한 편입니다.
- 검색 결과는 바뀝니다. 이 수치는 2026년 10월 시점의 스냅샷이며, 시간에 민감한 정답, 특히 뉴스 질문의 정답은 낡게 됩니다. 11월 11일 재실행에서 Exa의 순위는 그대로였지만, Brave와 Google의 비교와 Google의 관련성 점수는 달라졌습니다.
- 주 실행에서는 각 질문을 작성된 그대로 검색했습니다. 11월 10일 재실행에서 질문을 검색 쿼리로 바꿔 써도 순위는 바뀌지 않았지만, 애플리케이션 자체의 재작성 방식은 결과를 바꿀 수 있습니다.
- 제공자는 Venice API를 통해 테스트했습니다. 각 제공자는 고유한 형식으로 결과를 반환하므로, 이 수치는 검색 엔진 일반이 아니라 API가 반환하는 세 가지 옵션을 설명합니다.
- 관련성 점수는 반환되는 텍스트 양에 따라 달라집니다. 짧은 발췌문은 같은 페이지의 더 긴 사본보다 낮은 점수를 받을 수 있습니다. 페이지 기준 점수는 둘 이상의 제공자가 반환한 페이지에 대해서는 이를 보정하지만, 나머지에는 적용되지 않습니다.
- 예산이 있는 조건은 끝에서부터 잘라 냅니다. 관련성으로 구절을 고르는 파이프라인이라면 우리보다 Google의 결과를 더 잘 다룰 것입니다.
- 모든 답변을 한 모델이 작성했고, 같은 모델이 질문도 선별했습니다. 다른 모델은 긴 결과를 더 잘(또는 더 못) 활용할 수 있으며, 일부 답을 이미 알고 있을 수도 있습니다.
직접 실행하기
하네스는 런타임 의존성이 없는 작은 Bun 및 TypeScript 프로젝트입니다. 저장소를 클론한 뒤 개발 의존성을 설치하고 테스트를 실행하세요..env 파일에 Venice API 키를 추가하세요.
report.md, 질문·제공자·조건별로 한 행씩 기록된 results.csv, summary.json, 그리고 모든 답변과 각 제공자의 결과 목록이 담긴 파일 두 개가 생성됩니다.
수치만 살펴보고 싶다면 아무것도 실행할 필요가 없습니다. 저장소의 results 폴더에 이번 실행의 파일이 모두 들어 있습니다.
하지만 진정한 가치는 직접 준비한 질문으로 실행하는 데 있습니다. 질문을 JSON Lines 형식으로, 질문마다 객체 하나씩 작성하세요.
goldAnswer가 없는 질문도 검색 점수는 받으므로, 로그의 실제 쿼리 목록으로 시작하고 정답은 나중에 추가해도 됩니다. 다만 정확도 수치를 신뢰하기 전에 --arms none으로 모델이 질문 중 몇 개를 맞히는지 확인하세요. 모델이 이미 답을 아는 질문으로는 제공자를 구분할 수 없습니다.