

brave, google ou exa. Todos custam os mesmos $0.01 por pesquisa, então a pergunta óbvia é qual você deveria realmente usar.
Neste artigo, vamos descobrir. Criamos um benchmark que envia as mesmas 162 perguntas para cada provedor, faz o mesmo modelo responder a partir dos resultados de cada provedor e avalia tanto os resultados quanto as respostas. Vamos ver como escolhemos as perguntas, o que descobrimos e como você pode executá-lo por conta própria.
Interessado no código completo? Confira o repositório no GitHub. Ele também tem todas as respostas e a lista de resultados de cada provedor desta execução, para que você possa conferir nosso trabalho sem pagar por uma execução.
O que medimos
Há duas coisas diferentes em que um provedor de busca pode ser bom, e elas nem sempre andam juntas:- Recuperação: os resultados são relevantes e realmente contêm a resposta?
- Respostas: quando você entrega esses resultados a um modelo, ele responde corretamente?
POST /augment/search uma vez por provedor, com limit definido como 10. Em seguida, zai-org-glm-5-2 responde a partir dos resultados de cada provedor, e grok-4-7 avalia tudo com temperatura 0. O modelo também responde sem nenhuma pesquisa, como linha de base.
Observe que os provedores não retornam a mesma quantidade de texto, nem mesmo o mesmo tipo. Na nossa execução, o Exa retornou 10 resultados por pesquisa e o Brave entre 7 e 10, compostos por trechos correspondentes à pergunta, com cerca de 1.500 a 1.700 caracteres cada. O Google retornou 5 resultados, que é o que a API da Venice retorna para google independentemente do valor de limit. A maioria era o texto completo da página, a partir do topo: navegação, banners de cookies e tudo mais. Mas não todos: quando um site bloqueia a extração, como Reddit, Facebook, Stack Overflow ou YouTube, o resultado é apenas o snippet da busca. Em uma nova execução em 11 de novembro, um quarto dos 5 principais resultados do Google tinha menos de 300 caracteres de texto. Isso deu cerca de 9.700 caracteres por resultado, ou 48.000 por pesquisa, contra cerca de 14.000 para Brave e Exa. Mais texto pode significar respostas melhores, mas também significa mais tokens de entrada em cada requisição. Para ver o quanto o volume importa, o modelo responde a partir dos resultados de cada provedor de três formas:
Nas duas condições com orçamento, todos os provedores recebem o mesmo número de resultados e o mesmo espaço. Como o harness mantém o início de cada resultado, elas também testam quão bem os resultados de cada provedor resistem quando você os corta, que é o que muitos pipelines reais fazem.
As perguntas
A primeira versão deste benchmark tinha um problema: sem busca, o modelo já respondia 72% das perguntas que conseguíamos avaliar, então os três provedores pareciam quase iguais. Se o modelo já sabe a resposta, a busca não faz muita diferença, e também não consegue dizer qual provedor é melhor. Então, para esta execução, reunimos 156 perguntas com respostas de referência, em que a resposta precisa vir de uma pesquisa:
As perguntas de programação vêm em alguns estilos, desde mensagens de erro coladas até perguntas fixadas em versão como “Which ripgrep version started respecting the GIT_CONFIG_GLOBAL environment variable?”. Isso é proposital: um mecanismo de busca ótimo com linguagem natural ainda pode falhar com uma string de erro. Há também 6 perguntas gerais sem resposta de referência, como perguntas conversacionais longas, às quais voltaremos depois.
Toda pergunta com resposta de referência passou pelas mesmas verificações antes de entrar no conjunto. Redigimos cada uma com agentes de IA a partir de uma fonte primária, como uma nota de versão ou um comunicado de imprensa oficial, e um script buscou cada fonte para confirmar que a citação por trás da resposta de referência estava realmente na página. Depois, o modelo respondeu cada pergunta duas vezes sem busca, e descartamos qualquer pergunta que ele acertou em alguma das vezes.
Para as perguntas de notícias e temas sensíveis, também demos ao modelo as citações da fonte como resultados de busca e só mantivemos uma pergunta se ele respondesse corretamente nas duas vezes. Isso identifica perguntas ambíguas e verifica se o modelo responde a uma pergunta sensível quando tem a fonte. Por fim, outro agente revisou cada pergunta e resposta de referência em relação às fontes, o que levou a 47 edições e mais 3 descartes, e toda pergunta editada passou novamente pela triagem sem busca.
Observe que isso torna a linha de base sem busca quase zero por design, então ela não diz com que frequência a busca ajuda em geral. O que ela diz é que toda pergunta do conjunto precisa de uma pesquisa, que é exatamente o que queremos ao comparar provedores de busca.
As métricas
A precisão vem com um intervalo de confiança de 95%, e as diferenças entre provedores vêm de comparações pareadas nas mesmas perguntas: um intervalo bootstrap e um teste exato de McNemar. Com 156 respostas de referência, cada pergunta vale cerca de 0,6 ponto percentual, e os intervalos de precisão chegam a cerca de ±7 pontos, então vale conferir as comparações pareadas antes de tirar conclusões de uma diferença pequena.
Resultados
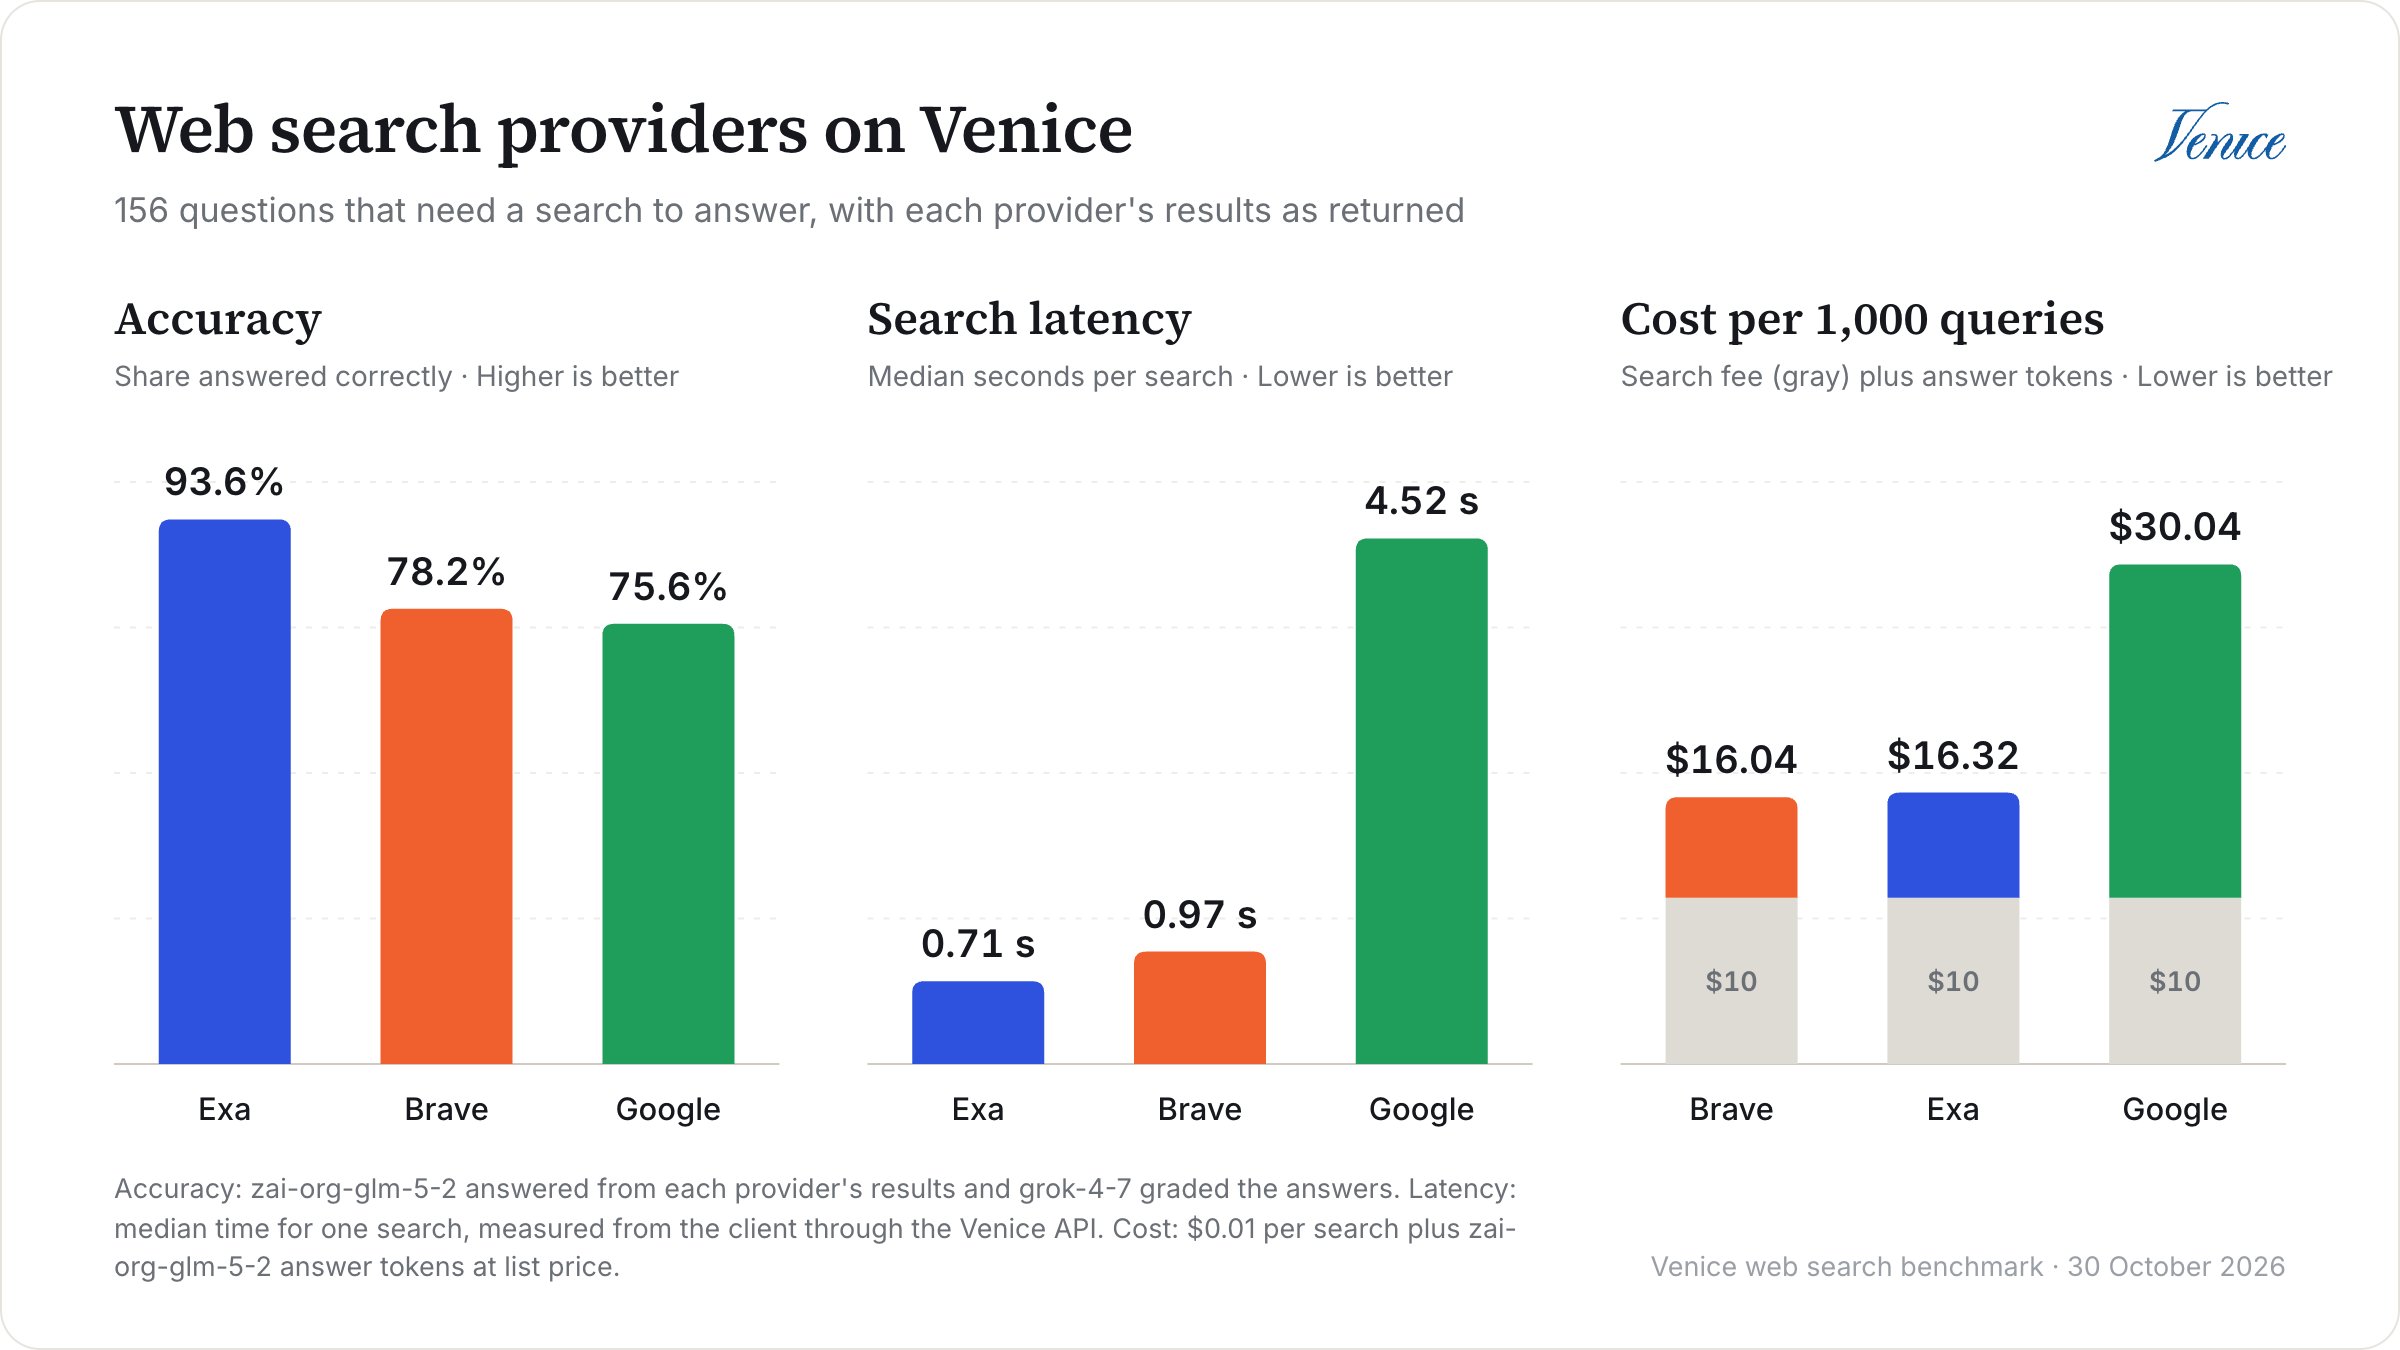
O Exa respondeu corretamente o maior número de perguntas
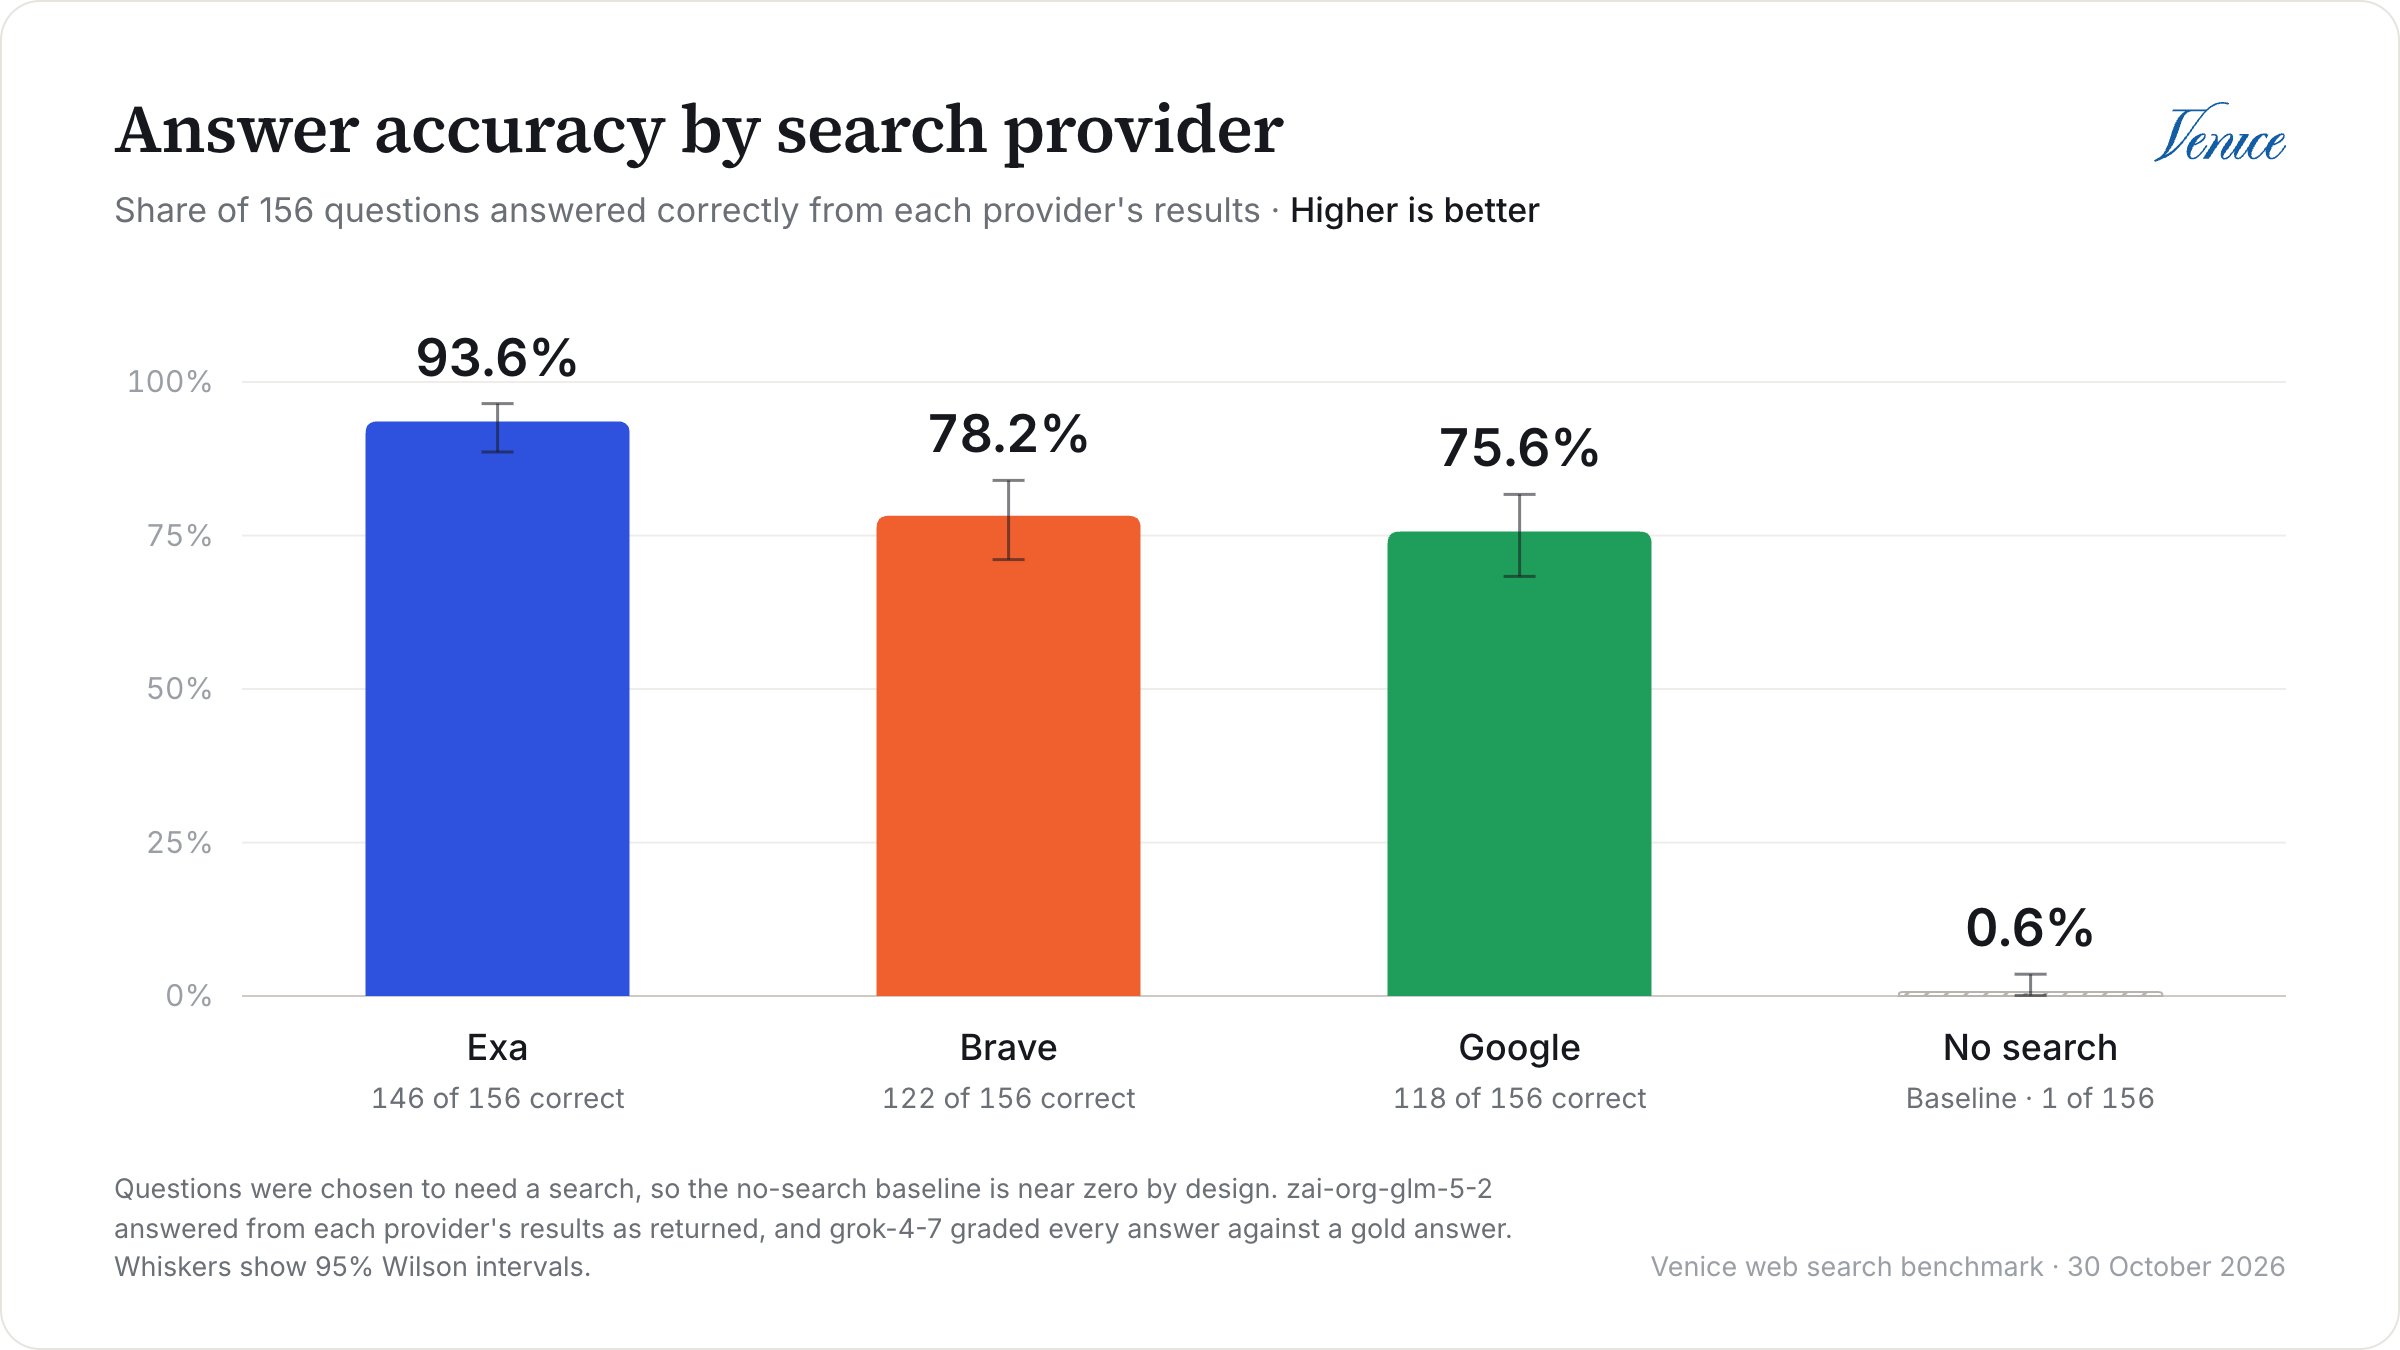
Com todos os resultados como retornados, o Exa respondeu corretamente 93,6% das perguntas, cerca de 15 pontos à frente do Brave e 18 à frente do Google. Desta vez, a diferença é clara: o Exa acertou 28 perguntas que o Brave errou, com apenas 4 no sentido oposto, e 33 que o Google errou, contra 5 (McNemar p < 0.001 para ambos).
Para verificar que isso não foi um acaso, executamos o benchmark completo novamente em 11 de novembro com as mesmas configurações, e os resultados também estão no repositório. O Exa ficou em primeiro de novo, com 93,6% contra 81,4% do Brave e 72,4% do Google, e superou o Brave em 12,2 pontos (24 perguntas a 5, p = 0.001).
Brave contra Google é menos definido. Nesta execução, eles empataram, com 22 perguntas a 18, o que está bem dentro do ruído. Na nova execução, o Brave saiu na frente, com 29 perguntas a 15 (9,0 pontos, p = 0.049). Então o Brave ficou empatado com o Google ou à frente dele, dependendo da execução.
Também queríamos saber se a liderança do Exa vinha da forma como as perguntas foram escritas, já que as pesquisamos exatamente como estavam, e aplicações reais costumam reescrevê-las como consultas de busca antes. Então, em outra execução, em 10 de novembro, fizemos o modelo reescrever cada pergunta uma vez como consulta de mecanismo de busca, enviamos essa mesma consulta aos três provedores e avaliamos as respostas à pergunta original. O Exa ainda superou o Brave em 13,5 pontos (24 perguntas a 3), e a pontuação de nenhum provedor mudou significativamente, então a formulação não explica a liderança do Exa.
As respostas sem busca também merecem atenção. Sem busca, o modelo nos disse para ler um header
Retry-After depois de um 429 em vez do x-ratelimit-reset-requests da Venice, inventou um sufixo -web-search para ativar a busca web pelo nome do modelo e listou um provedor de busca venice que não existe. Se seus usuários perguntam sobre APIs novas ou de nicho, o conhecimento próprio do modelo não vai dar conta.
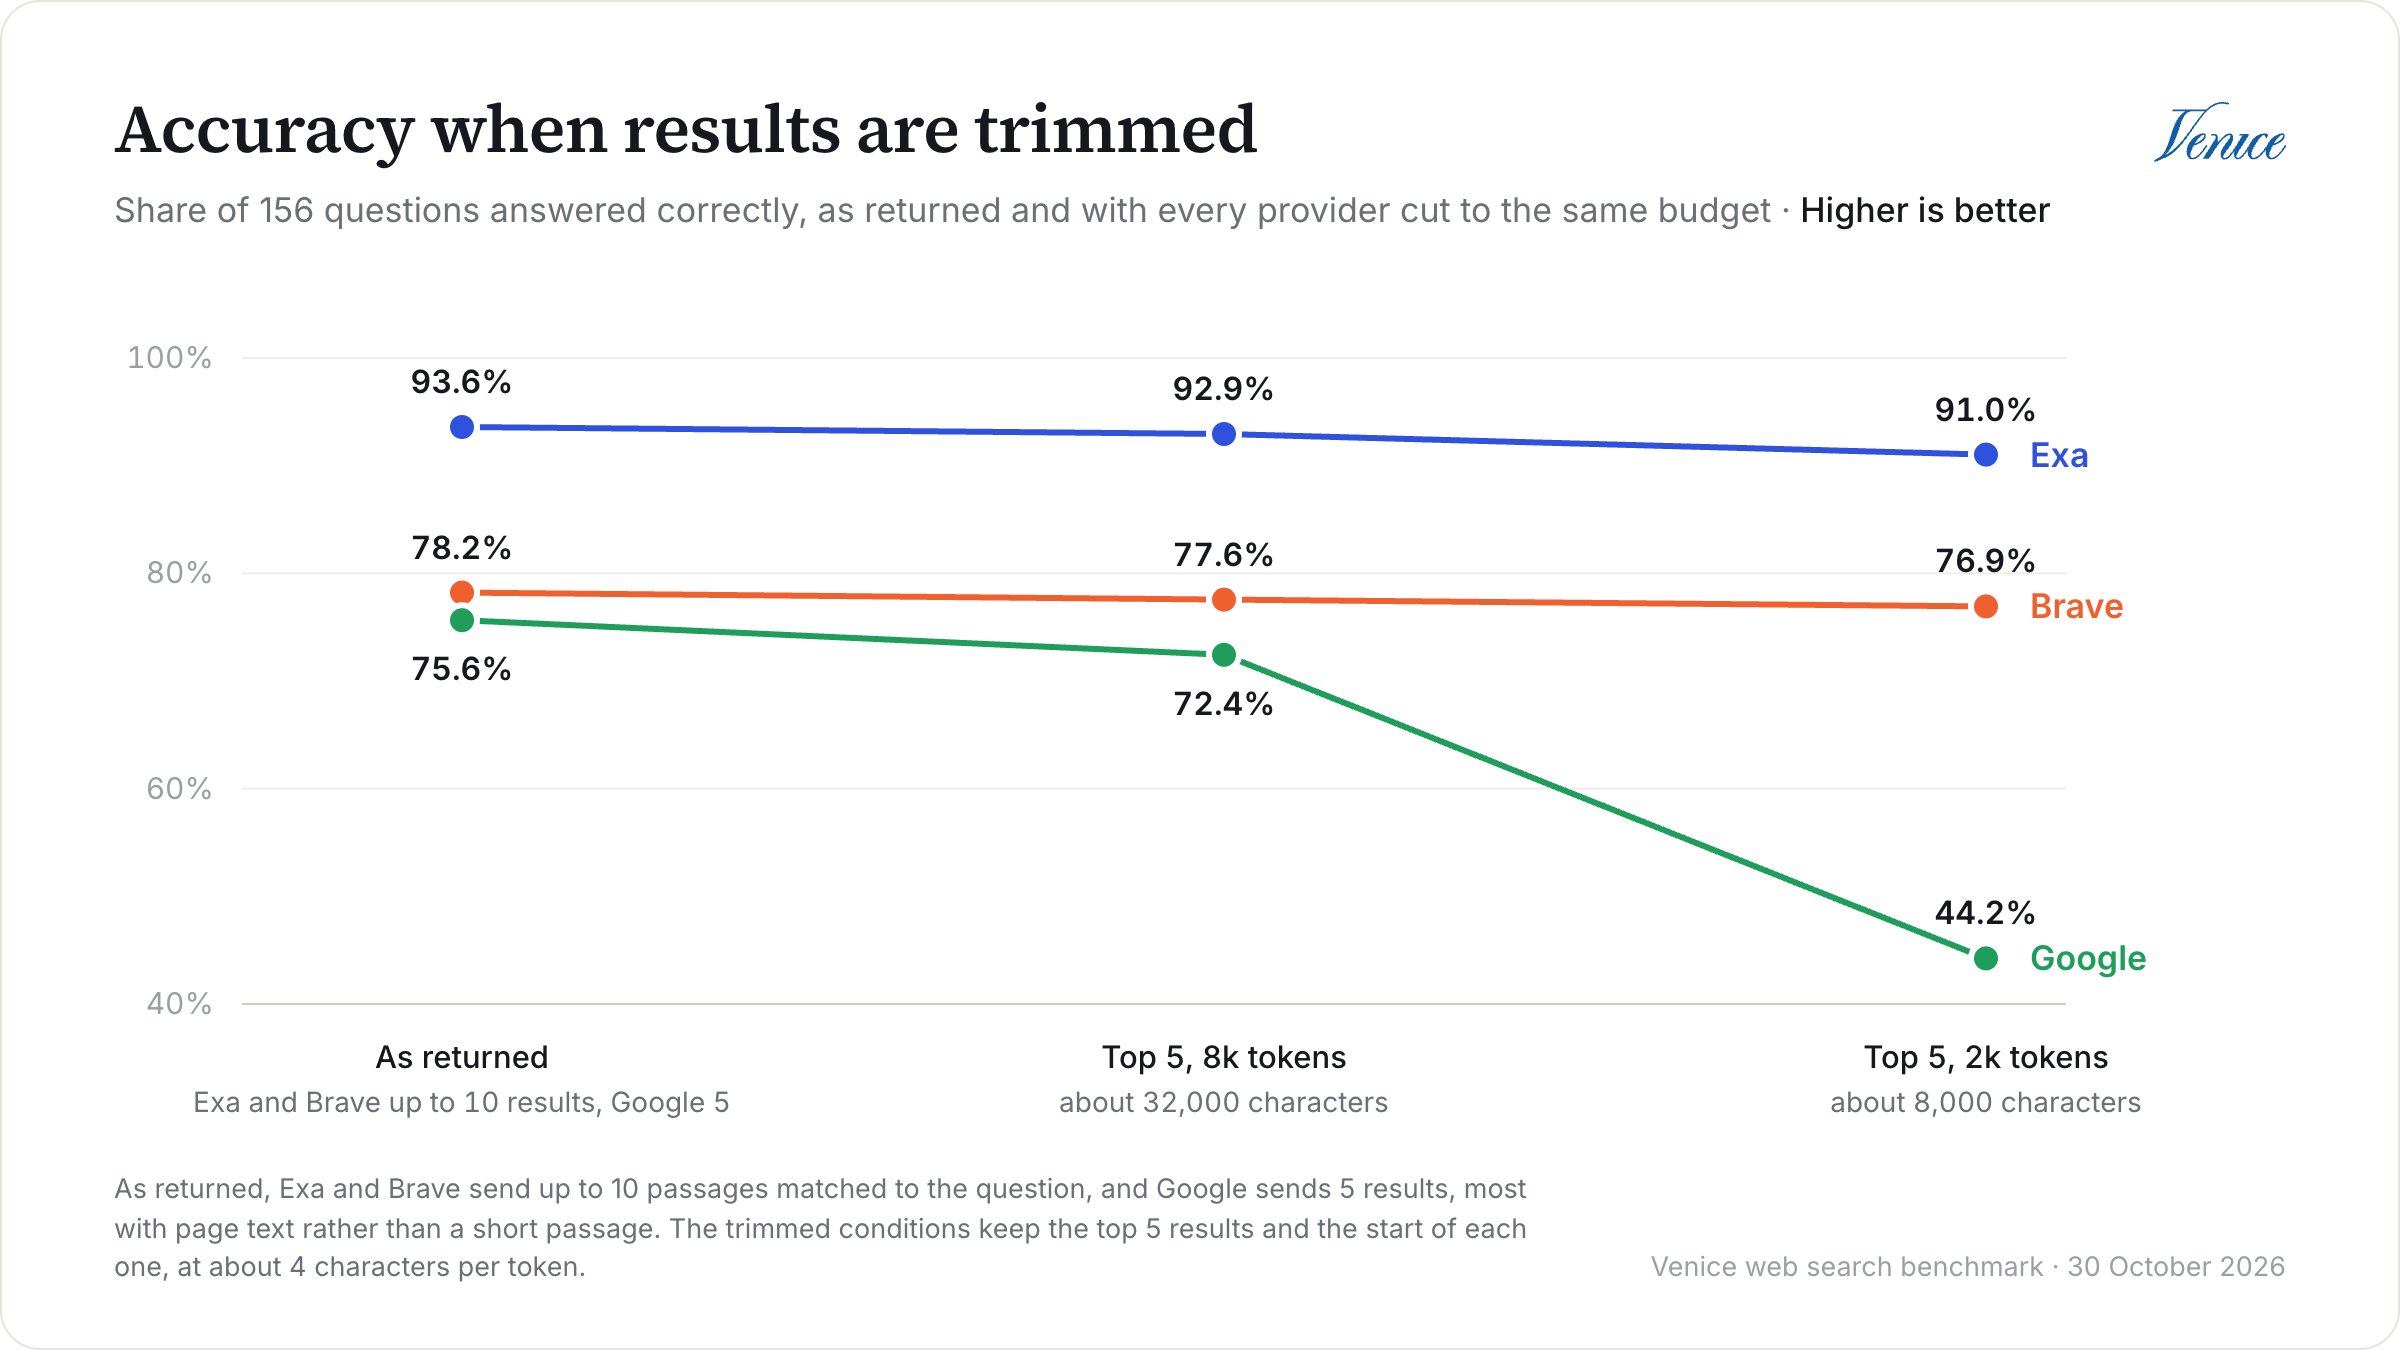
As condições com orçamento são onde o Google tropeça. Com 2.000 tokens, sua precisão caiu para 44,2%, e o modelo não encontrou resposta para 30% das perguntas, contra 10% quando tinha os resultados completos do Google. Como os resultados do Google começam no topo da página, cortá-los para caber manteve a navegação e os banners e removeu a parte que respondia à pergunta. Os resultados do Brave e do Exa já são trechos correspondentes à pergunta, então cortá-los quase não fez diferença. Com 8.000 tokens, o Google recuperou quase tudo, chegando a 72,4%.
De onde vem a liderança do Exa
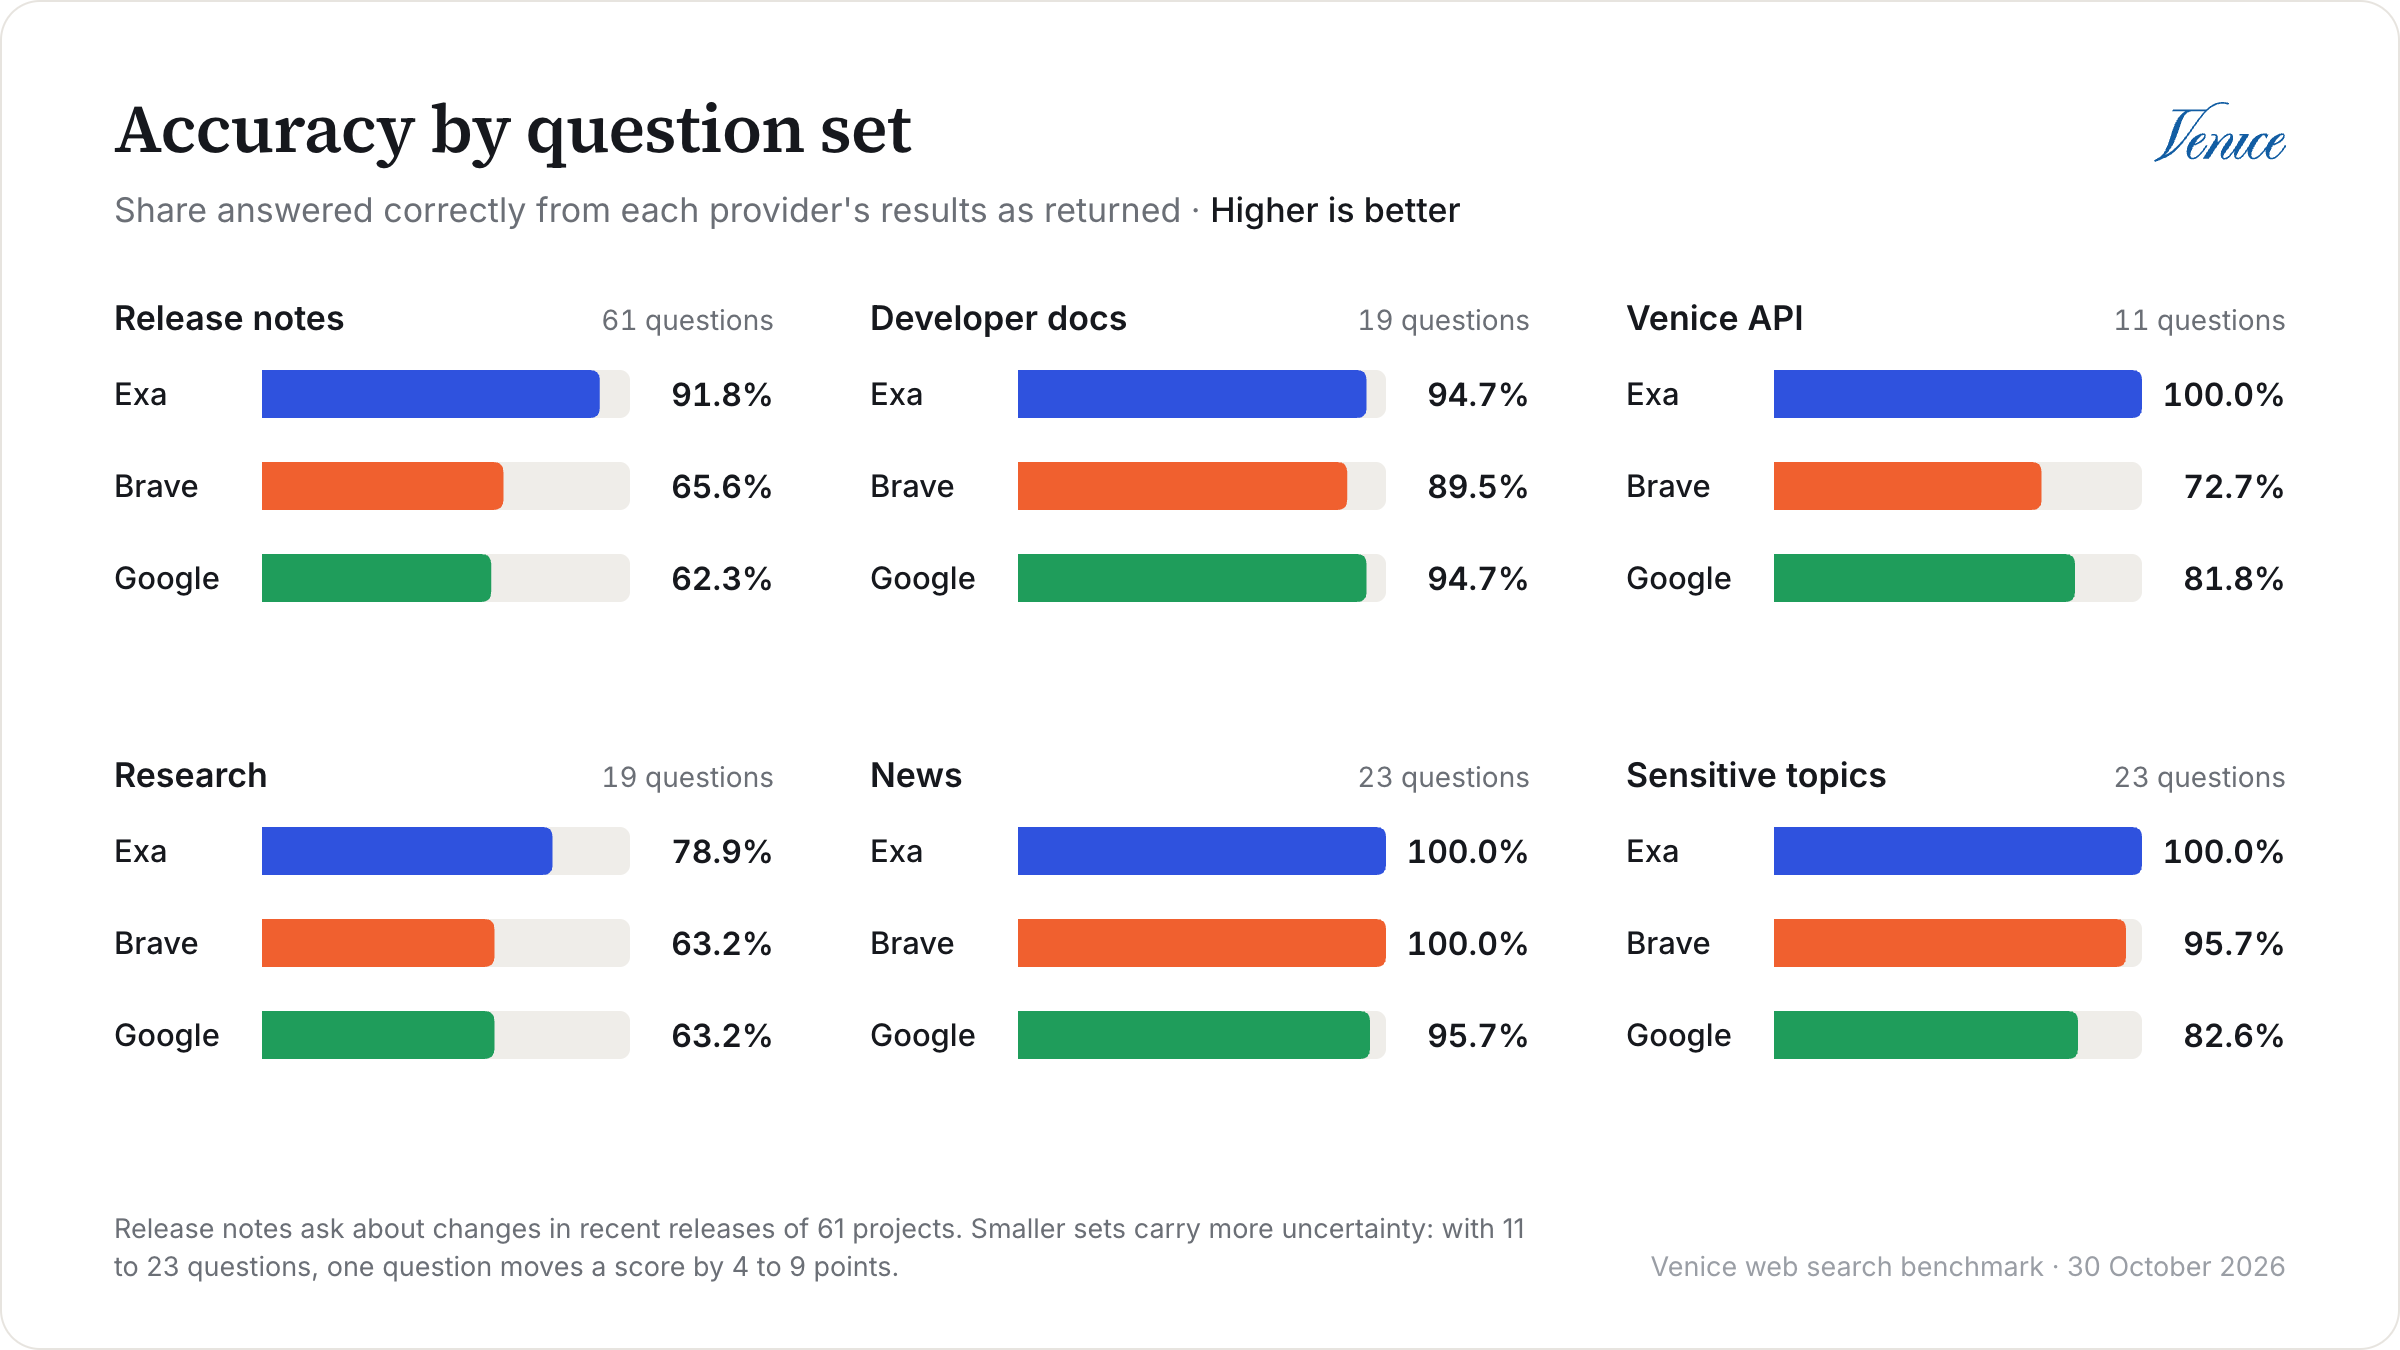
A maior parte da diferença vem de um só lugar: as notas de versão. O Exa respondeu corretamente 56 das 61 perguntas sobre versões, contra 40 do Brave e 38 do Google. A resposta a essas perguntas geralmente está em uma única linha de um changelog, e os resultados do Exa tinham muito mais chance de incluí-la. Nas perguntas sobre versões com um identificador conhecido, como uma flag ou uma variável de ambiente, os resultados do Exa continham 97% deles literalmente, contra 76% do Brave e 68% do Google. Nas perguntas fixadas em versão de todos os conjuntos de programação, o Exa acertou 95% e os outros dois, 55%.
As perguntas de pesquisa foram as mais difíceis para todos, já que precisam de dois fatos de duas páginas diferentes, e até o Exa acertou apenas 15 das 19. Em notícias e documentação para desenvolvedores, porém, os três provedores responderam quase tudo. Se as perguntas dos seus usuários se parecem com essas, o provedor que você escolhe importa bem menos.
E os temas sensíveis?
Alguns serviços de busca filtram ou escondem resultados sobre temas sensíveis, então adicionamos 23 perguntas para verificar se algum dos três provedores fazia isso. Elas cobrem temas como leis sobre drogas, aborto, trabalho sexual, armas de fogo, vigilância e bloqueios de internet, e cada uma tem uma resposta factual de uma fonte oficial, como uma decisão judicial ou um aviso governamental. Nenhum provedor retornou vazio ou com erro em nenhuma delas, e o modelo nunca se recusou a responder uma por causa do tema. O Exa respondeu corretamente às 23, o Brave a 22 e o Google a 19. Os erros foram erros comuns de busca, em que os resultados não tinham o fato ou tinham uma data diferente, exceto por uma resposta do Google que hesitou mas deu a data correta, com a qual o juiz foi rigoroso demais. Observe que 23 perguntas só podem mostrar que não vimos nenhuma filtragem, não que ela não exista em lugar nenhum.O Exa retornou o texto mais útil
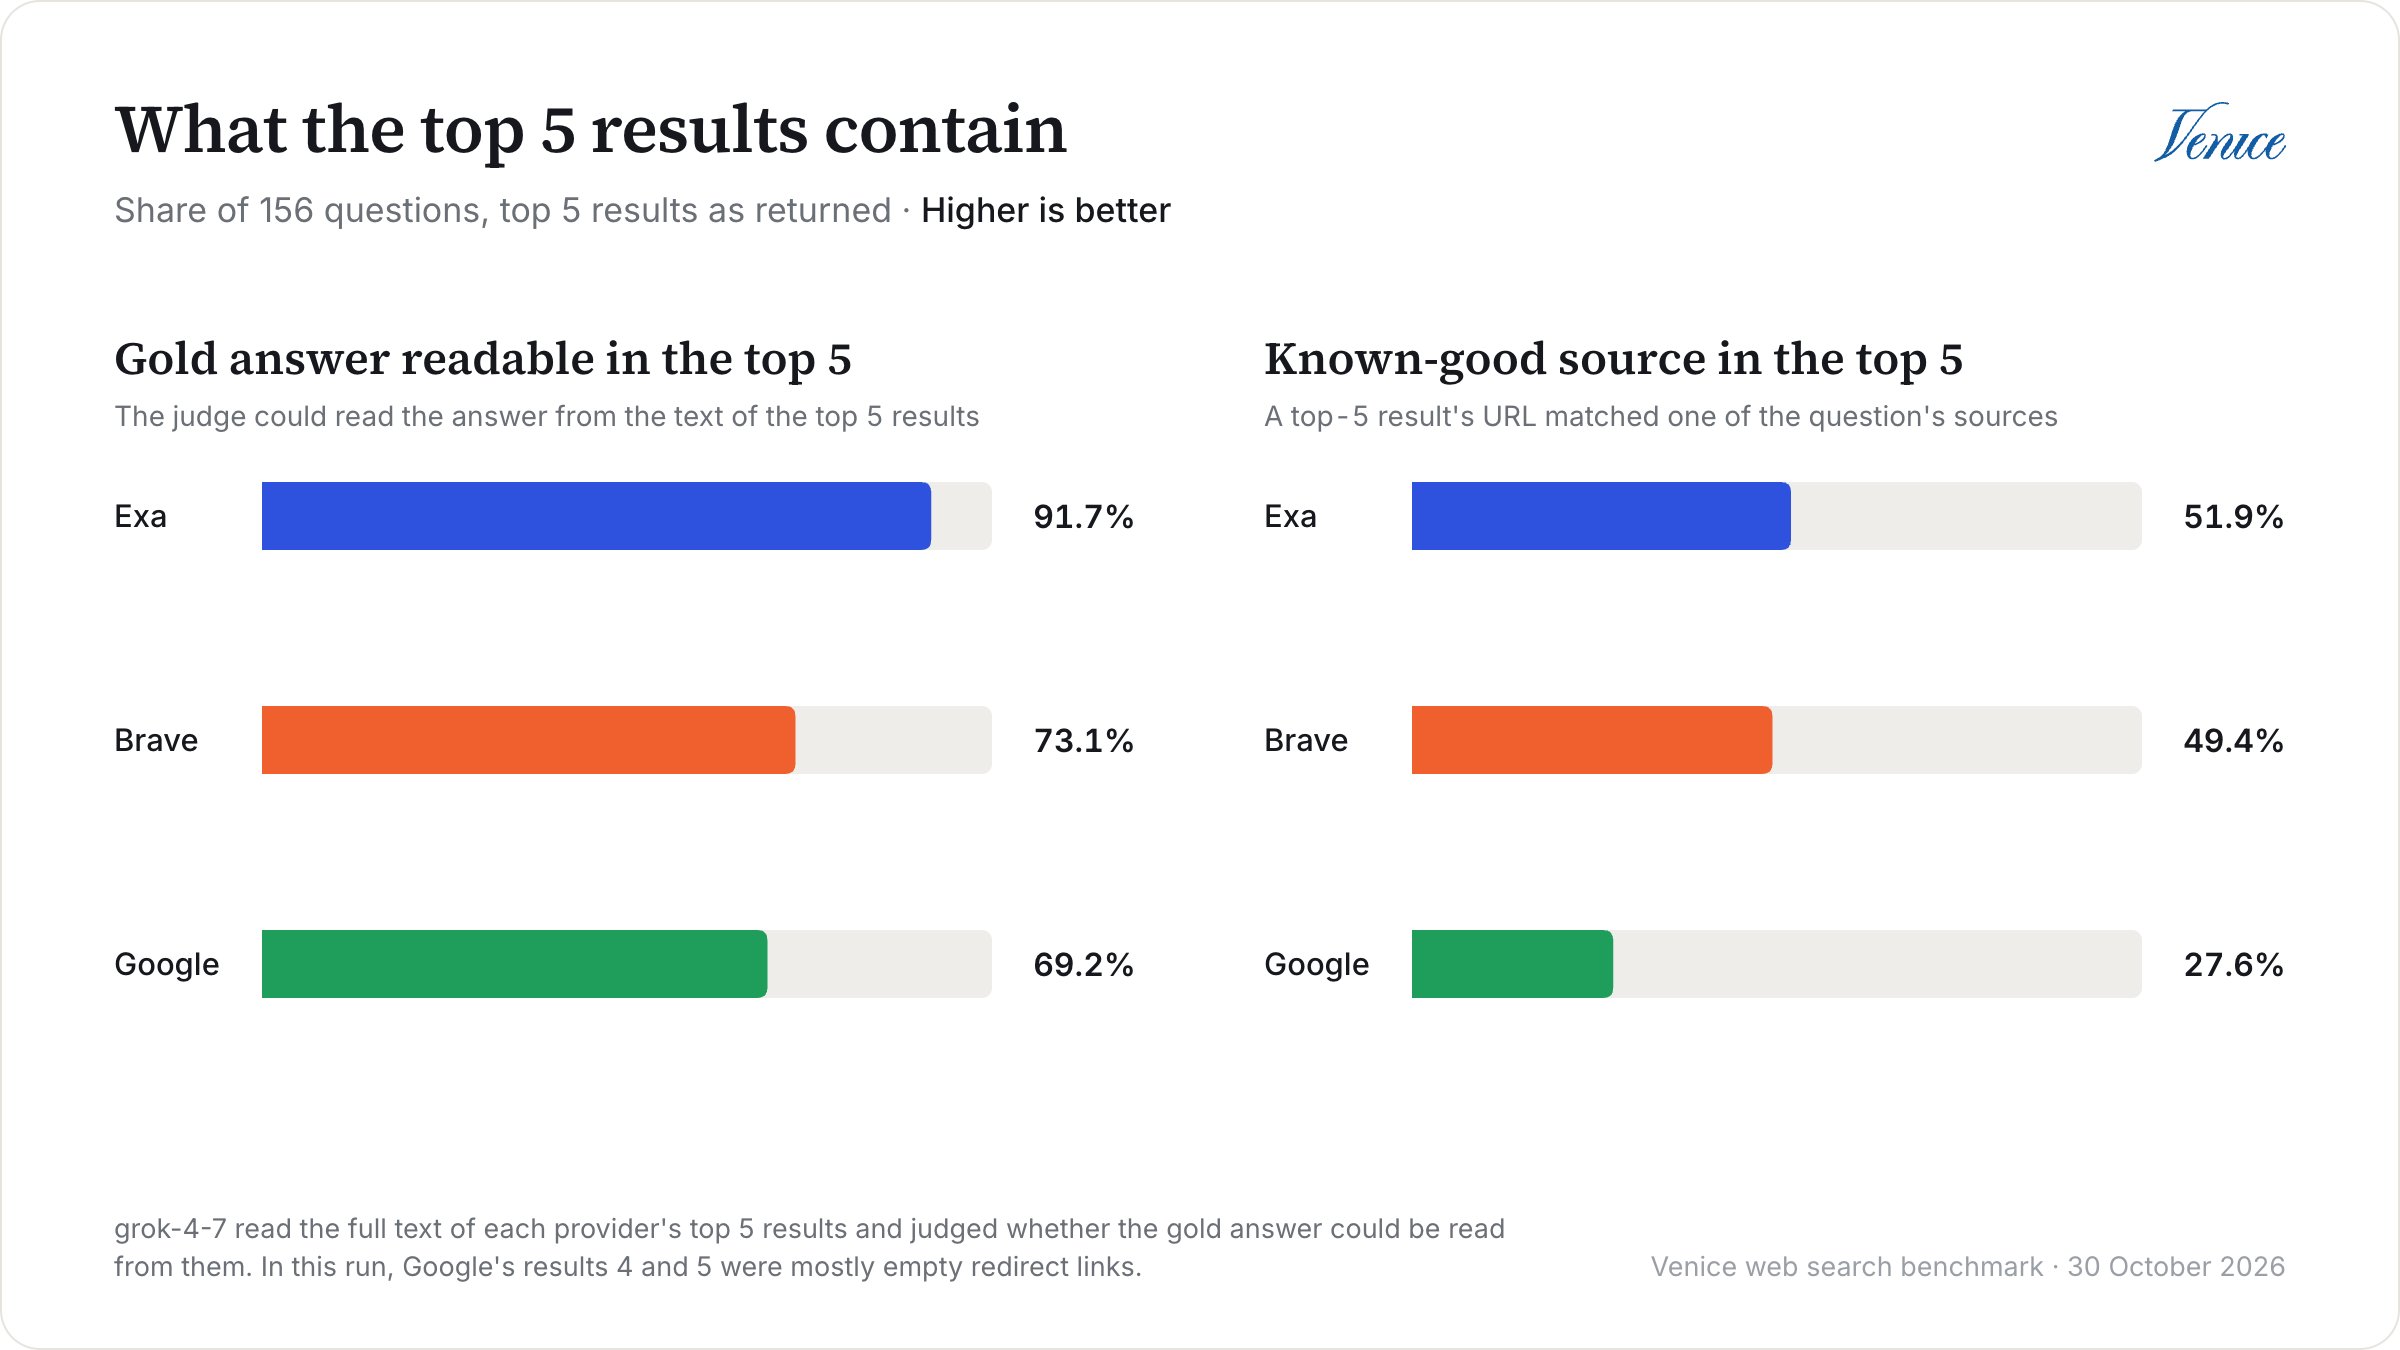
Os resultados do Exa também foram os mais relevantes. Seu nDCG@5 foi 0,15 maior que o do Brave (IC de 95%: 0,11 a 0,19) e 0,32 maior que o do Google (IC de 95%: 0,28 a 0,36), e o Brave ficou 0,17 à frente do Google.
Os números do Google aqui incluem um problema que já foi corrigido, porém. Nesta execução, os resultados 4 e 5 do Google eram links de redirecionamento
google.com/goto?url=… em 144 das 162 pesquisas, e a maioria quase não tinha texto, então cerca de um terço dos 5 principais resultados do Google estava praticamente vazio. Eles tinham desaparecido na nova execução de 11 de novembro, em que o nDCG@5 do Google subiu de 0,43 para 0,47 e seu gold URL hit@5 de 27,6% para 31,4%. Exa e Brave continuaram à frente.
Essa pontuação cobre o texto que cada provedor retornou, porém, não apenas as páginas que escolheu. Quando dois provedores retornaram a mesma página, o juiz deu a mesma nota às duas cópias em 71% das vezes, e quando as notas diferiram, a cópia mais curta teve nota menor em 69% dos casos. Para separar as duas coisas, o harness também pontua cada página pela melhor nota que qualquer cópia dela, de qualquer provedor, recebeu. Nessa medida por página, a liderança do Exa sobre o Brave cai para 0,09 (IC de 95%: 0,05 a 0,13), mas não desaparece, e ambos escolheram páginas melhores que o Google. Observe que isso só equilibra as coisas para páginas que mais de um provedor retornou. Todo o resto ainda é pontuado pelo texto do próprio provedor.
Brave e Exa custam quase o mesmo, e o Google custa mais
A pesquisa em si custa os mesmos $10 por 1.000 consultas em todos os provedores, então a diferença de custo vem dos tokens que você envia ao modelo depois. Brave e Exa ficaram quase iguais, enquanto o texto de página do Google deixou os prompts de resposta cerca de 3,6 vezes maiores que os do Brave, o que quase dobrou o custo por consulta. Esses custos usam os preços de tabela do
zai-org-glm-5-2 sem desconto de cache, então os valores exatos dependem do seu modelo, mas as proporções entre provedores se mantêm.
O Exa foi o mais rápido na mediana desta vez, com 0,71 segundo contra 0,97 do Brave, mas não classificaríamos esses dois: o Brave foi mais rápido na nossa primeira execução, no dia anterior, quando a mediana do Exa foi de 1,73 segundo, e de novo na execução de 11 de novembro, com 0,99 segundo contra 1,54. A latência é medida no cliente pela API da Venice, então inclui o tempo de rede e a sobrecarga da própria Venice, e varia entre execuções. O que se manteve nas três execuções é que Brave e Exa ficaram abaixo de 2 segundos na mediana, e o Google foi o mais lento todas as vezes, com 4,52 segundos aqui e 5,36 na nova execução.
As perguntas gerais
As 6 perguntas gerais não têm resposta de referência, então o juiz comparou diretamente as respostas de cada par de provedores, duas vezes com a ordem invertida. As respostas do Exa venceram as do Google em 4 delas, mas com apenas 6 perguntas, não é algo em que nos apoiaríamos. O detalhamento completo está no relatório.Então, qual você deveria usar?
Com base nesta execução, é assim que escolheríamos:- Exa, para a maioria das cargas de trabalho que passam os resultados direto para um modelo, especialmente assistentes de programação e agentes de pesquisa. Ele teve a melhor precisão, ou empatou com a melhor, em todos os conjuntos de perguntas e os resultados mais relevantes, por quase o mesmo custo por consulta que o Brave.
- Brave, se suas perguntas se parecem mais com nossas perguntas de notícias e documentação, em que empatou com o Exa, ou se você precisa principalmente encontrar a página oficial de algo, o que ele fez quase tão frequentemente quanto o Exa. É o padrão, e é rápido e barato.
- Google, se você quer o texto da página direto na resposta da busca, sem uma extração separada. A maioria dos resultados é a página completa, mas cerca de um quarto é apenas o snippet, quando o site bloqueia a extração. Você vai precisar reservar orçamento para os tokens e a latência extras e, se cortar os resultados, mantenha os trechos que correspondem à pergunta em vez do início de cada página.
Ressalvas
Há algumas coisas a ter em mente antes de tirar conclusões demais destes números:- As perguntas foram escolhidas para precisar de busca. Descartamos toda pergunta que o modelo conseguia responder sozinho, então o conjunto é mais difícil que o tráfego do dia a dia.
- Agentes de IA escreveram as perguntas. Cada uma foi verificada contra suas fontes e revisada, mas uma resposta de referência ainda pode estar errada. Se você encontrar uma, abra uma issue no repositório.
- As notas de versão são uma grande parte do conjunto. Elas são 61 das 156 respostas de referência, e é delas que vem a maior parte da liderança do Exa, então compare a tabela por conjunto de perguntas com a sua própria carga de trabalho.
- As notas vêm de um modelo. Revisamos toda resposta que o juiz não marcou como correta com os resultados como retornados, 82 no total, mais 30 que ele marcou. Mudaríamos 6 delas, todas de errada para certa: 3 do Brave, 2 do Google e 1 do Exa. Isso colocaria o Brave em 80,1%, o Google em 76,9% e o Exa em 94,2%, então a classificação não muda, mas o juiz tende a ser um pouco rigoroso.
- Os resultados de busca mudam. Estes números são um retrato de outubro de 2026, e respostas de referência sensíveis ao tempo, especialmente as de notícias, ficam desatualizadas. Nossa execução de 11 de novembro manteve a mesma classificação para o Exa, mas mudou Brave contra Google e as pontuações de relevância do Google.
- Nossa execução principal pesquisou cada pergunta exatamente como escrita. Reescrever as perguntas como consultas de busca não mudou a classificação na nossa execução de 10 de novembro, mas a reescrita da sua própria aplicação poderia mudar.
- Testamos os provedores pela API da Venice. Cada um retorna em seu próprio formato, então estes números descrevem as três opções como a API as retorna, não os mecanismos de busca em geral.
- As pontuações de relevância dependem de quanto texto volta. Um trecho curto pode ter nota menor que uma cópia mais longa da mesma página. A pontuação por página corrige isso para páginas que mais de um provedor retornou, mas não para o resto.
- As condições com orçamento cortam a partir do fim. Um pipeline que escolhe trechos por relevância trataria os resultados do Google melhor do que o nosso.
- Um único modelo escreveu todas as respostas, e o mesmo modelo fez a triagem das perguntas. Um modelo diferente poderia aproveitar melhor (ou pior) resultados longos, e talvez já saiba algumas das respostas.
Executando você mesmo
O harness é um pequeno projeto em Bun e TypeScript sem dependências de runtime. Depois de clonar o repositório, instale as dependências de desenvolvimento e execute os testes:.env no repositório:
--budget, que por padrão é $5. Nossa execução completa custou $36.10: $4.86 por 486 pesquisas, mais os tokens de resposta e do juiz. A estimativa não considera descontos de cache, então fica mais alta, em cerca de $50. Cada execução gera um report.md com as tabelas completas por trás deste artigo, um results.csv com uma linha por pergunta, provedor e condição, um summary.json e dois arquivos com todas as respostas e a lista de resultados de cada provedor.
Se você só quer explorar nossos números, não precisa executar nada, já que a pasta results do repositório tem tudo isso desta execução.
O verdadeiro valor, porém, está em executá-lo com suas próprias perguntas. Escreva-as em JSON Lines, com um objeto por pergunta:
goldAnswer ainda recebem pontuações de recuperação, então você pode começar com uma lista de consultas reais dos seus logs e adicionar respostas de referência depois. Antes de confiar nos números de precisão, porém, verifique quantas das suas perguntas o modelo acerta com --arms none, já que perguntas cuja resposta ele já sabe não vão diferenciar seus provedores.