

brave、google 或 exa。它们的价格都是每次搜索 $0.01,所以显而易见的问题是:你到底该用哪一个?
在这篇文章中,我们就来找出答案。我们构建了一个基准测试:把同样的 162 个问题发给每个提供商,让同一个模型基于每个提供商的结果作答,并同时为结果和回答打分。我们会介绍如何挑选问题、得出了什么结论,以及你如何自己运行它。
想看完整代码?请查看 GitHub 仓库。仓库中还包含这次运行的每个回答和每个提供商的结果列表,你无需花钱运行就能核对我们的结果。
我们测量了什么
搜索提供商可以在两件不同的事情上表现出色,而这两件事并不总是一致:- **检索:**结果是否相关,是否真的包含答案?
- **回答:**把这些结果交给模型后,它能否答对?
POST /augment/search,每个提供商各发一次,limit 设为 10。然后由 zai-org-glm-5-2 基于每个提供商的结果作答,再由 grok-4-7 在温度 0 下为所有内容打分。模型还会在完全不搜索的情况下作答,作为基线。
请注意,各提供商返回的文本量不同,甚至文本类型也不同。在我们的运行中,Exa 每次搜索返回 10 条结果,Brave 返回 7 到 10 条,内容都是与问题匹配的段落,每条约 1,500 到 1,700 个字符。Google 返回 5 条结果,这是无论 limit 设为多少,Venice API 对 google 都会返回的数量。其中大多数是从页面顶部开始的完整页面文本:导航栏、Cookie 横幅等一应俱全。但并非全部如此:当网站阻止抓取时,例如 Reddit、Facebook、Stack Overflow 或 YouTube,结果就只有搜索摘要片段。在 11 月 11 日的重新运行中,Google 前 5 条结果中有四分之一的文本不足 300 个字符。平均下来,每条结果约 9,700 个字符,每次搜索约 48,000 个字符,而 Brave 和 Exa 约为 14,000 个字符。更多文本可能带来更好的回答,但也意味着每个请求都有更多输入 token。为了看看文本量有多大影响,模型会以三种方式基于每个提供商的结果作答:
在两种有预算限制的条件下,每个提供商获得相同数量的结果和相同的空间。由于测试工具保留每条结果的开头,这两种条件也测试了每个提供商的结果在被截断后表现如何,而很多实际流水线正是这样做的。
问题
这个基准测试的第一个版本有个问题:在不搜索的情况下,模型已经能答对我们可评分问题中的 72%,所以三个提供商看起来差不多。如果模型已经知道答案,搜索就起不了多大作用,也无法告诉你哪个提供商更好。 因此在这次运行中,我们整理了 156 个带标准答案的问题,它们的答案必须来自搜索:
编程问题有几种风格,从粘贴的错误信息到绑定版本的问题,例如 “Which ripgrep version started respecting the GIT_CONFIG_GLOBAL environment variable?”。这是有意为之:擅长自然语言的搜索引擎仍可能在错误字符串上栽跟头。另外还有 6 个没有标准答案的通用问题,例如较长的对话式问题,我们稍后再谈。
每个带标准答案的问题在入选前都经过了同样的检查。我们用 AI 智能体根据一手来源起草每个问题,例如发布说明或官方新闻稿,并用脚本抓取每个来源,确认标准答案所依据的引文确实出现在页面上。然后,模型在不搜索的情况下对每个问题作答两次,只要有一次答对,我们就会剔除该问题。
对于新闻和敏感话题问题,我们还把来源引文作为搜索结果提供给模型,只有两次都答对的问题才会保留。这样可以发现有歧义的问题,并检查模型在拥有来源时会不会回答敏感问题。最后,另一个智能体对照来源复核了每个问题和标准答案,由此做了 47 处修改并又剔除了 3 个问题,每个修改过的问题都重新经过了不搜索筛选。
请注意,这在设计上让不搜索基线接近于零,因此它并不能说明搜索在一般情况下有多大帮助。它能说明的是:问题集中的每个问题都需要搜索,而这正是我们比较搜索提供商时想要的。
指标
准确率附带 95% 置信区间,提供商之间的差异来自对相同问题的配对比较:bootstrap 区间和精确 McNemar 检验。有 156 个标准答案时,每个问题约占 0.6 个百分点,准确率的区间最宽可达约 ±7 个百分点,因此在对小差距下结论之前,值得先看看配对比较。
结果
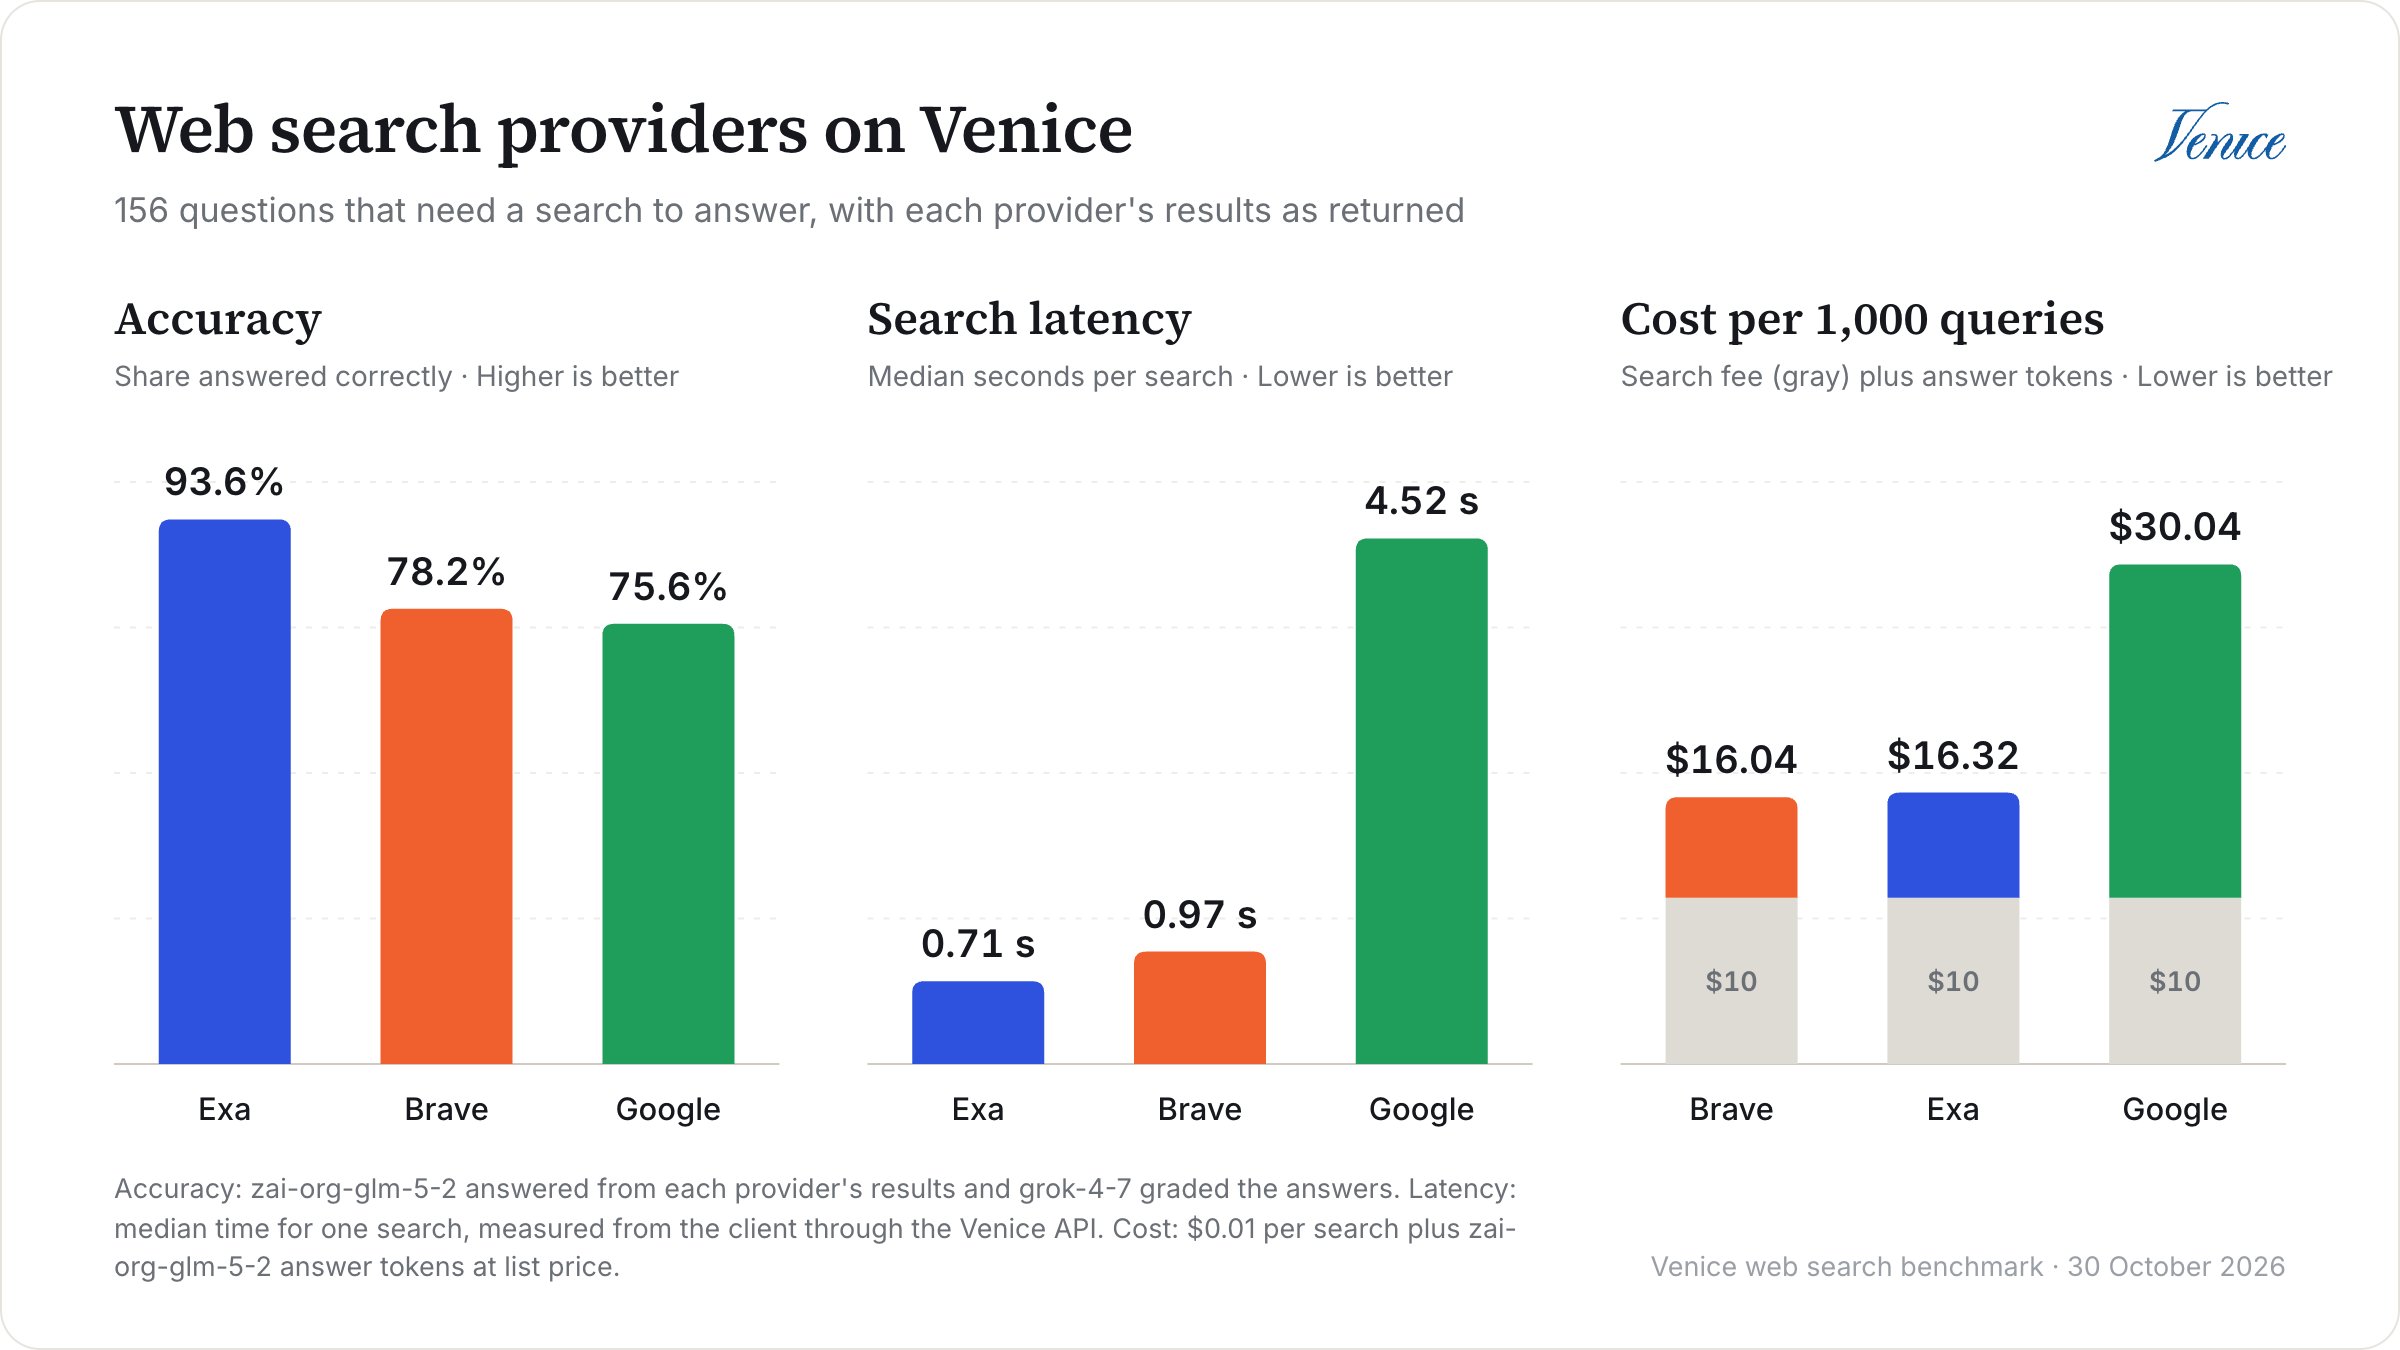
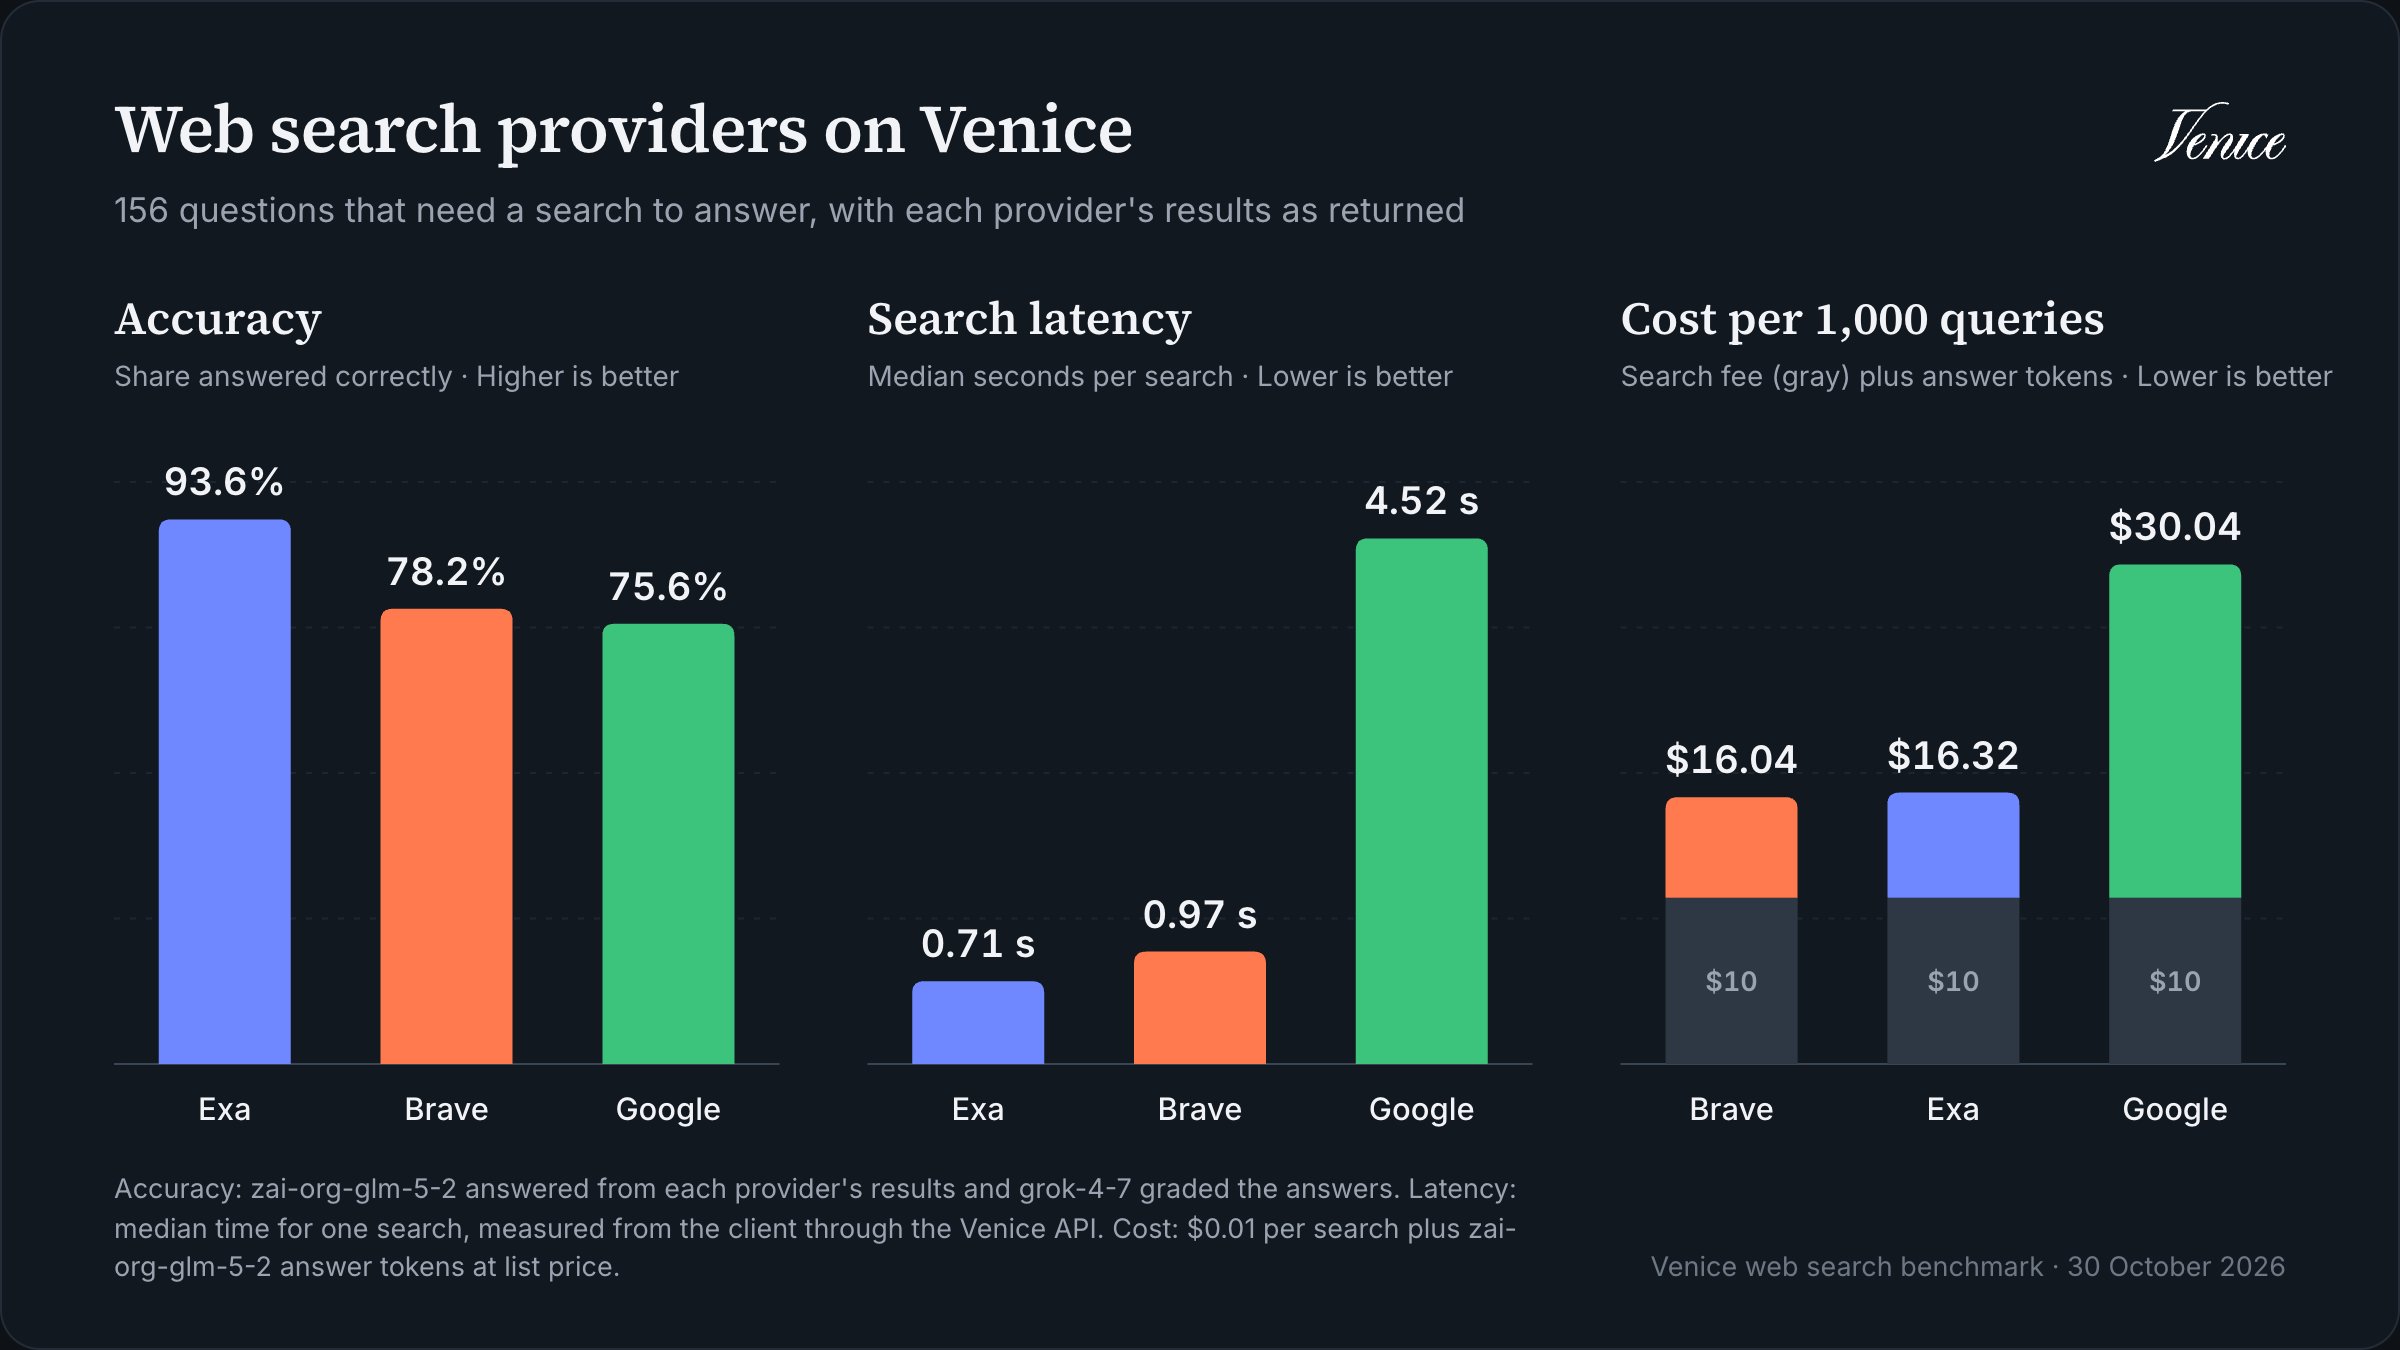
Exa 答对的问题最多
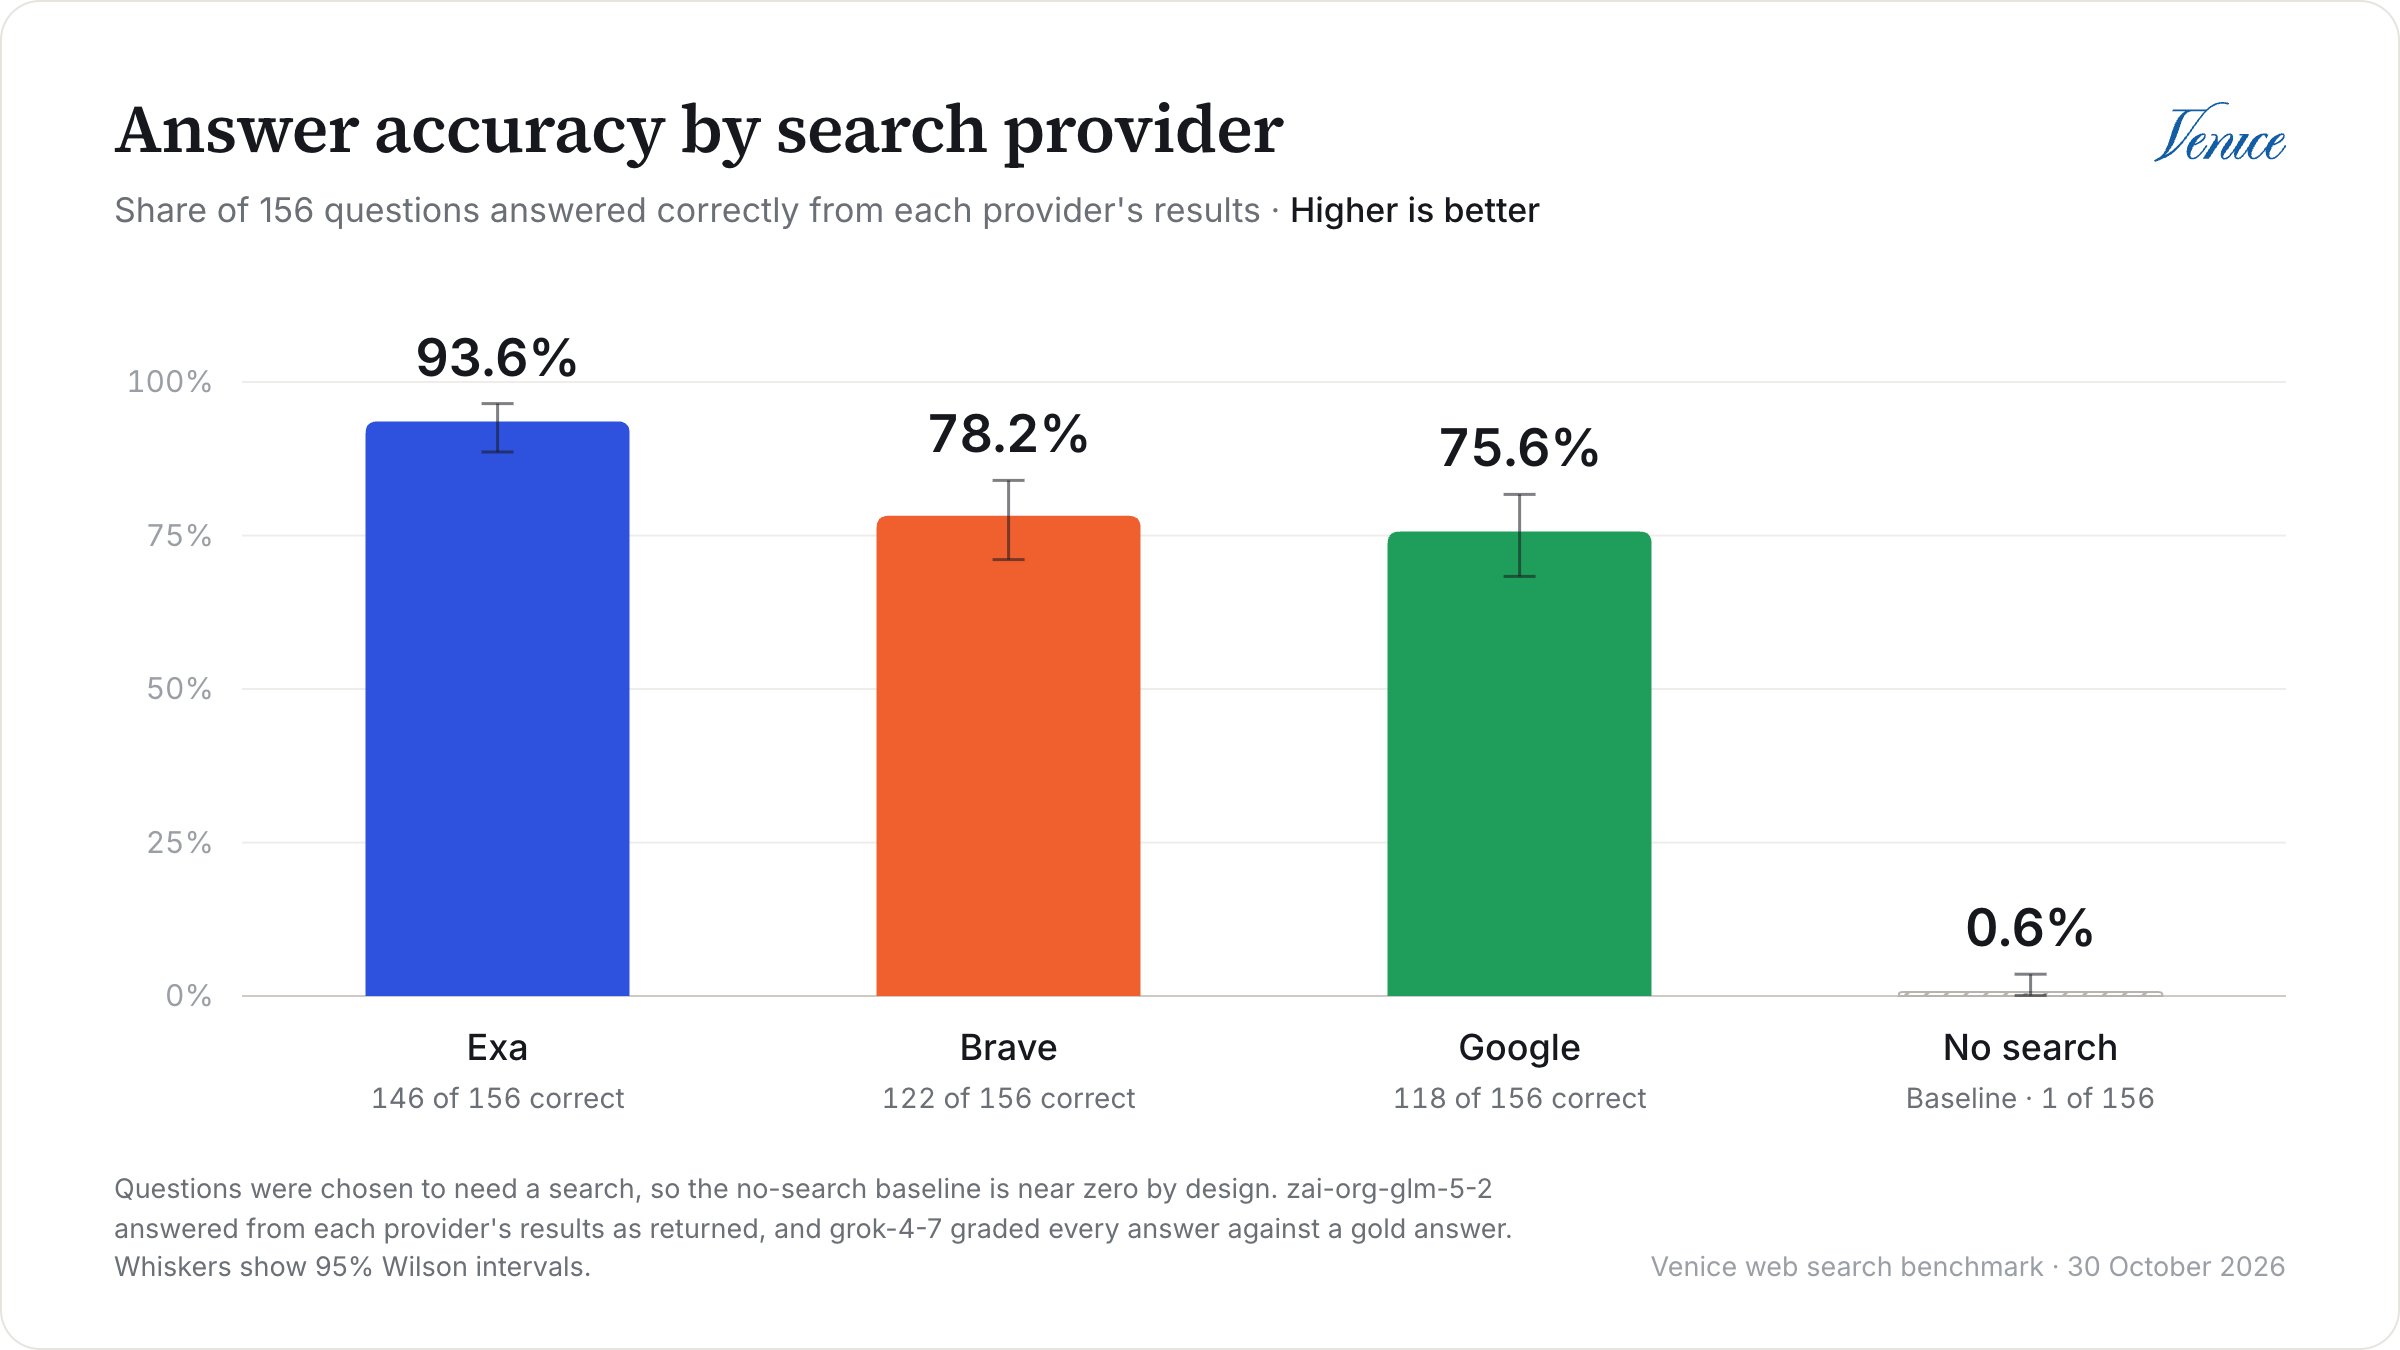
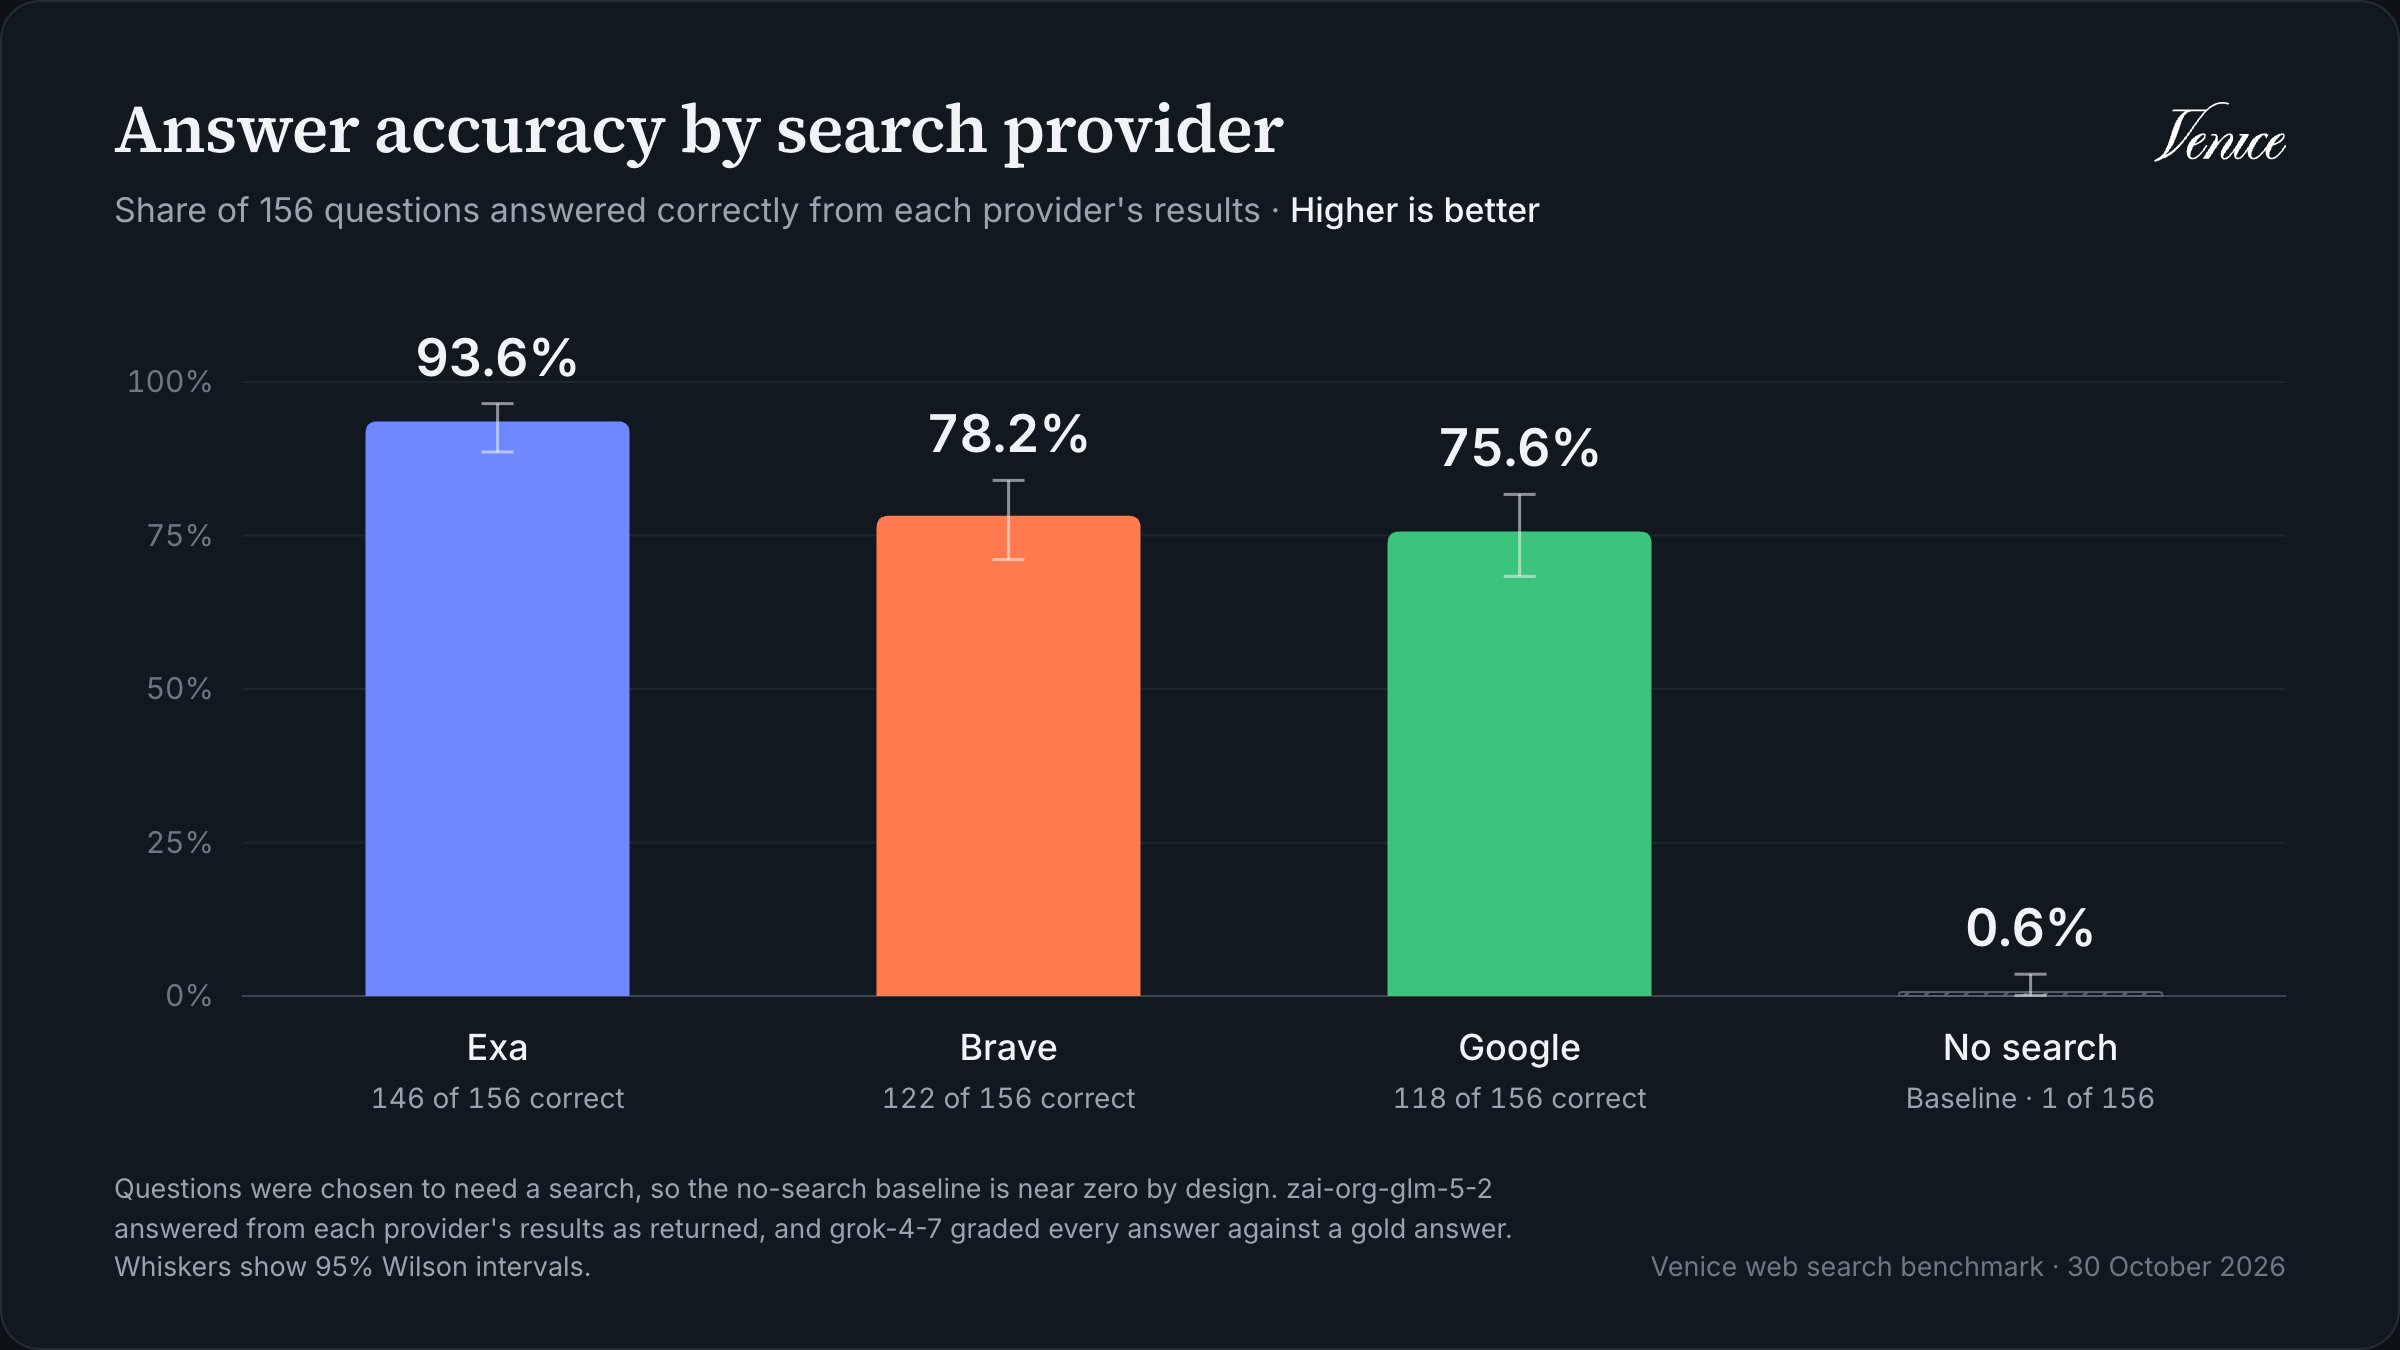
使用原始返回的全部结果时,Exa 答对了 93.6% 的问题,比 Brave 高约 15 个百分点,比 Google 高 18 个百分点。这一次差距很明显:Exa 答对了 28 个 Brave 答错的问题,反过来只有 4 个;Exa 答对了 33 个 Google 答错的问题,反过来只有 5 个(两者 McNemar p < 0.001)。
为了确认这不是偶然,我们在 11 月 11 日用相同设置重新运行了完整的基准测试,结果也放在仓库里。Exa 再次位居第一,为 93.6%,Brave 为 81.4%,Google 为 72.4%,Exa 领先 Brave 12.2 个百分点(24 个问题对 5 个,p = 0.001)。
Brave 与 Google 之间则没那么明确。在这次运行中,两者打平,为 22 个问题对 18 个,完全在噪声范围内。在重新运行中,Brave 领先,为 29 个问题对 15 个(9.0 个百分点,p = 0.049)。所以根据运行的不同,Brave 与 Google 持平或领先于 Google。
我们还想知道 Exa 的领先是否源于问题的措辞,因为我们是原样搜索问题的,而实际应用通常会先把问题改写成搜索查询。所以在 11 月 10 日的另一次运行中,我们让模型把每个问题改写一次为搜索引擎查询,把同一个查询发给三个提供商,并为针对原始问题的回答打分。Exa 仍领先 Brave 13.5 个百分点(24 个问题对 3 个),且没有任何提供商的分数发生显著变化,因此措辞无法解释 Exa 的领先。
不搜索时的回答也值得一看。在不搜索的情况下,模型告诉我们在收到 429 后读取
Retry-After 响应头,而不是 Venice 的 x-ratelimit-reset-requests;它还编造了一个通过模型名称开启网页搜索的 -web-search 后缀,并列出了一个并不存在的 venice 搜索提供商。如果你的用户询问新的或小众的 API,仅靠模型自身的知识是不够的。
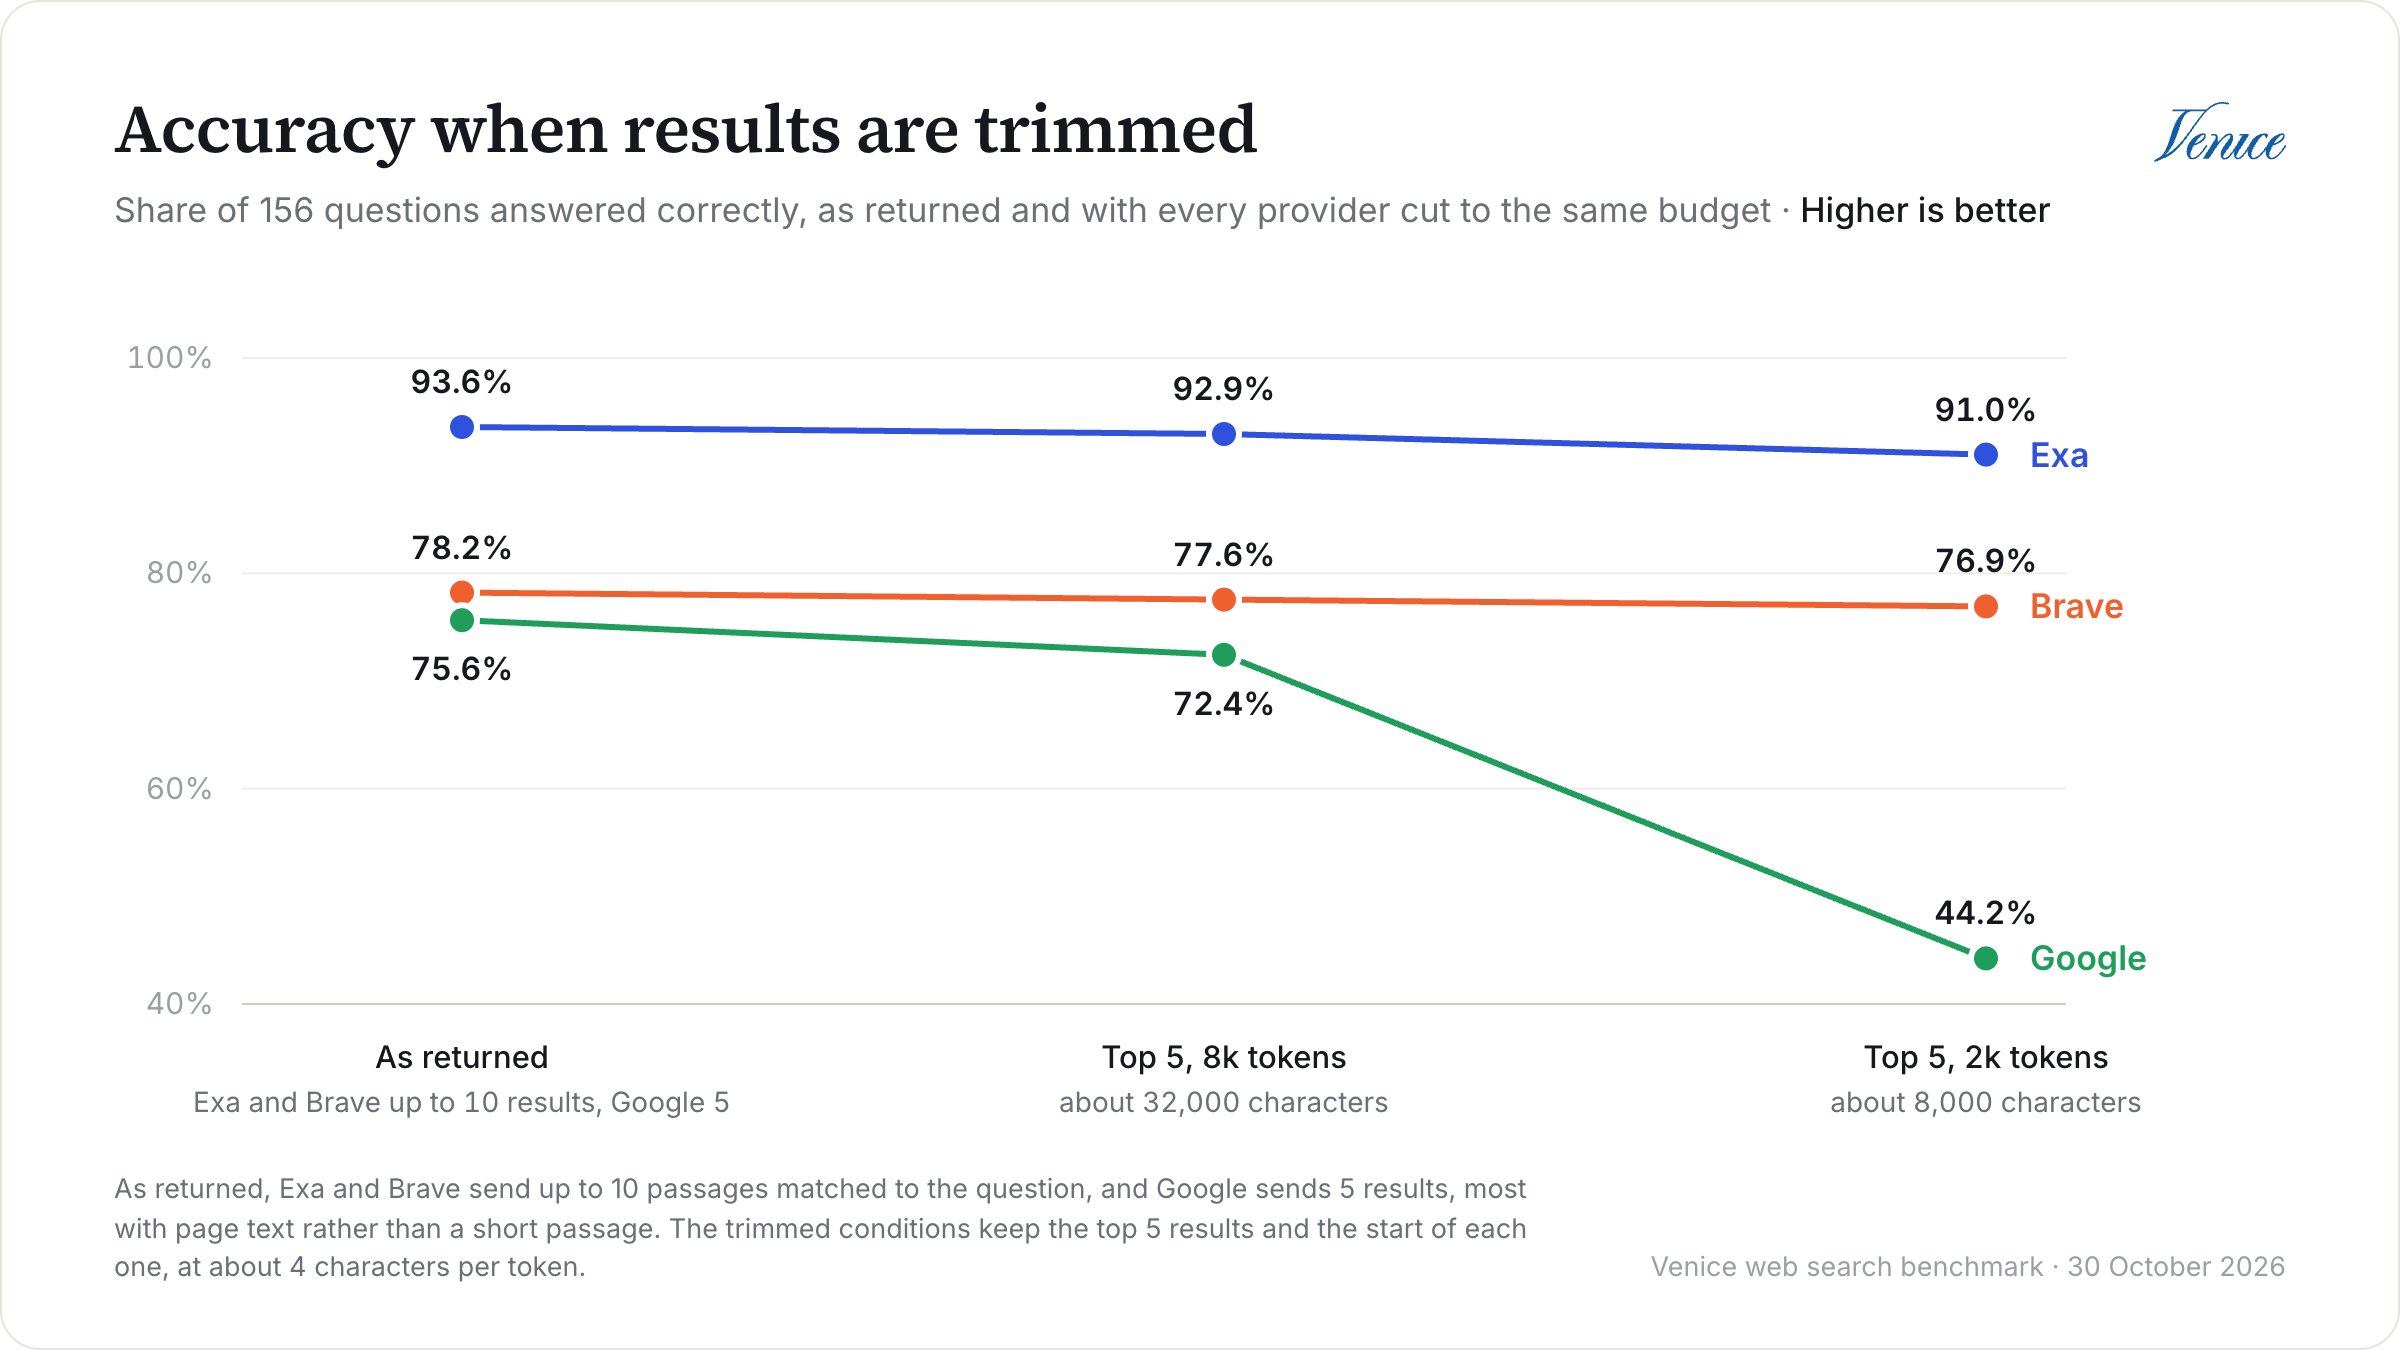
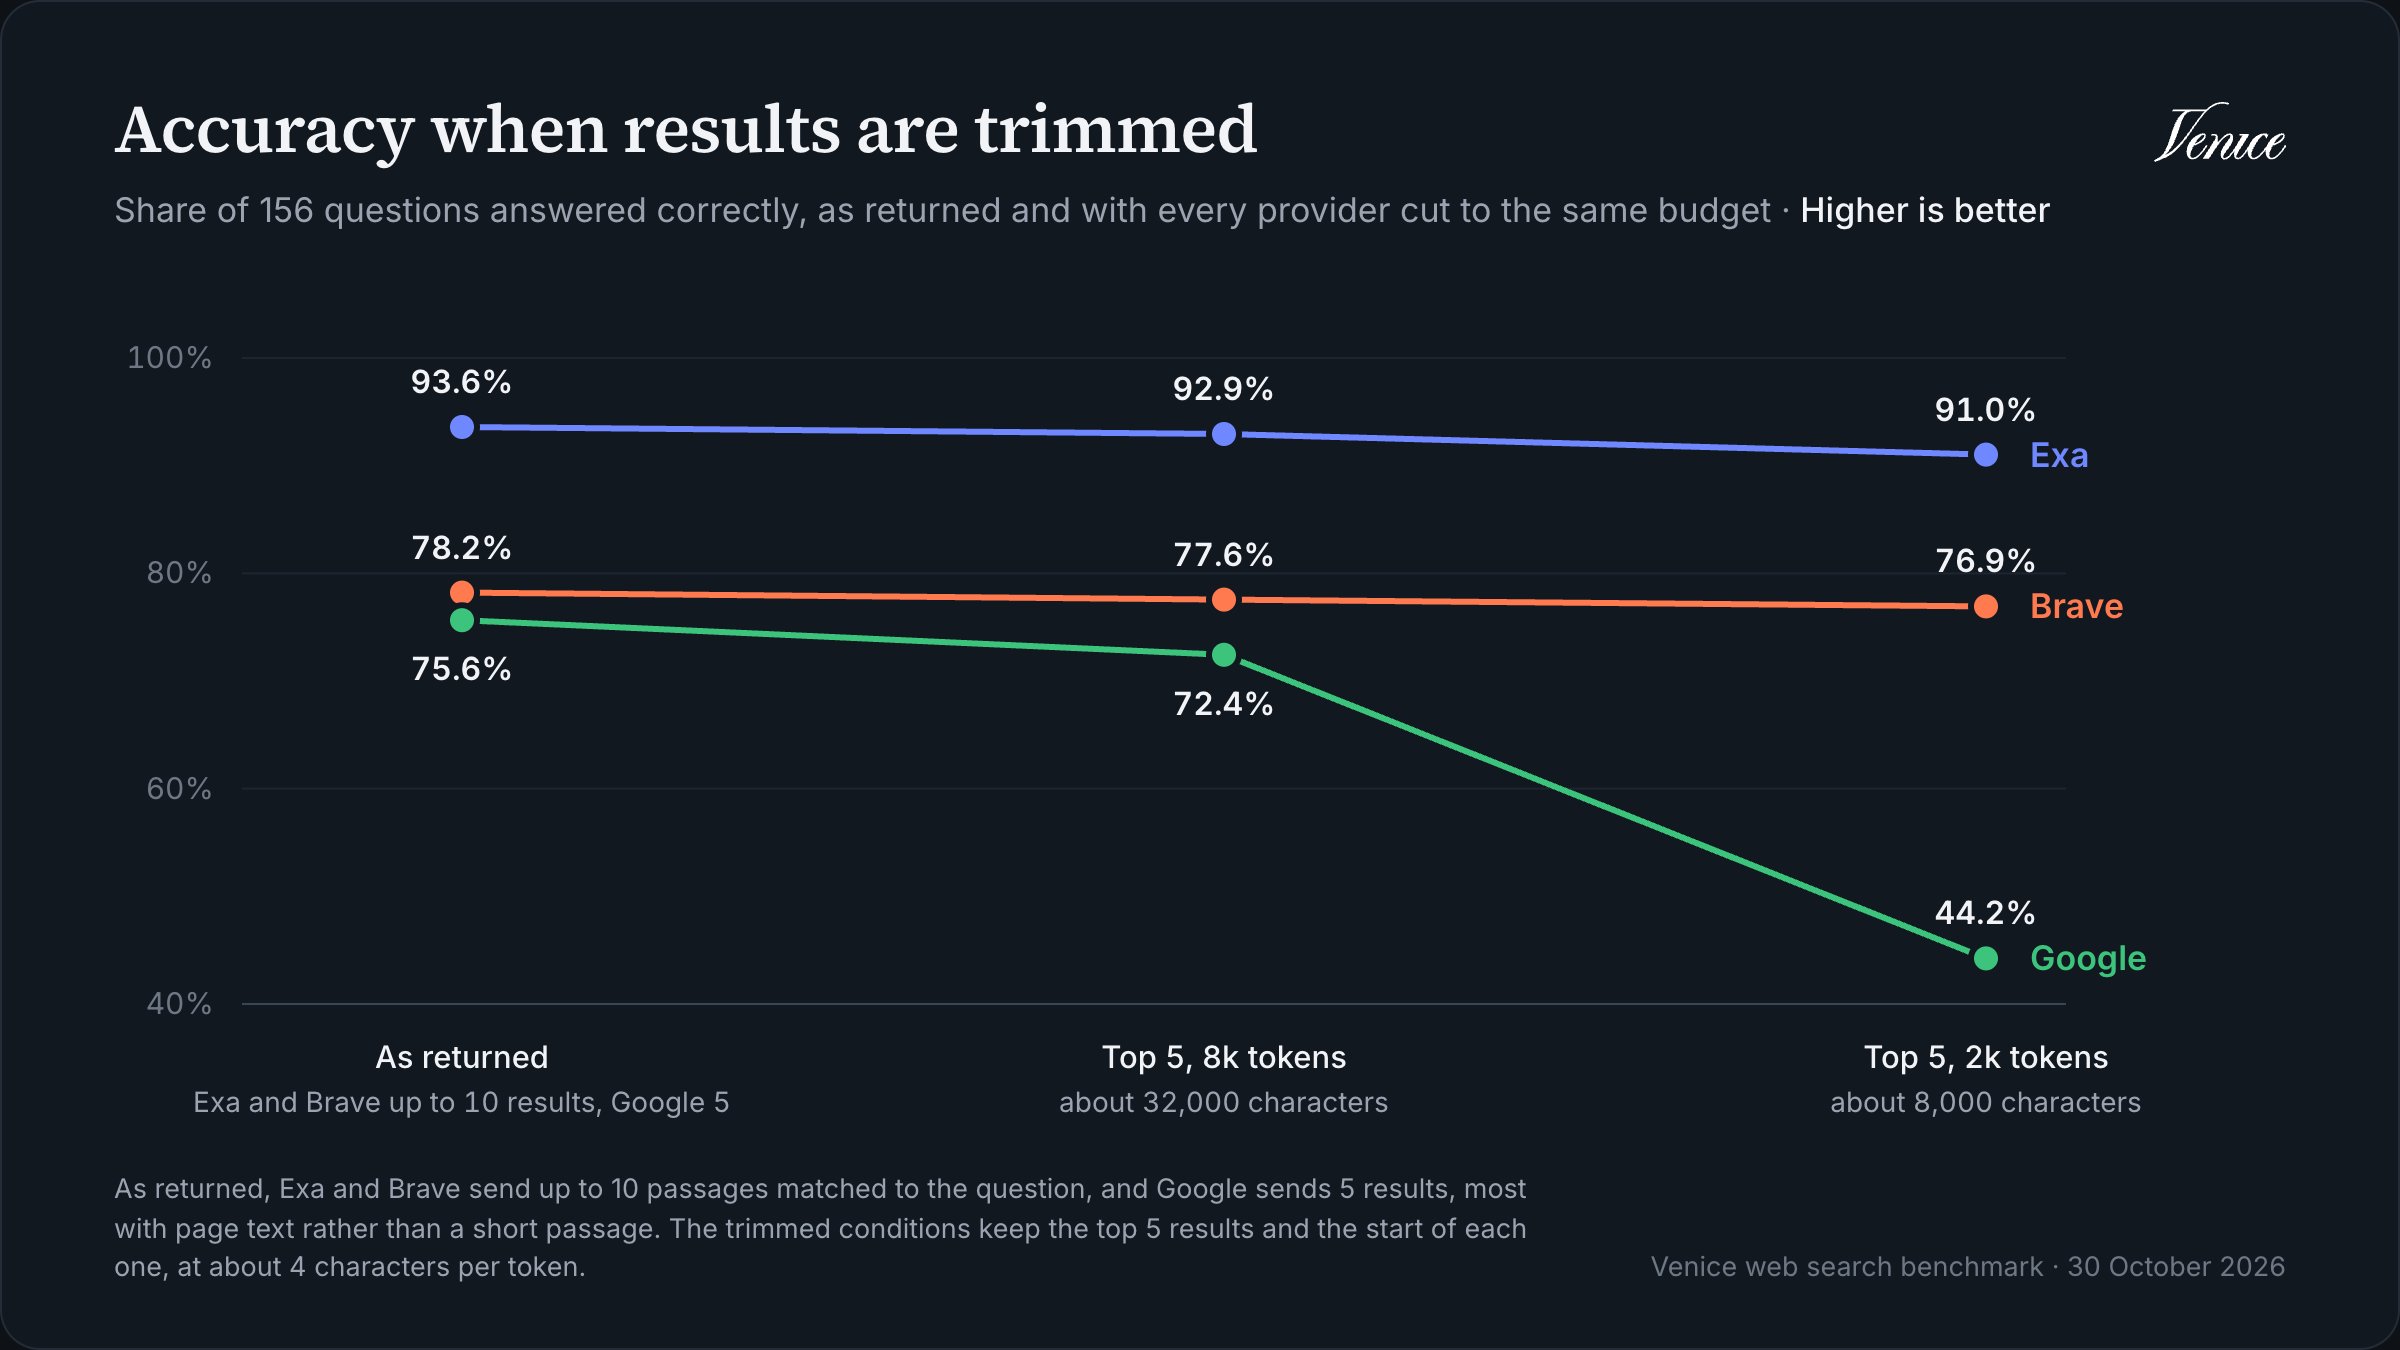
有预算限制的条件正是 Google 失手的地方。在 2,000 个 token 时,它的准确率降到 44.2%,模型有 30% 的问题找不到答案,而使用 Google 完整结果时这一比例为 10%。由于 Google 的结果从页面顶部开始,截断后保留了导航栏和横幅,却把回答问题的部分删掉了。Brave 和 Exa 的结果本来就是与问题匹配的段落,所以截断几乎没有影响。在 8,000 个 token 时,Google 恢复了大部分,回到 72.4%。
Exa 的领先从何而来
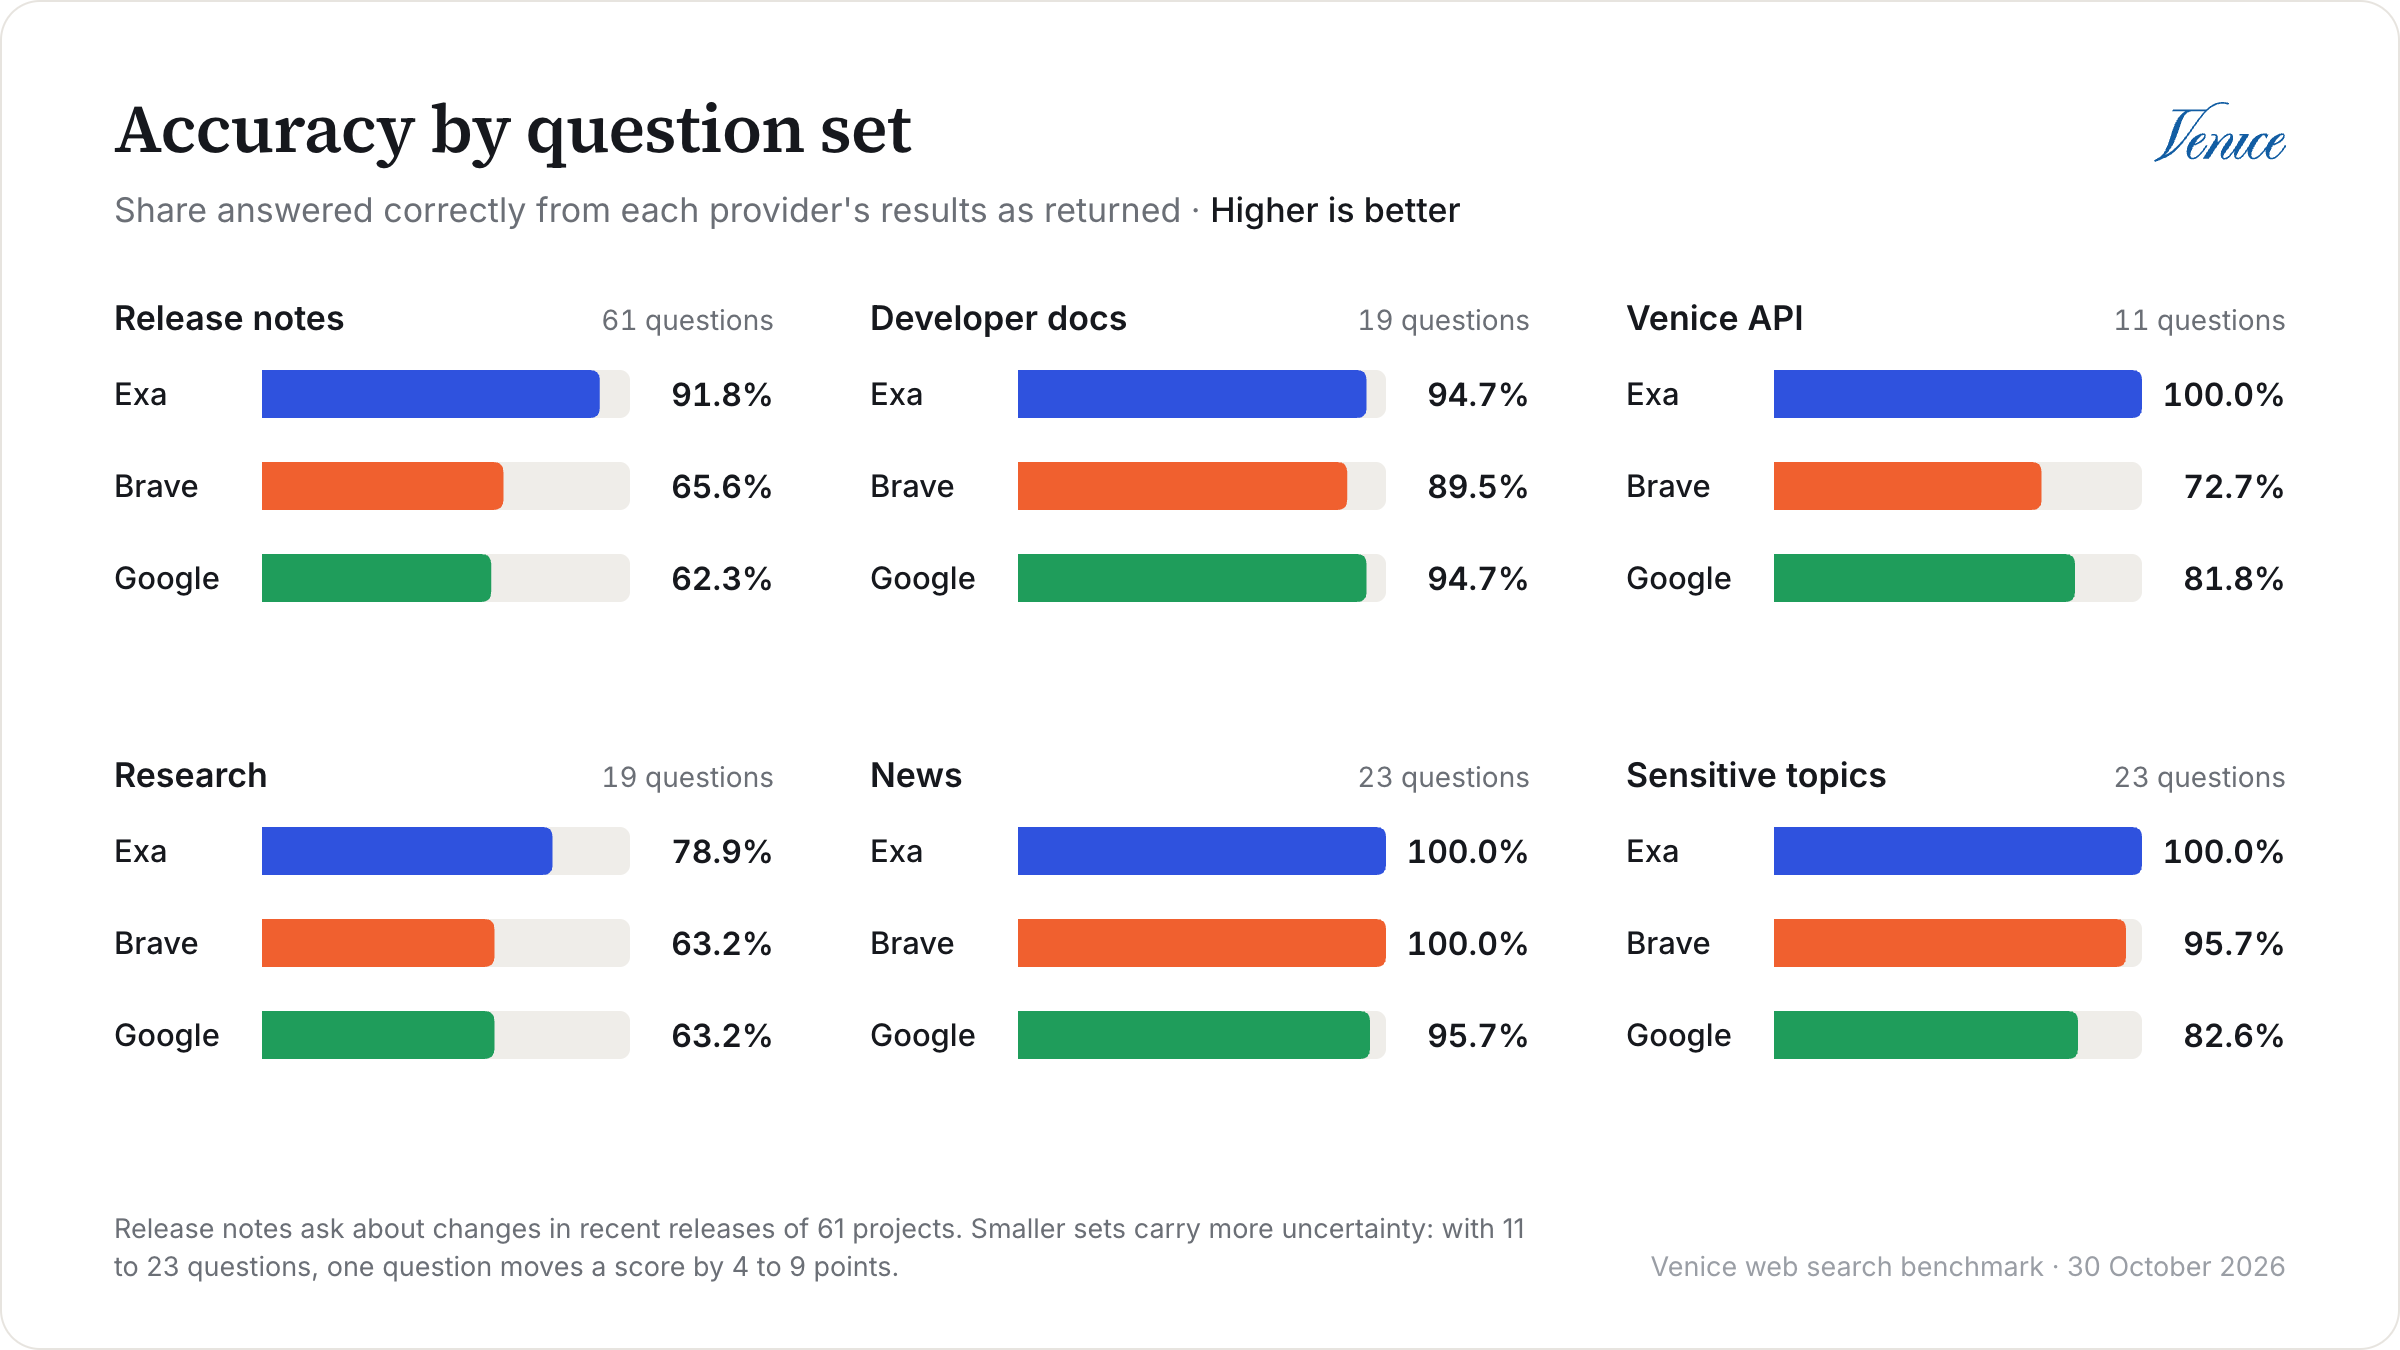
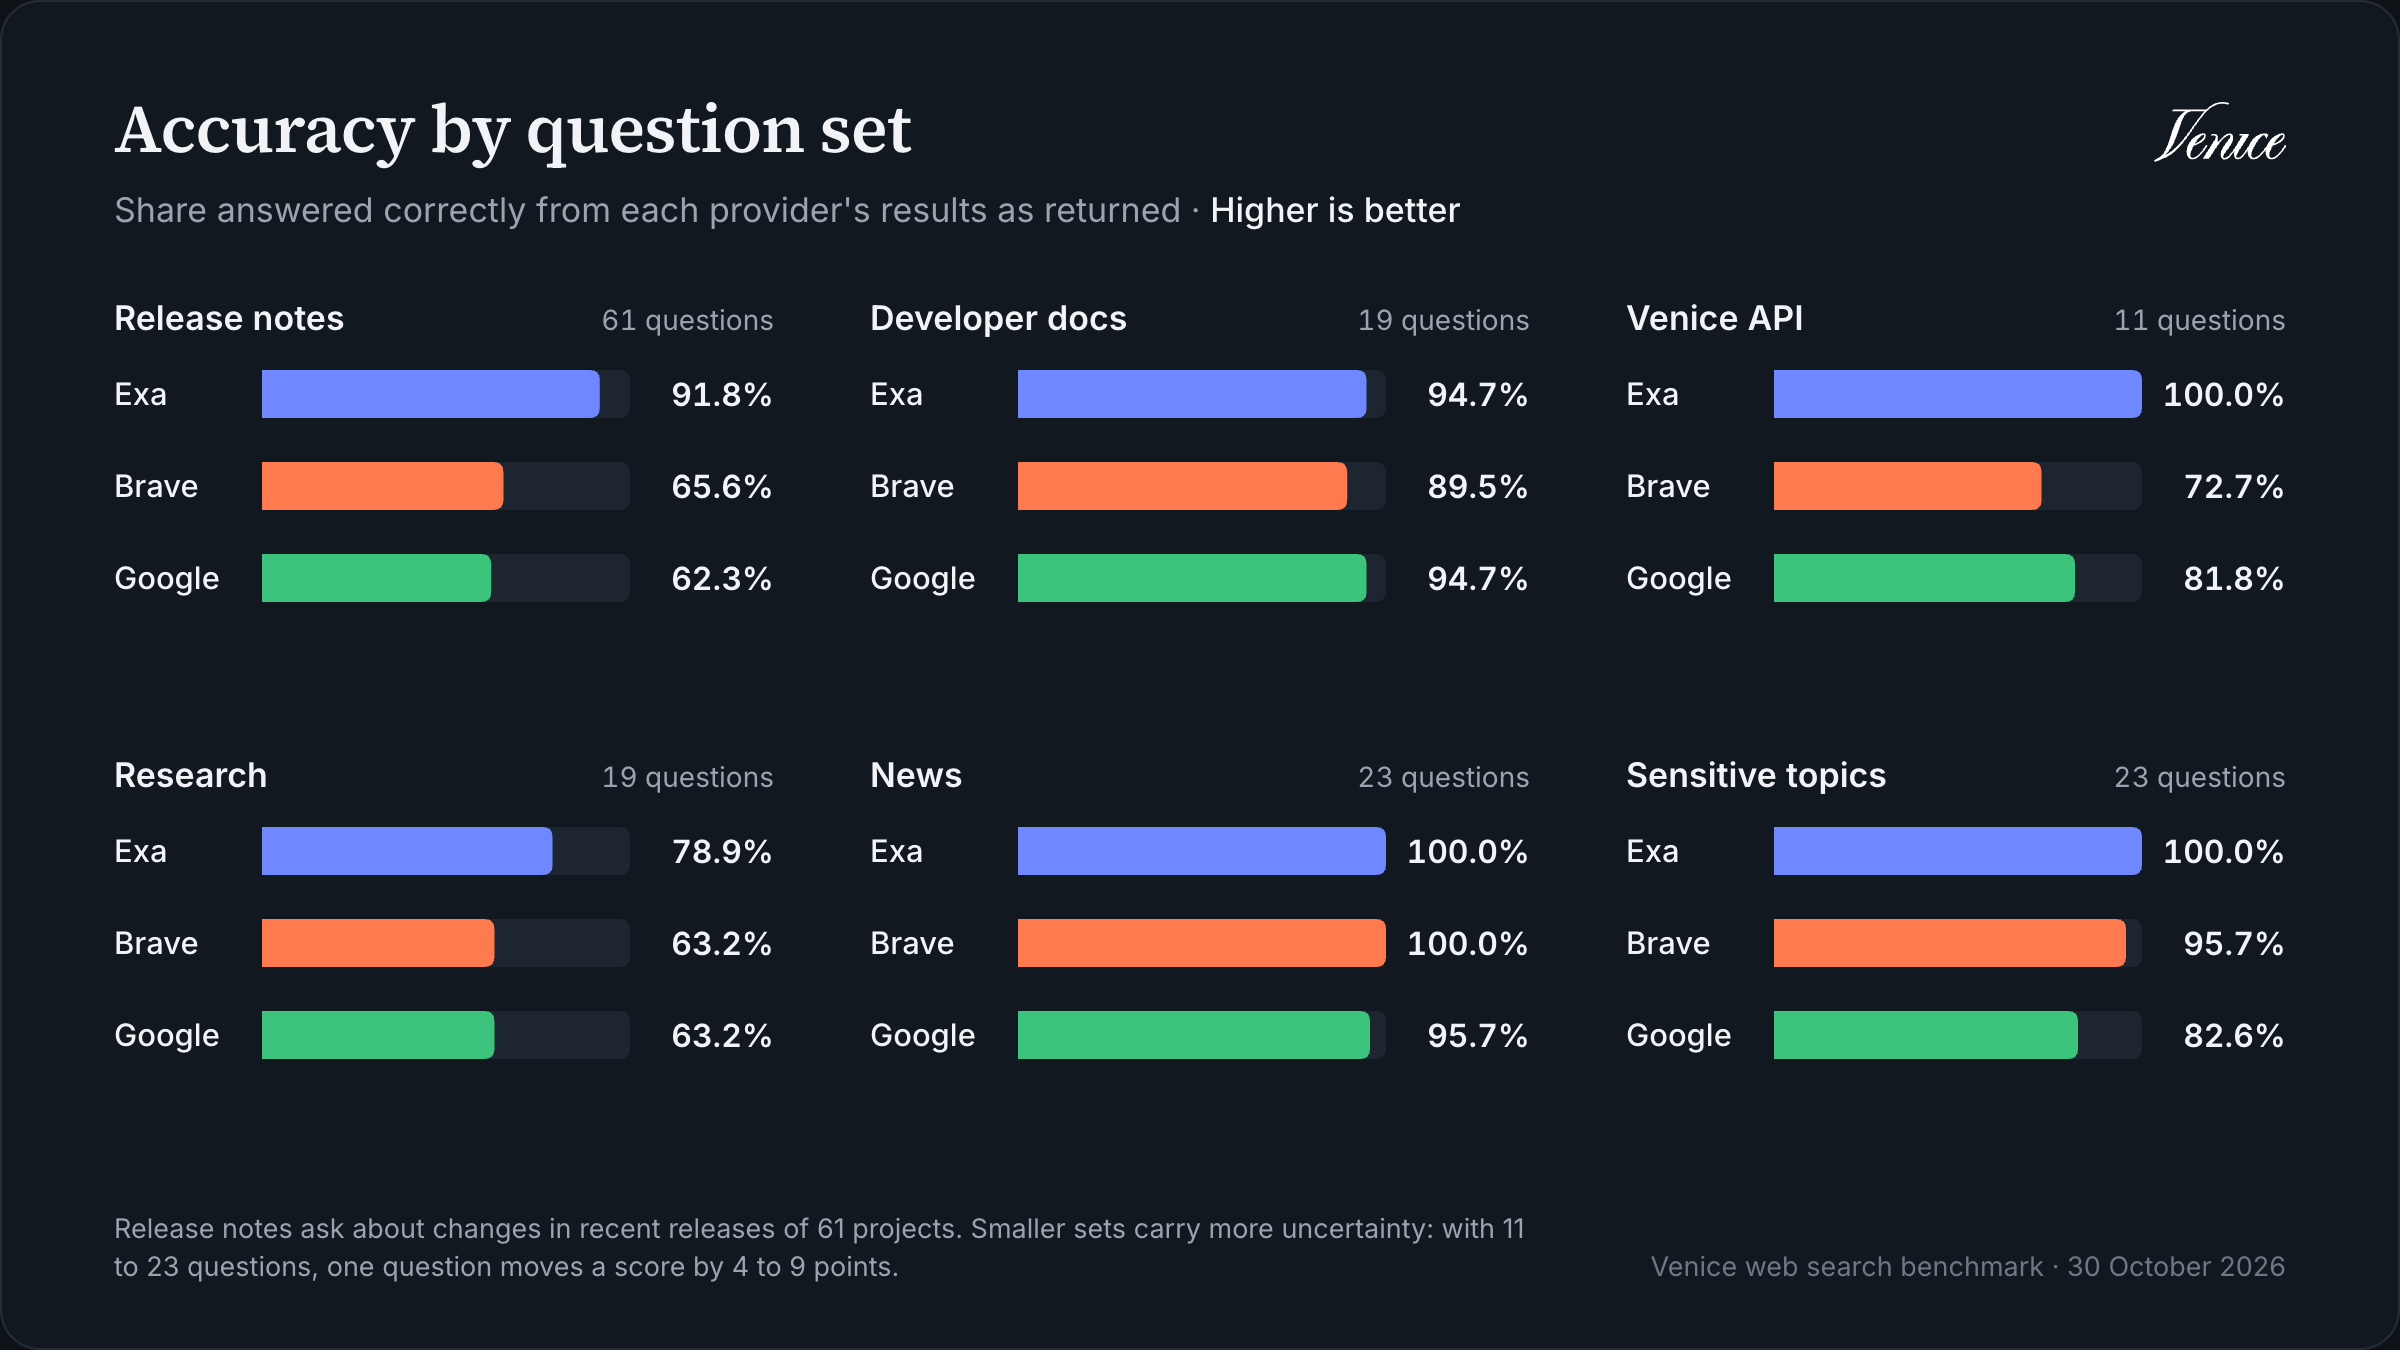
大部分差距来自一个地方:发布说明。Exa 答对了 61 个发布问题中的 56 个,而 Brave 答对 40 个,Google 答对 38 个。这类问题的答案通常就在变更日志的某一行里,而 Exa 的结果包含这一行的可能性要大得多。在涉及已知标识符(例如某个 flag 或环境变量)的发布问题上,Exa 的结果原样包含了其中 97%,而 Brave 为 76%,Google 为 68%。在所有编程问题集中的绑定版本问题上,Exa 答对了 95%,另外两个只有 55%。
研究问题对所有提供商来说都是最难的,因为它们需要来自两个不同页面的两个事实,即使是 Exa 也只答对了 19 个中的 15 个。而在新闻和开发者文档上,三个提供商几乎全部答对。如果你的用户问题与此类似,选哪个提供商的影响就小得多。
敏感话题怎么样?
有些搜索服务会过滤或压低敏感话题的结果,所以我们加入了 23 个问题,检查这三个提供商是否有这种情况。这些问题涵盖毒品法、堕胎、性工作、枪支、监控和断网等话题,每个问题都有来自官方来源的事实性答案,例如法院判决或政府通告。 在这些问题上,没有任何提供商返回空结果或错误,模型也从未因话题而拒绝回答。Exa 答对了全部 23 个,Brave 答对 22 个,Google 答对 19 个。答错的都是普通的搜索失误,即结果中没有相关事实或给出了不同的日期,只有一个 Google 回答语气含糊但给出了正确日期,评审对它判得过严。请注意,23 个问题只能说明我们没有发现过滤,而不能说明任何地方都没有过滤。Exa 返回的文本最有用
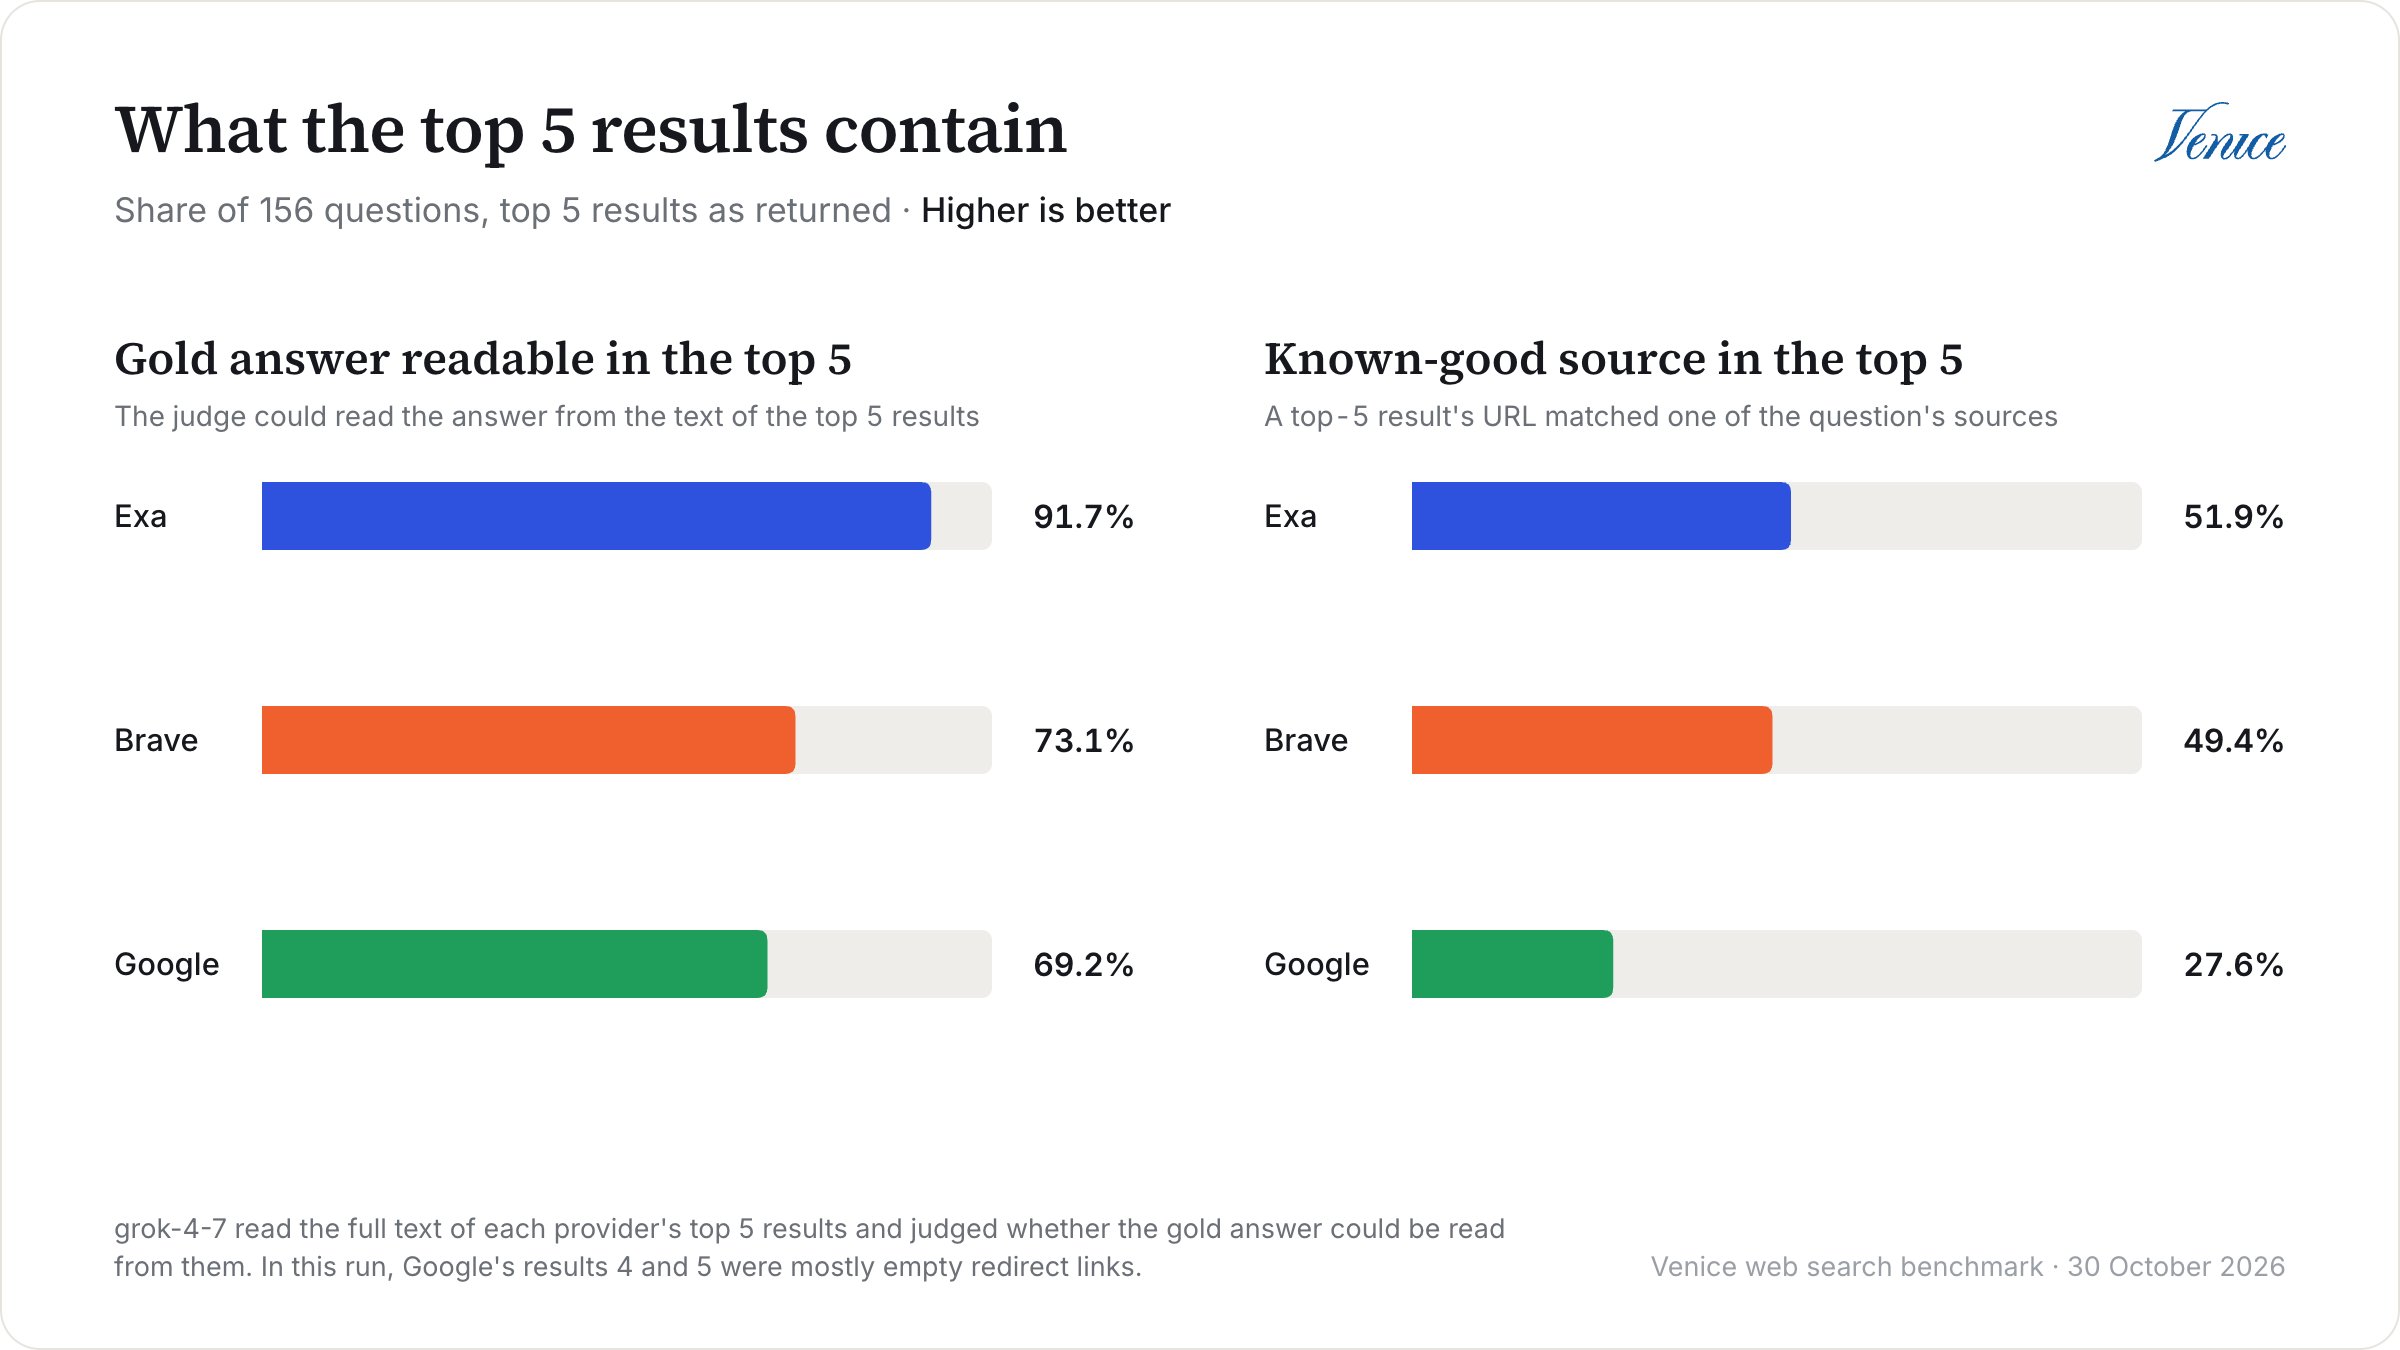
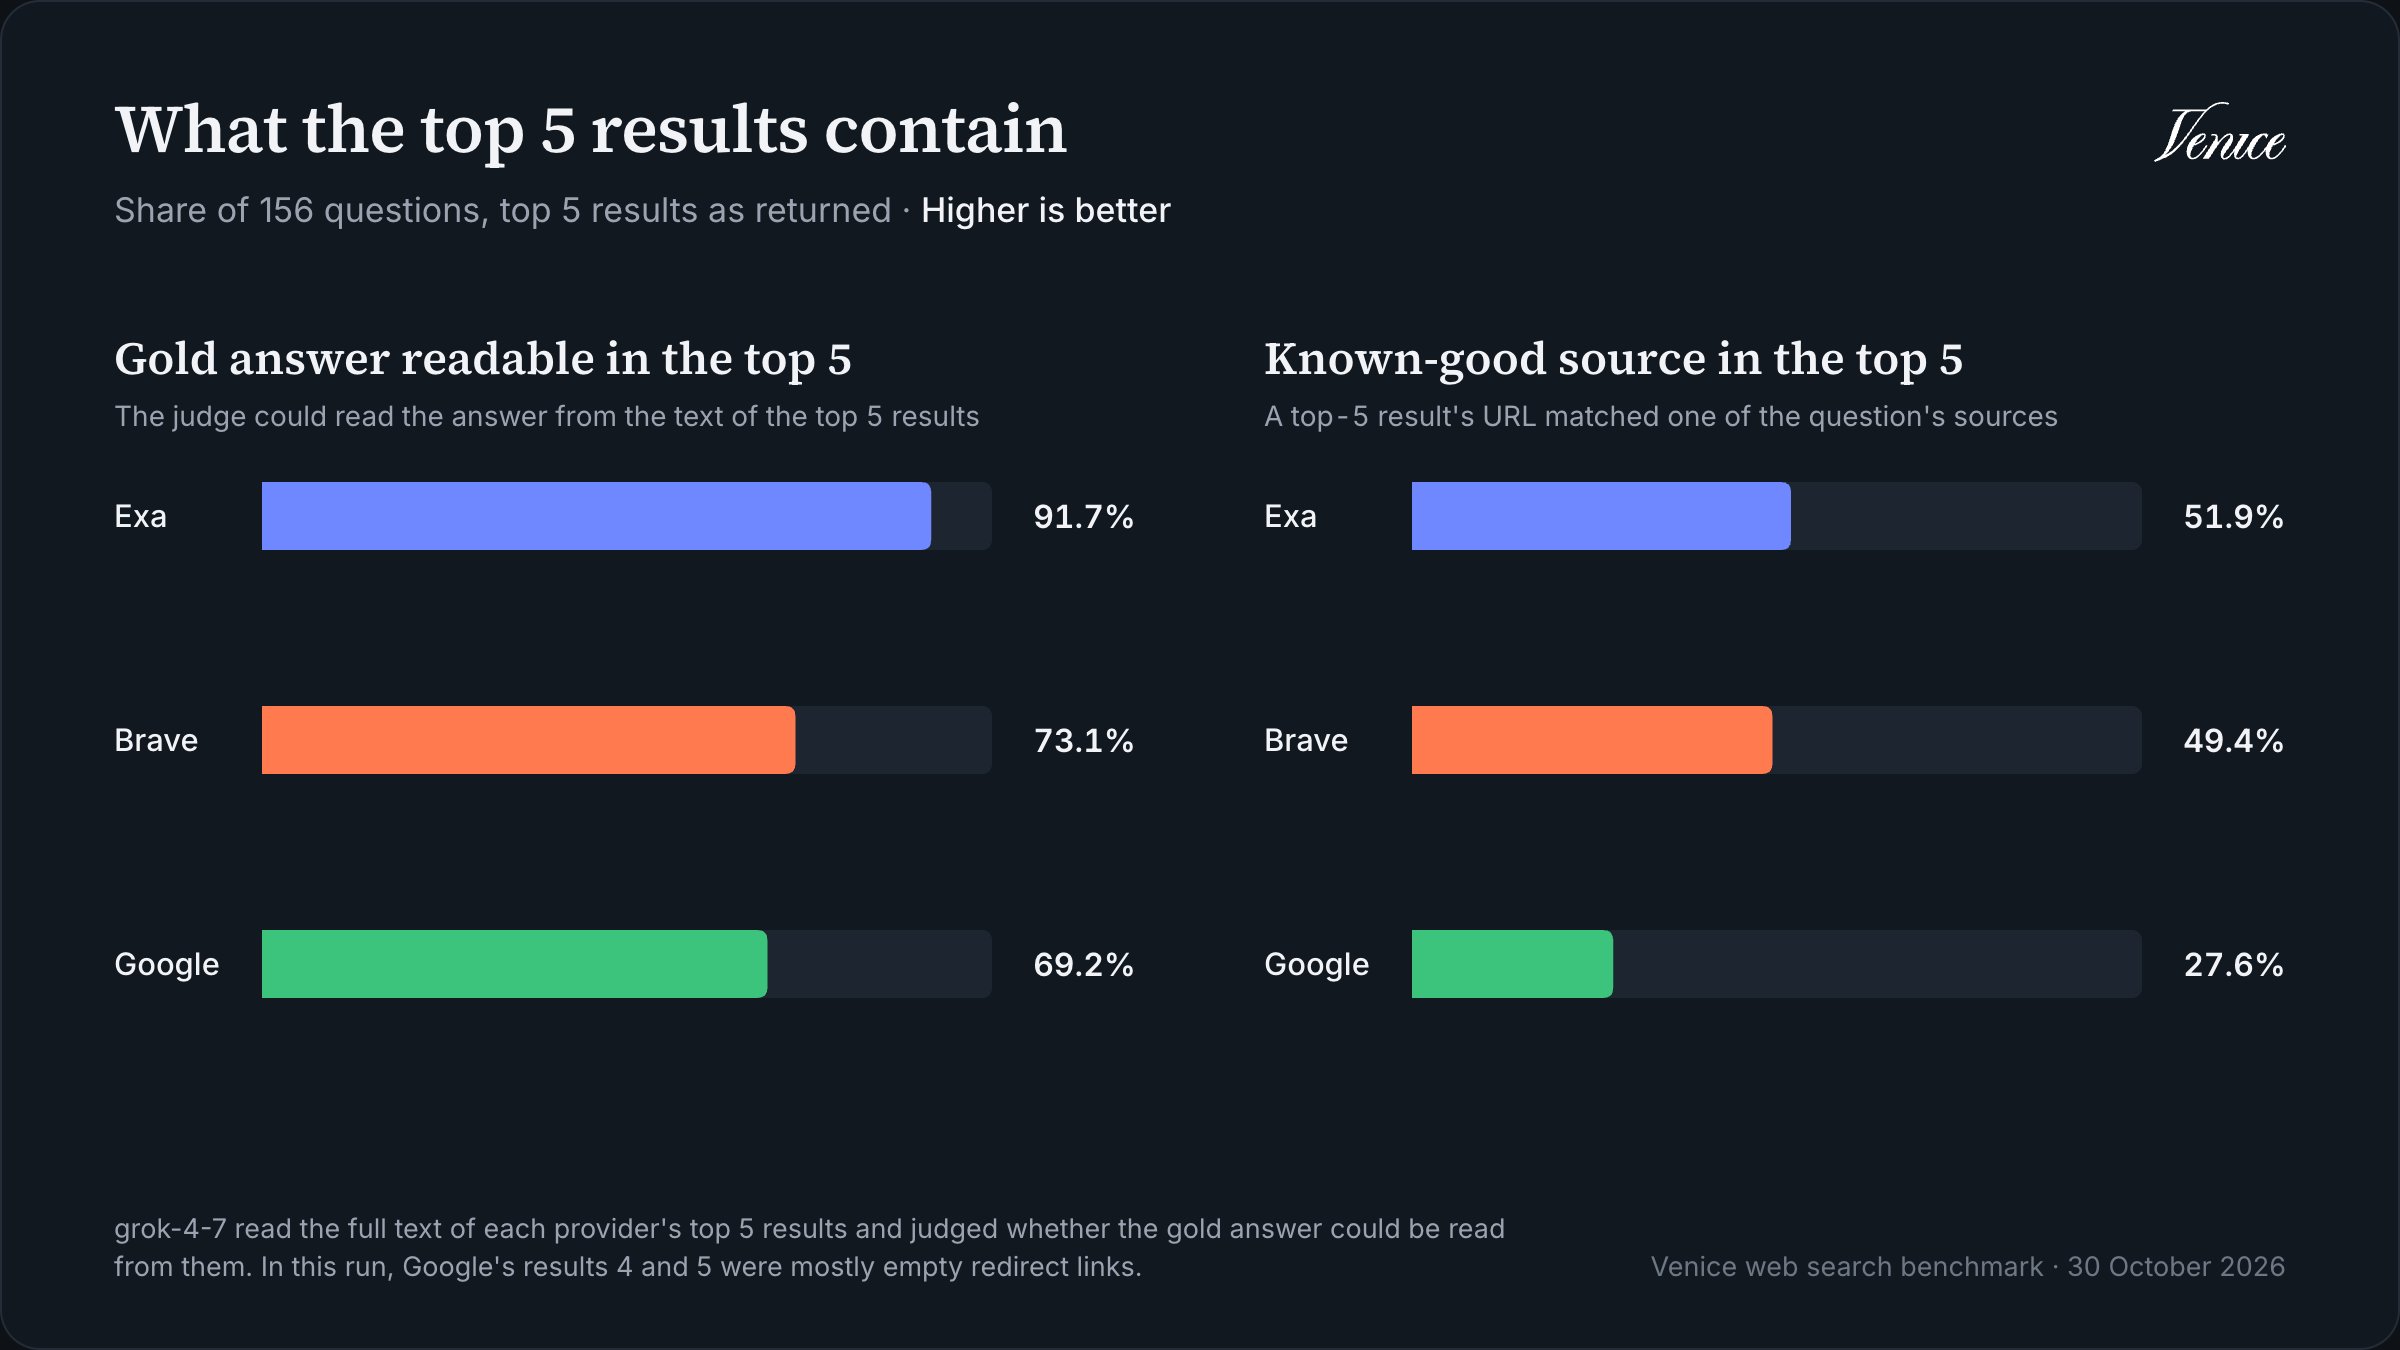
Exa 的结果也是最相关的。它的 nDCG@5 比 Brave 高 0.15(95% CI 0.11 到 0.19),比 Google 高 0.32(95% CI 0.28 到 0.36),而 Brave 比 Google 高 0.17。
不过,这里 Google 的数字包含一个后来已经修复的问题。在这次运行中,162 次搜索里有 144 次,Google 的第 4 和第 5 条结果是
google.com/goto?url=… 重定向链接,而且大多几乎没有文本,所以 Google 前 5 条结果中约有三分之一接近空白。到 11 月 11 日重新运行时,这些链接已经消失,Google 的 nDCG@5 从 0.43 升到 0.47,gold URL hit@5 从 27.6% 升到 31.4%。Exa 和 Brave 依然领先。
不过,这个分数衡量的是每个提供商返回的文本,而不仅仅是它选中的页面。当两个提供商返回同一页面时,评审在 71% 的情况下给两个副本打了相同的分数;分数不同时,较短的副本在 69% 的情况下得分更低。为了把两者分开,测试工具还会按任一提供商返回的该页面副本中的最高分为每个页面打分。按这种页面级指标,Exa 对 Brave 的领先缩小到 0.09(95% CI 0.05 到 0.13),但并未消失,而且两者选中的页面都比 Google 好。请注意,这只对多个提供商都返回过的页面起到拉平作用。其余页面仍按各提供商自己的文本打分。
Brave 和 Exa 成本相近,Google 成本最高
搜索本身在每个提供商上的价格都是每 1,000 次查询 $10,所以成本差异来自之后发送给模型的 token。Brave 和 Exa 的成本大致相同,而 Google 的页面文本使回答提示词约为 Brave 的 3.6 倍,几乎让每次查询的成本翻倍。这些成本使用
zai-org-glm-5-2 的标价,没有缓存折扣,所以具体数字取决于你使用的模型,但各提供商之间的比例依然成立。
这次 Exa 的中位延迟最快,为 0.71 秒,Brave 为 0.97 秒,但我们不会给这两者排名:在前一天的第一次运行中 Brave 更快,当时 Exa 的中位数为 1.73 秒;在 11 月 11 日的重新运行中 Brave 也更快,为 0.99 秒对 1.54 秒。延迟是通过 Venice API 在客户端测量的,因此包含网络时间和 Venice 自身的开销,并且在不同运行之间会有波动。在三次运行中始终成立的是:Brave 和 Exa 的中位延迟都低于 2 秒,而 Google 每次都是最慢的,这里为 4.52 秒,重新运行时为 5.36 秒。
通用问题
6 个通用问题没有标准答案,所以评审改为对每一对提供商的回答进行正面比较,并交换顺序比较两次。Exa 的回答在其中 4 个问题上胜过 Google,但只有 6 个问题,我们不会以此为依据。完整的细分结果见报告。那么,你该用哪一个?
根据这次运行,我们会这样选择:- Exa,适用于大多数直接把结果交给模型的工作负载,尤其是编程助手和研究智能体。它在每个问题集上的准确率都是最高或并列最高,结果也最相关,而每次查询的成本与 Brave 大致相同。
- Brave,如果你的问题更像我们的新闻和文档问题(在这些问题上它与 Exa 持平),或者你主要需要找到某件事的官方页面(它做到这一点的频率与 Exa 相当)。它是默认提供商,速度快、成本低。
- Google,如果你希望直接从搜索响应中获得页面文本,而不需要单独抓取。大多数结果是完整页面,但当网站阻止抓取时,约四分之一的结果只有摘要片段。你需要为额外的 token 和延迟留出预算;如果要截断结果,请保留与问题匹配的段落,而不是每个页面的开头。
注意事项
在过度解读这些数字之前,有几点需要注意:- **问题是专门挑选出需要搜索的。**我们剔除了模型自己就能回答的所有问题,因此这个问题集比日常流量更难。
- **问题由 AI 智能体编写。**每个问题都对照来源进行了检查和审阅,但标准答案仍可能有误。如果你发现了错误,请在仓库中提交 issue。
- **发布说明在问题集中占了很大一部分。**它们占 156 个标准答案中的 61 个,而 Exa 的大部分领先也来自这里,所以请将按问题集划分的表格与你自己的工作负载进行对照。
- **分数来自模型。**我们检查了评审在使用原始返回结果时未判为正确的每个回答,共 82 个,另外还检查了 30 个判为正确的回答。我们会修改其中 6 个,全部是从错误改为正确:Brave 3 个,Google 2 个,Exa 1 个。这样 Brave 为 80.1%,Google 为 76.9%,Exa 为 94.2%,排名不变,但评审略偏严格。
- **搜索结果会变化。**这些数字是 2026 年 10 月的快照,时效性强的标准答案,尤其是新闻类问题,会过时。我们 11 月 11 日的重新运行保持了 Exa 的排名,但 Brave 与 Google 的对比以及 Google 的相关性分数发生了变化。
- **我们的主要运行是原样搜索每个问题的。**在 11 月 10 日的重新运行中,把问题改写为搜索查询并没有改变排名,但你的应用自己的改写方式可能会。
- **我们是通过 Venice 的 API 测试这些提供商的。**每个提供商都以自己的格式返回结果,因此这些数字描述的是 API 返回的三种选项,而不是一般意义上的搜索引擎。
- **相关性分数取决于返回的文本量。**简短的摘录可能比同一页面较长的副本得分更低。按页面计算的分数会对多个提供商都返回过的页面进行校正,但其余页面不会。
- **有预算限制的条件是从末尾截断的。**按相关性挑选段落的流水线对 Google 结果的处理会比我们的更好。
- **所有回答都由同一个模型生成,问题筛选也用的是同一个模型。**换一个模型可能会更好(或更差)地利用长结果,也可能已经知道其中一些答案。
自己运行
测试工具是一个小型的 Bun 和 TypeScript 项目,没有运行时依赖。克隆仓库后,安装开发依赖并运行测试:.env 文件:
--budget,其默认值为 $5。我们的完整运行花费 $36.10:486 次搜索花费 $4.86,其余为回答和评审的 token 费用。估算不考虑缓存折扣,所以会更高,约为 $50。每次运行都会生成一个 report.md,包含本文背后的完整表格;一个 results.csv,每个问题、提供商和条件各占一行;一个 summary.json;以及两个包含每个回答和每个提供商结果列表的文件。
如果你只是想翻看我们的数据,根本不需要运行任何东西,因为仓库的 results 文件夹里已经有这次运行的所有这些文件。
不过,真正的价值在于用你自己的问题运行它。用 JSON Lines 格式编写问题,每个问题一个对象:
goldAnswer 的问题仍会获得检索分数,所以你可以先从日志中的真实查询列表开始,之后再补充标准答案。不过,在信任准确率数字之前,请先用 --arms none 检查模型能答对你多少问题,因为模型已经知道答案的问题无法区分你的提供商。