

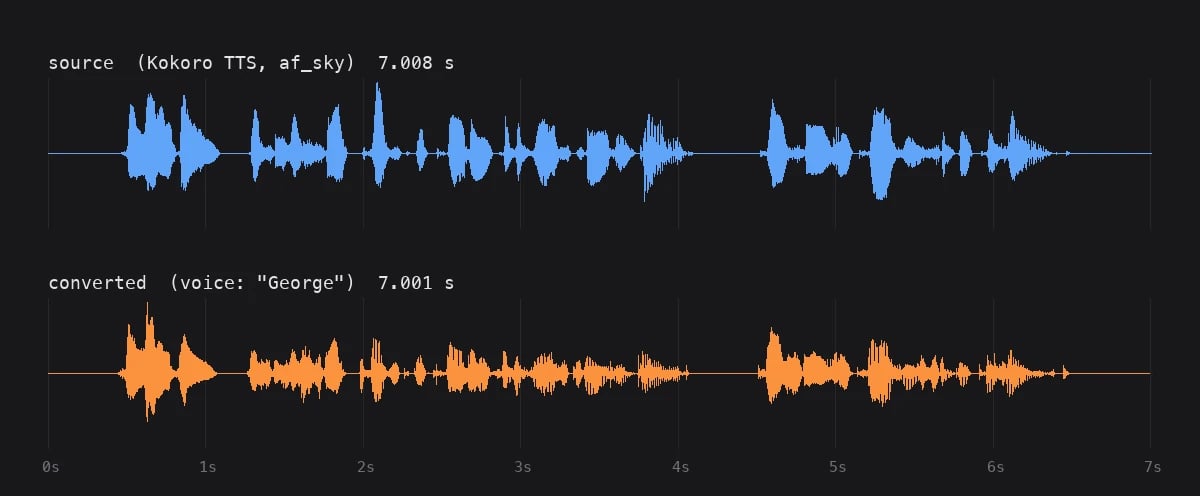
/audio/speech y el resultado de convertirlo a la voz George. Las formas de onda comparten el mismo eje temporal, y los silencios entre frases caen en los mismos puntos.
/audio/voice-changer/: quote calcula el precio de una duración, queue envía la grabación y te la cobra, retrieve se consulta hasta que el MP3 está listo, y complete elimina los medios almacenados una vez que los tienes. La estructura es la misma que la de los endpoints de música, pero la ruta es distinta y ninguno acepta los modelos del otro.
Los ejemplos asumen que VENICE_API_KEY está configurada:
Elige un modelo
Los modelos de cambiador de voz se encuentran enGET /models?type=music con model_spec.voice_changer establecido en true; no existe un filtro de tipo específico. Por ahora hay uno, elevenlabs-voice-changer: acepta orígenes mp3, wav, ogg, mp4 o aac de hasta 300 segundos, ofrece 20 voces con nombre con Aria como predeterminada, acepta un Voice ID de ElevenLabs sin procesar en lugar de un nombre, y admite remove_background_noise y seed. Estos detalles pueden cambiar, así que léelos desde la API. Esta consulta devuelve todo lo que necesita el resto de la guía:
400. Una grabación más larga que max_source_audio_duration_seconds devuelve 422 antes de cualquier cargo, con el límite indicado en el mensaje.
Hay algo que la API no comprueba al encolar: el nombre de la voz. Si encolas una voice que el modelo no tiene, igualmente recibes 200 y un queue_id; el rechazo llega en la primera llamada a retrieve, con el cargo reembolsado. Recuperas el dinero, pero pierdes el viaje de ida y vuelta, así que comprueba voices antes de encolar.
1. Obtén una cotización de precio
La facturación se basa en la duración de la grabación de origen, redondeada al minuto entero superior. Paraelevenlabs-voice-changer, son $0.35 por cualquier duración de hasta 60 segundos, $0.69 hasta 120, $1.04 hasta 180, $1.38 hasta 240 y $1.73 hasta 300. Un clip de 7 segundos cuesta lo mismo que uno de 60, y 60,5 segundos se facturan como dos minutos. Si tienes muchos segmentos cortos, únelos en un solo archivo que no supere el límite de un minuto en lugar de encolar cada uno por separado. Los niveles proceden de pricing.durations en /models.
Quote acepta un número entero de segundos y no necesita clave de API:
2. Encola la conversión
Envía la grabación como una carga multipartfile o como un audio_url en un cuerpo JSON, pero no ambas cosas. Una URL debe ser accesible públicamente sin encabezados ni cookies; Venice obtiene los bytes por sí mismo y nunca transfiere la URL al proveedor. Venice comprueba los bytes, no la extensión, así que el archivo tiene que ser realmente uno de los contenedores aceptados, y los archivos con pista de vídeo se rechazan.
Con curl -F, no toques Content-Type para que curl pueda establecer el boundary multipart, y envía remove_background_noise como true/false y seed como dígitos.
voice para usar default_voice. Cuando supports_custom_voice_id es true, voice también puede ser un Voice ID del proveedor; en el caso de elevenlabs-voice-changer, eso significa cualquier voz de ElevenLabs a la que tengas acceso, incluidas las voces de la biblioteca que no están en la lista voices de Venice. remove_background_noise y seed solo se aceptan cuando el modelo indica que los admite.
La respuesta te da el identificador para todo lo que viene después:
duration_seconds es la duración que midió Venice y el nivel por el que se te ha facturado. Si cotizaste 60 y aquí aparece 61.2, has pagado dos minutos. Guarda model y queue_id; retrieve y complete los necesitan, y el id es válido durante 24 horas.
El cargo se produce en este momento, no cuando vuelve el audio, así que no reintentes una solicitud a queue. Si tienes un queue_id, consulta con él. Si la respuesta nunca llegó, volver a enviar la grabación puede generarte un doble cargo. Queue está limitado a 40 solicitudes por minuto y retrieve a 120; ambos informan de x-ratelimit-remaining-requests.
3. Consulta el estado y descarga
Llama a retrieve con los valores de la respuesta de la cola:audio/mpeg y el cuerpo es el MP3. Bifurca la lógica según el Content-Type.
Los dos números están en milisegundos: cuánto suelen tardar los trabajos en este modelo y cuánto lleva ejecutándose el tuyo. La diferencia es una espera inicial razonable, pero el promedio es solo orientativo. Un origen de 148 segundos tardó 24 segundos frente a un promedio de 7, así que con entradas más largas execution_duration superará a average_execution_time. Cuando eso ocurra, pasa a un intervalo fijo de unos segundos y sigue consultando. Con los clips cortos pasa lo contrario: el ejemplo de 7 segundos llegó en la primera consulta.
La respuesta finalizada incluye x-venice-audio-duration (segundos), x-venice-inference-time, x-venice-audio-format, x-venice-model-id y x-venice-model-name. La salida es siempre un MP3 mono de 128 kbps a 44,1 kHz, independientemente de lo que hayas enviado. La duración del audio debería coincidir con la de tu origen con una diferencia de pocos milisegundos; si la diferencia es mayor, escúchalo antes de publicarlo.
Si falla
Un trabajo que el proveedor aceptó y que después falló se devuelve con un estado de error y conerror y credits_refunded en el cuerpo. true significa que el cargo se ha revertido. false con un mensaje que termina en “please contact support” significa que el propio reembolso falló y que la siguiente consulta lo volverá a intentar. El resultado se almacena, así que volver a consultar lo reproduce.
Un trabajo que nunca llegó al proveedor se comporta de otra manera. Retrieve sigue devolviendo PROCESSING durante un máximo de 10 minutos, después devuelve 504 y te reembolsa el cargo, así que espera al menos ese tiempo con un trabajo en PROCESSING antes de considerarlo atascado. El conjunto completo de resultados finales está en la referencia de retrieve.
Limpieza
Pasadelete_media_on_completion: true en retrieve y los medios almacenados se eliminarán en la misma llamada que te entrega el audio. Cualquier llamada posterior a retrieve para ese id devuelve 404. Si quieres descargarlo más de una vez, no lo incluyas y llama a complete cuando hayas terminado. Complete devuelve {"success": true} y es seguro llamarlo repetidamente.
Ejemplo completo
Todo lo anterior, de principio a fin: comprueba que la voz existe, cotiza, sube el archivo, consulta hasta que llega el audio y guárdalo. El plazo límite es de 12 minutos para que un fallo de envío al proveedor aparezca como un reembolso y no como un tiempo de espera agotado.delete_media_on_completion y llama tú mismo a complete si necesitas el archivo más de una vez.