

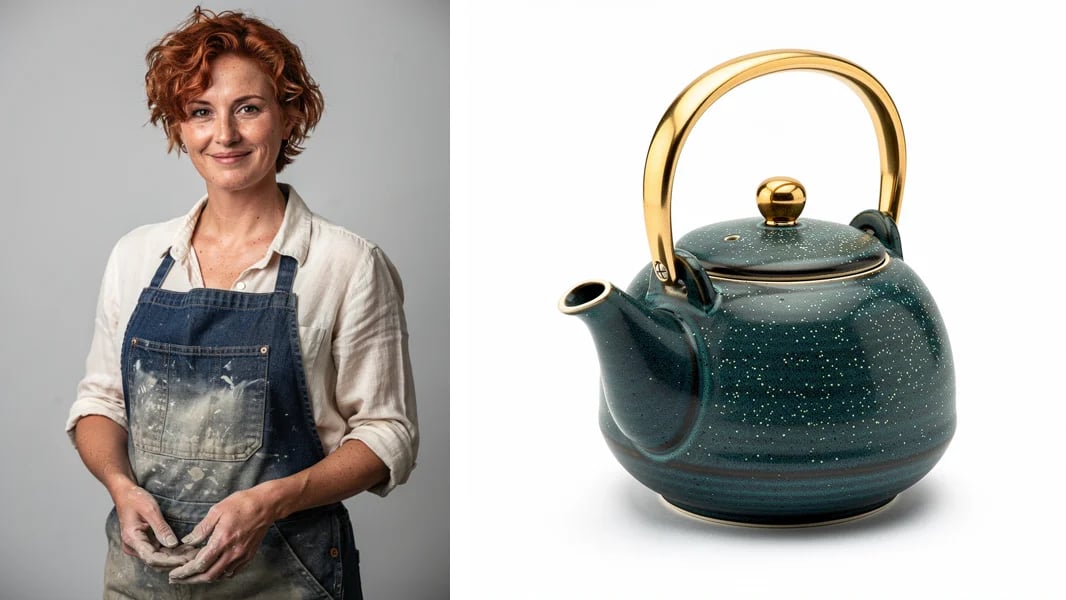
/image/generate، والمقطع الذي صنعه reference-to-video منهما. تحتفظ صانعة الفخار بشعرها ونمشها ومريلتها، ويحتفظ إبريق الشاي بطلائه الزجاجي ومقبضه الذهبي، وتُنطق الجملة الأخيرة أمام الكاميرا.
VENICE_API_KEY مضبوط:
اختر نموذجًا
لكل مستوى المتغيرات الثلاثة نفسها:
Prime هو الخيار الأسرع بسعر أعلى: استغرق مقطع الفخار 205 ثوانٍ على المستوى القياسي و131 ثانية على Prime. لكل معرّف أيضًا صيغة بالنقطة، مثل
wan-3.0-reference-to-video.
يأخذ كلٌّ من image-to-video وreference-to-video صورًا، لكن لمهام مختلفة. يبدأ image-to-video بالصورة image_url تمامًا كما هي، وينتهي بـ end_image_url إذا أرسلتها. أما reference-to-video فيعامل الصور كمراجع: ما فيها يظهر في المقطع، مؤطّرًا بالطريقة التي يحددها الـ prompt. استخدم image-to-video عندما تكون اللقطة الأولى ثابتة، وreference-to-video عندما تحتاج إلى الشخص نفسه أو المنتج نفسه عبر عدة لقطات.
تأتي المدد ونسب العرض إلى الارتفاع والدقات من /models. يعيدها هذا الاستعلام:
2s و5s و10s و15s و20s و25s و30s، ونسب العرض إلى الارتفاع 16:9 و9:16 و1:1 و4:3 و3:4، وprompts تصل إلى 20,000 حرف. يضيف image-to-video وreference-to-video القيمة adaptive التي تتبع شكل مدخلاتك. قد تتغير هذه التفاصيل، لذا اقرأها من الـ API. حدود المراجع غير موجودة في /models؛ بل تجدها في الخطوة 2.
1. احصل على عرض سعر
تُحتسب التكلفة لكل ثانية من الإخراج، بمعدل يحدده المستوى والدقة. في 23 أكتوبر 2026، كانت تكلفة المستوى القياسي $0.065 للثانية بدقة 480p، و$0.13 بدقة 720p، و$0.26 بدقة 1080p، وكانت تكلفة Prime $0.088 و$0.182 و$0.364. وكانت تكلفة Pro $0.237 بدقة 1080p، و$0.272 بدقة 2K، و$0.296 بدقة 4K، وكانت تكلفة Prime Pro $0.331 و$0.355 و$0.379. تتساوى تكلفة المتغيرات الثلاثة داخل المستوى الواحد، وإيقافaudio لا يغيّر السعر.
تُحتسب فيديوهات المرجع بشكل إضافي، بمعدل المهمة نفسه وحتى جزء الثانية، لذا يضيف مقطع مدته 4.2 ثانية 4.2 ثانية. الصور والمقاطع الصوتية المرجعية مجانية. لا يحتاج quote إلى مفتاح API؛ أضف reference_video_total_duration بالثواني عندما تتضمن المهمة فيديوهات مرجعية:
2. ضع المهمة في قائمة الانتظار
هذا هو الطلب الذي يقف خلف مقطع الفخار، مع توجيه الصورتين إلى النسختين الموجودتين في هذه الوثائق حتى تتمكن من تشغيله كما هو:
يجب أيضًا أن تتسع فيديوهات المرجع مع
duration معًا ضمن 30 ثانية. يمكن أن تكون الفيديوهات بصيغة MP4 أو MOV والصوت بصيغة MP3 أو WAV. الصور الأصغر من الحد الأدنى البالغ 240 بكسل على الضلع الأقصر تُكبَّر بدلًا من رفضها.
في الـ prompt، يشير @Image1 إلى العنصر الأول في reference_image_urls، و@Image2 إلى الثاني، وهكذا، ويُعدّ @Video1 و@Audio1 بالطريقة نفسها في مصفوفتيهما. سمِّ كل مرجع ترسله، بما في ذلك الصوت: اكتب @Audio1 في الموضع الذي ينتمي إليه الصوت أو المؤثر الصوتي.
لا يستخدم Wan 3.0 الحقل reference_document_urls، رغم أن مرجع الـ API يدرجه. يرفضه Prime وPro وPrime Pro، أما المستوى القياسي فيقبل المستند ويتجاهله ويحتسب تكلفة المهمة كالمعتاد.
تمنحك الاستجابة المعرّف الذي تحتاجه لكل ما يلي:
queue_id، فاستعلم به. إذا لم تصل الاستجابة أبدًا، فقد يؤدي إرسال المهمة مرة أخرى إلى احتساب التكلفة مرتين. يقتصر queue على 40 طلبًا في الدقيقة وretrieve على 120؛ وكلاهما يُبلغ عن x-ratelimit-remaining-requests.
تُرفض معظم الأخطاء هنا بالرمز 400 دون أي رسوم: قيمة غير موجودة في /models، أو حقل لا يقبله المتغير، أو عدد زائد من المراجع، أو صوت دون صورة أو فيديو، أو غياب aspect_ratio. يوضح الجسم المشكلة في issues[].message. يُتحقق من أطوال المقاطع بعد احتساب التكلفة، لذا فإن مقطعًا مرجعيًا أطول أو أقصر من اللازم يحصل على queue_id هنا ثم يفشل عند أول retrieve، مع استرداد الرسوم.
3. استعلم ونزّل
استدعِ retrieve بالقيم الواردة في استجابة queue:video/mp4 ويكون الجسم هو الفيديو. اعتمد في التفرّع على Content-Type.
الرقمان بالمللي ثانية: المدة التي تستغرقها المهام عادةً على هذا النموذج، والمدة التي تعمل فيها مهمتك حتى الآن. استقر المتوسط عند نحو 7.5 دقائق على كل نموذج جرّبناه، وانتهت كل مهمة قبله. استغرقت المهام من 1 إلى 5 دقائق: الاختبارات ذات الثانيتين بدقة 480p أكثر من دقيقة بقليل، والمهام المبنية على فيديو مرجعي مدته 5 ثوانٍ من 3 إلى 5 دقائق. استعلم كل 10 إلى 15 ثانية بدلًا من الانتظار حتى انقضاء المتوسط.
ملف MP4 بترميز H.264 بمعدل 30 إطارًا في الثانية مع صوت AAC ستيريو، أو دون مسار صوتي إذا أرسلت audio: false. تعود دقة 720p بأبعاد 1280×720 ودقة 1080p القياسية بأبعاد 1920×1080، لكن Pro وPrime Pro أعادا 1936×1088 لدقة 1080p.
إذا فشلت المهمة
تبقى المهمة الفاشلة فاشلة: يعيد الاستعلام مجددًا الحالة نفسها والجسم نفسه. المهام التي تفشل قبل بدء التوليد، مثل مقطع مرجعي خارج حدود الطول أو صورة لا يستطيع Venice فك ترميزها، تُسترد رسومها خلال ثوانٍ من وضعها في قائمة الانتظار. لا تحمل أجسامها سوىerror؛ ويسردها جدول الأخطاء.
التنظيف
مرّرdelete_media_on_completion: true إلى retrieve وسيُحذف الفيديو المخزّن في الاستدعاء نفسه الذي يعيده. أي retrieve لاحق لذلك المعرّف يعيد 404. اتركه غير مفعّل إذا أردت تنزيل الفيديو أكثر من مرة.
أنماط سير العمل
مقطع الفخار هو سير عمل الموضوع: صور تدخل، والأشخاص والأشياء أنفسهم يظهرون في المقطع. الطلبات أدناه هي أنماط سير العمل الأخرى كما شغّلناها، مع المدخلات على عناوين URL نائبة. تستخدم جميعها باستثناء الأخير reference-to-video، حيث يحدد الـ prompt ما يفعله النموذج بالمقطع.الحركة من مقطع
يمكن لفيديو مرجعي أن يوفّر حركة الكاميرا أو الحركة دون محتواه. هنا حدّد مدار مدته 5 ثوانٍ حول تمثال، صُنع باستخدامwan-3-0-text-to-video، حركة الكاميرا حول صانعة الفخار:
صوت للحوار
اذكر في الـ prompt أن الجملة تُنطق بالصوت الموجود في@Audio1. هنا وفّرت جملة مدتها 6 ثوانٍ من /audio/speech الصوت:
تحرير مقطع
صف التغيير، وسمِّ ما يجب أن يبقى كما هو، واضبطduration على طول المقطع:
adaptive، عاد المصدر ذو الأبعاد 854×480 بأبعاد 1280×718.
تمديد مقطع
تبدأ النتيجة بمقطعك بعد إعادة توليده، ثم تستمر من هناك، لذا فإنduration هو طول النتيجة كاملة: المقطع إضافةً إلى اللقطات الجديدة.
"duration": "5s" المدار فقط لا أكثر. يُعاد توليد البداية بدلًا من نسخها، لذا إذا احتجت إلى إطاراتك الأصلية، فاقطع اللقطات الجديدة من النهاية واربطها بمقطعك. تُحتسب ثواني المقطع مرتين، كفيديو مرجعي وكجزء من النتيجة. ولأن المقطع وduration يتشاركان حد الثلاثين ثانية، يمكن لمقطع مدته 10 ثوانٍ أن يزيد بمقدار 10 ثوانٍ على الأكثر.
الإطاران الأول والأخير
يستخدم هذا المثال image-to-video. أرسل الإطار الافتتاحي كـimage_url، والإطار الختامي كـ end_image_url، وصف ما يحدث بينهما. جاء الإطاران من /image/generate، وصُنع الثاني من الأول باستخدام /image/edit حتى تتطابق الغرفة:
كتابة الـ prompts
يتبع Wan 3.0 الـ prompt المنظّم بدقة، وقد ساعدت هذه العادات في تجاربنا:- امنح كل جزء من المقطع طابعًا زمنيًا، مثل
0-4s:و4-10s:. في مقطع الفخار، يقع الرفع والاقتراب التدريجي حيث وضعهما الـ prompt. - ضع الحوار بين علامتي اقتباس مزدوجتين، واذكر متى يجب أن تبقى الشخصية صامتة. عندما يُترك النموذج لنفسه، يملأ اللحظات الهادئة بكلمات صغيرة: أضافت اللقطة الأولى من مقطع الفخار “Okay.” قبل الجملة. أما اللقطة الثانية، مع
She is silent.في اللقطة الأولى وsays only:قبل الجملة، فلم تتضمن سوى “Mm.” خافتة. - سمِّ حركات الكاميرا بوضوح:
slow push-in،static camera،one slow orbit. - صف الصوت الذي تريده، بما في ذلك نغمة الغرفة والأجواء المحيطة. لا يملك Wan 3.0 prompt سلبيًا، لذا اكتب الاستثناءات مثل
no musicداخل الـ prompt نفسه.
مثال كامل
صنع هذا السكربت مقطع الفخار: يحصل على عرض سعر للمهمة، ويضعها في قائمة الانتظار مع الصورتين كـ data URLs، ويستعلم حتى يصل ملف MP4، ثم يحفظه. احفظ صانعة الفخار وإبريق الشاي بجانبه باسم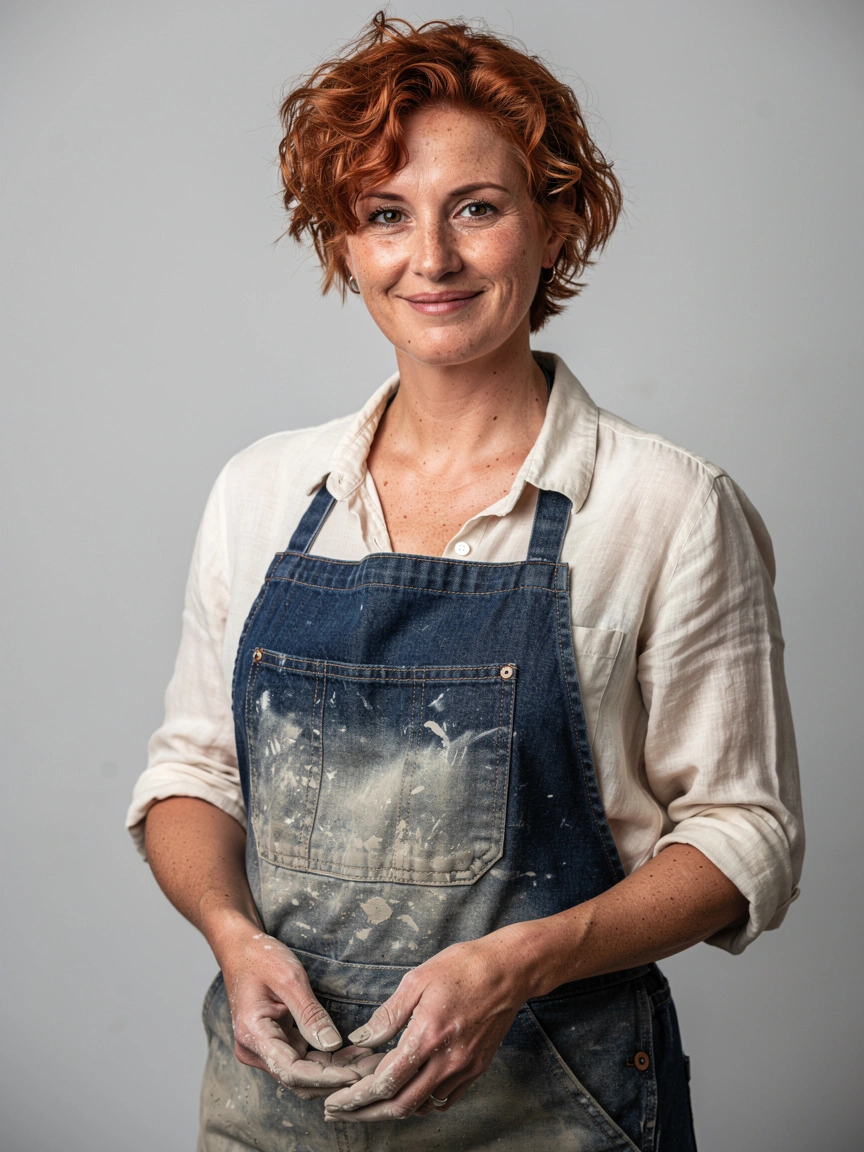
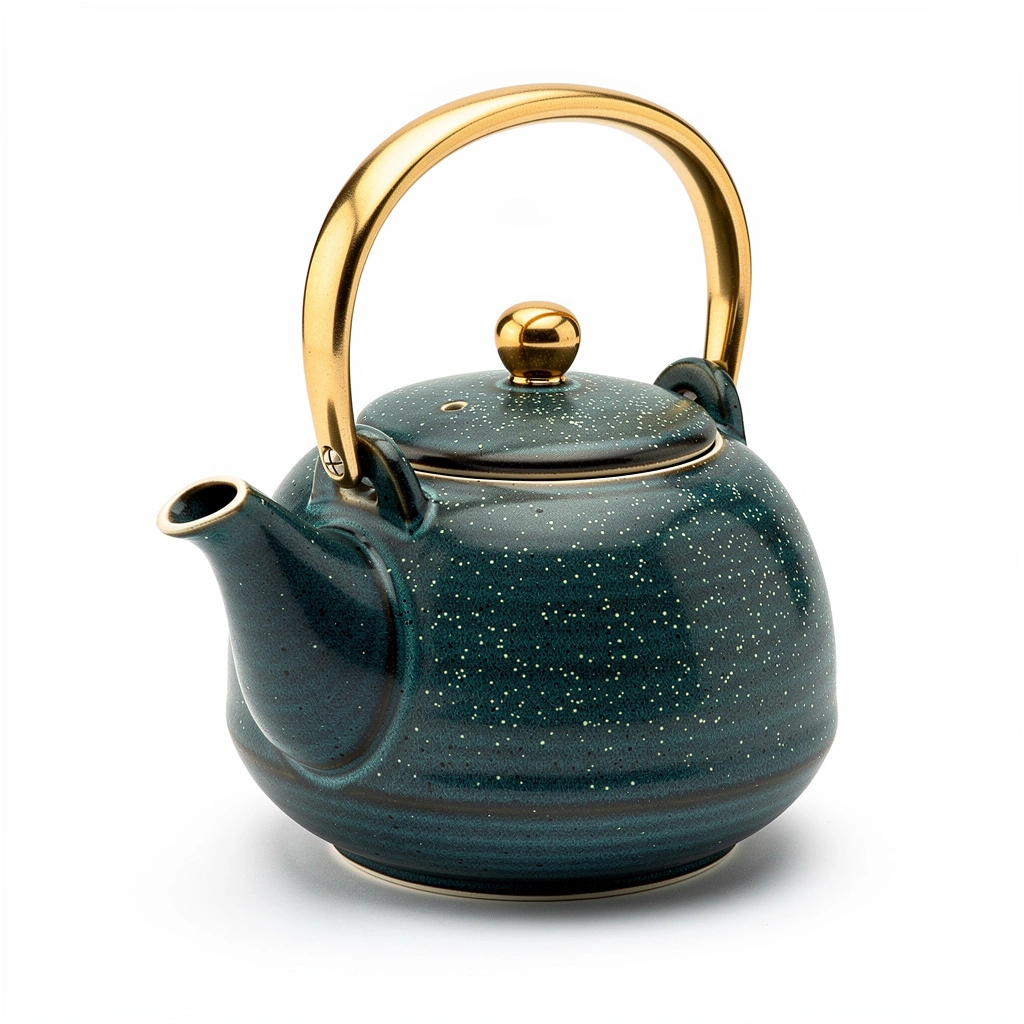
woman.webp وteapot.webp. المهلة البالغة 20 دقيقة تعادل عدة أضعاف أطول مهمة شغّلناها.
delete_media_on_completion إذا أردت تنزيله مرة أخرى.