

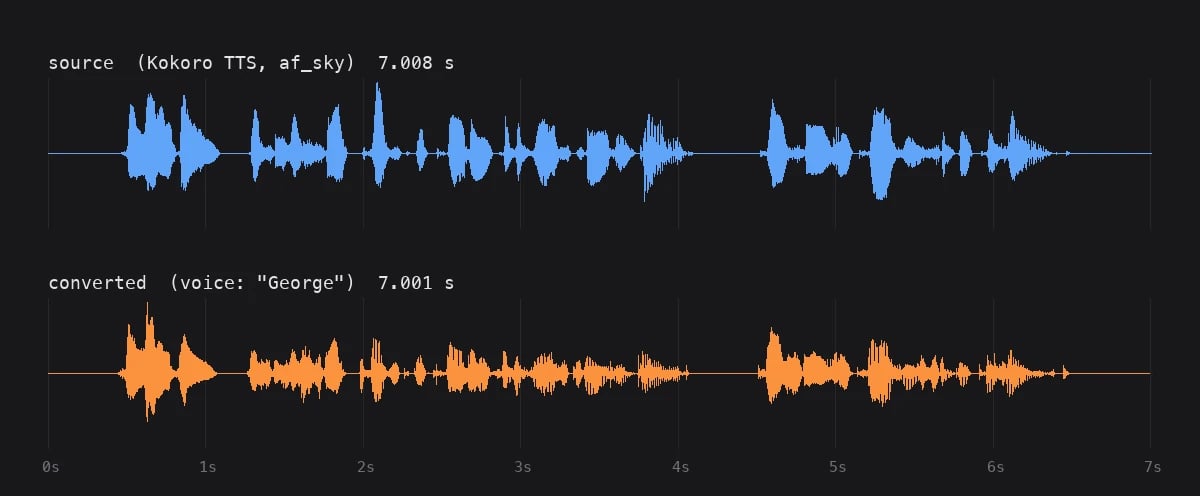
/audio/speech e il risultato della sua conversione nella voce George. Le forme d’onda condividono lo stesso asse temporale e le pause tra le frasi cadono negli stessi punti.
/audio/voice-changer/: quote calcola il prezzo per una durata, queue invia la registrazione e ti addebita il costo, retrieve effettua il polling finché l’MP3 non è pronto e complete elimina i media memorizzati una volta che li hai scaricati. La struttura è la stessa degli endpoint musicali, ma il percorso è diverso e nessuno dei due accetta i modelli dell’altro.
Gli esempi presuppongono che VENICE_API_KEY sia impostata:
Scegli un modello
I modelli voice-changer si trovano sottoGET /models?type=music con model_spec.voice_changer impostato su true; non esiste un filtro di tipo dedicato. Al momento ce n’è uno, elevenlabs-voice-changer: accetta sorgenti mp3, wav, ogg, mp4 o aac fino a 300 secondi, offre 20 voci con nome con Aria come predefinita, accetta un Voice ID ElevenLabs grezzo al posto di un nome e supporta remove_background_noise e seed. Questi dettagli possono cambiare, quindi leggili dall’API. Questa query restituisce tutto ciò da cui dipende il resto della guida:
400. Una registrazione più lunga di max_source_audio_duration_seconds restituisce 422 prima di qualsiasi addebito, con il limite indicato nel messaggio.
C’è una cosa che l’API non controlla al momento della messa in coda: il nome della voce. Se metti in coda una voice che il modello non ha, ottieni comunque 200 e un queue_id; il rifiuto arriva al primo retrieve, con il rimborso dell’addebito. Recuperi il denaro ma perdi il round trip, quindi controlla voices prima di mettere in coda.
1. Ottieni un preventivo
La fatturazione si basa sulla durata della registrazione sorgente, arrotondata per eccesso al minuto intero successivo. Perelevenlabs-voice-changer significa $0.35 fino a 60 secondi, $0.69 fino a 120, $1.04 fino a 180, $1.38 fino a 240 e $1.73 fino a 300. Una clip di 7 secondi costa quanto una di 60, e 60,5 secondi vengono fatturati come due minuti. Se hai molti segmenti brevi, uniscili in un unico file che resti sotto il limite di un minuto, invece di metterli in coda singolarmente. Le fasce provengono da pricing.durations in /models.
Quote accetta un numero intero di secondi e non richiede una chiave API:
2. Metti in coda la conversione
Invia la registrazione come upload multipartfile oppure come audio_url in un corpo JSON, ma non entrambi. Un URL deve essere raggiungibile pubblicamente senza header o cookie; Venice scarica i byte da sola e non passa mai l’URL al provider. Venice controlla i byte, non l’estensione, quindi un file deve essere davvero uno dei contenitori accettati, e i file con una traccia video vengono rifiutati.
Con curl -F, non impostare Content-Type, così curl può impostare il boundary multipart, e invia remove_background_noise come true/false e seed come cifre.
voice per usare default_voice. Quando supports_custom_voice_id è true, voice può essere anche un Voice ID del provider; per elevenlabs-voice-changer significa qualsiasi voce ElevenLabs a cui hai accesso, incluse le voci della libreria che non compaiono nell’elenco voices di Venice. remove_background_noise e seed sono accettati solo quando il modello ne segnala il supporto.
La risposta ti fornisce il riferimento per tutto ciò che segue:
duration_seconds è la durata misurata da Venice e la fascia su cui ti è stato addebitato il costo. Se il preventivo era per 60 e qui leggi 61.2, hai pagato due minuti. Conserva model e queue_id; retrieve e complete li richiedono entrambi, e l’ID è valido per 24 ore.
L’addebito avviene in questo momento, non quando l’audio torna indietro, quindi non ritentare una richiesta di coda. Se hai un queue_id, usalo per il polling. Se la risposta non è mai arrivata, inviare di nuovo la registrazione può comportare un doppio addebito. Queue è limitato a 40 richieste al minuto e retrieve a 120; entrambi riportano x-ratelimit-remaining-requests.
3. Effettua il polling e scarica
Chiama retrieve con i valori ottenuti dalla risposta della coda:audio/mpeg e il corpo è l’MP3. Gestisci i due casi in base al Content-Type.
I due numeri sono in millisecondi: quanto impiegano di solito i job su questo modello e da quanto tempo è in esecuzione il tuo. La differenza è un buon valore per la prima attesa, ma la media è solo un’indicazione. Una sorgente di 148 secondi ha richiesto 24 secondi a fronte di una media di 7, quindi con input più lunghi execution_duration supererà average_execution_time. Quando succede, passa a un intervallo fisso di qualche secondo e continua. Con le clip brevi accade il contrario: l’esempio di 7 secondi è tornato già al primo polling.
La risposta completata contiene x-venice-audio-duration (secondi), x-venice-inference-time, x-venice-audio-format, x-venice-model-id e x-venice-model-name. L’output è sempre un MP3 mono a 128 kbps e 44,1 kHz, qualunque sia il formato inviato. La durata dell’audio dovrebbe corrispondere a quella della sorgente entro pochi millisecondi; se lo scarto è maggiore, ascoltalo prima di pubblicarlo.
In caso di errore
Un job accettato dal provider e poi fallito restituisce uno stato di errore conerror e credits_refunded nel corpo. true significa che l’addebito è stato stornato. false con un messaggio che termina con “please contact support” significa che il rimborso stesso non è riuscito e il polling successivo ritenterà. L’esito viene memorizzato, quindi un nuovo polling lo restituisce di nuovo.
Un job che non ha mai raggiunto il provider si presenta in modo diverso. Retrieve continua a restituire PROCESSING per un massimo di 10 minuti, poi restituisce 504 e ti rimborsa, quindi concedi a un job in PROCESSING almeno quel tempo prima di considerarlo bloccato. L’elenco completo degli esiti terminali si trova nel riferimento di retrieve.
Pulizia
Passadelete_media_on_completion: true su retrieve e i media memorizzati vengono eliminati nella stessa chiamata che ti restituisce l’audio. Qualsiasi retrieve successivo per quell’ID restituisce 404. Se vuoi scaricare più di una volta, ometti il parametro e chiama complete quando hai finito. Complete restituisce {"success": true} e può essere chiamato ripetutamente in sicurezza.
Esempio completo
Tutto quanto visto sopra, dall’inizio alla fine: verifica che la voce esista, richiedi il preventivo, carica il file, effettua il polling finché l’audio non arriva e salvalo. La scadenza è di 12 minuti, così un errore di dispatch si manifesta come rimborso anziché come timeout.delete_media_on_completion e chiama complete tu stesso se ti serve il file più di una volta.