

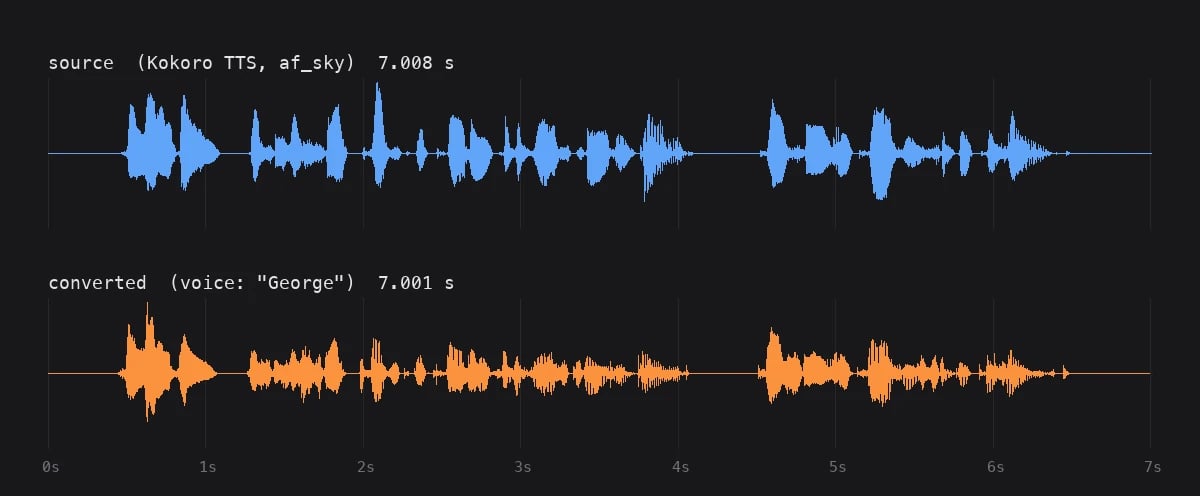
/audio/speech et le résultat de sa conversion dans la voix George. Les formes d’onde partagent le même axe temporel, et les silences entre les phrases tombent aux mêmes endroits.
/audio/voice-changer/ : quote chiffre une durée, queue soumet l’enregistrement et vous facture, retrieve est interrogé en boucle jusqu’à ce que le MP3 soit prêt, et complete supprime les médias stockés une fois que vous les avez récupérés. Le fonctionnement est le même que pour les endpoints de musique, mais le chemin est différent et les deux n’acceptent pas les modèles l’un de l’autre.
Les exemples supposent que VENICE_API_KEY est définie :
Choisir un modèle
Les modèles de changeur de voix se trouvent sousGET /models?type=music avec model_spec.voice_changer défini sur true ; il n’existe pas de filtre de type dédié. Il n’y en a actuellement qu’un seul, elevenlabs-voice-changer : il accepte des sources mp3, wav, ogg, mp4 ou aac jusqu’à 300 secondes, propose 20 voix nommées avec Aria par défaut, accepte un Voice ID ElevenLabs brut à la place d’un nom, et prend en charge remove_background_noise et seed. Ces détails peuvent évoluer : lisez-les donc depuis l’API. Cette requête renvoie tout ce dont dépend la suite du guide :
400. Un enregistrement plus long que max_source_audio_duration_seconds renvoie une erreur 422 avant toute facturation, avec la limite indiquée dans le message.
Il y a une chose que l’API ne vérifie pas au moment de la mise en file d’attente : le nom de la voix. Si vous mettez en file d’attente une voice que le modèle ne possède pas, vous obtenez quand même un 200 et un queue_id ; le rejet arrive au premier appel à retrieve, avec le remboursement de la facturation. Vous récupérez votre argent, mais vous perdez un aller-retour : vérifiez donc voices avant la mise en file d’attente.
1. Obtenir un devis
La facturation se base sur la durée de l’enregistrement source, arrondie à la minute entière supérieure. Pourelevenlabs-voice-changer, cela représente 0,35 jusqu’à 120, 1,04 jusqu’à 240 et 1,73 $ jusqu’à 300. Un extrait de 7 secondes coûte autant qu’un extrait de 60 secondes, et 60,5 secondes sont facturées comme deux minutes. Si vous avez de nombreux segments courts, regroupez-les dans un seul fichier qui reste sous une limite de minute plutôt que de mettre chacun en file d’attente séparément. Les paliers proviennent de pricing.durations dans /models.
Quote accepte un nombre entier de secondes et ne nécessite pas de clé API :
2. Mettre la conversion en file d’attente
Envoyez l’enregistrement soit sous forme de téléversement multipartfile, soit sous forme d’audio_url dans un corps JSON, mais pas les deux. Une URL doit être accessible publiquement sans en-têtes ni cookies ; Venice récupère lui-même les octets et ne transmet jamais l’URL au fournisseur. Venice vérifie les octets, pas l’extension : un fichier doit donc réellement correspondre à l’un des conteneurs acceptés, et les fichiers contenant une piste vidéo sont rejetés.
Avec curl -F, ne touchez pas à Content-Type afin que curl puisse définir la boundary multipart, et envoyez remove_background_noise sous la forme true/false et seed sous forme de chiffres.
voice pour obtenir default_voice. Lorsque supports_custom_voice_id vaut true, voice peut également être un Voice ID de fournisseur ; pour elevenlabs-voice-changer, cela signifie n’importe quelle voix ElevenLabs à laquelle vous avez accès, y compris des voix de la bibliothèque qui ne figurent pas dans la liste voices de Venice. remove_background_noise et seed ne sont acceptés que lorsque le modèle indique les prendre en charge.
La réponse vous fournit l’identifiant nécessaire pour toutes les étapes suivantes :
duration_seconds correspond à la durée mesurée par Venice, et au palier sur lequel vous avez été facturé. Si votre devis portait sur 60 et que cette valeur indique 61,2, vous avez payé deux minutes. Conservez model et queue_id ; retrieve et complete en ont tous deux besoin, et l’ID reste valable 24 heures.
Vous êtes facturé à ce moment-là, et non au retour de l’audio : ne réessayez donc pas une requête queue. Si vous disposez d’un queue_id, interrogez retrieve avec celui-ci. Si la réponse n’est jamais arrivée, renvoyer l’enregistrement peut entraîner une double facturation. Queue est limité à 40 requêtes par minute et retrieve à 120 ; les deux renvoient x-ratelimit-remaining-requests.
3. Interroger et télécharger
Appelez retrieve avec les valeurs de la réponse de queue :audio/mpeg et le corps contient le MP3. Aiguillez votre traitement selon le Content-Type.
Les deux valeurs sont en millisecondes : la durée habituelle des travaux sur ce modèle, et la durée depuis laquelle le vôtre est en cours. L’écart entre les deux constitue un premier délai d’attente raisonnable, mais la moyenne n’est qu’une indication. Une source de 148 secondes a pris 24 secondes pour une moyenne de 7 : sur des entrées plus longues, execution_duration finira donc par dépasser average_execution_time. Dans ce cas, revenez à un intervalle fixe de quelques secondes et continuez. Les extraits courts vont dans l’autre sens : l’exemple de 7 secondes est revenu dès la toute première interrogation.
La réponse finale contient x-venice-audio-duration (secondes), x-venice-inference-time, x-venice-audio-format, x-venice-model-id et x-venice-model-name. La sortie est toujours un MP3 mono à 128 kbit/s et 44,1 kHz, quel que soit le format envoyé. La durée de l’audio doit correspondre à celle de votre source à quelques millisecondes près ; si l’écart est plus important, écoutez le résultat avant de le publier.
En cas d’échec
Un travail accepté par le fournisseur puis en échec renvoie un statut d’erreur avecerror et credits_refunded dans le corps. true signifie que la facturation a été annulée. false avec un message se terminant par « please contact support » signifie que le remboursement lui-même a échoué et que la prochaine interrogation réessaiera. Le verdict est enregistré : interroger à nouveau le rejoue.
Un travail qui n’a jamais atteint le fournisseur se présente différemment. Retrieve continue d’indiquer PROCESSING pendant jusqu’à 10 minutes, puis renvoie une erreur 504 et vous rembourse : accordez donc au moins ce délai à un travail PROCESSING avant de le considérer comme bloqué. L’ensemble des résultats finaux est décrit dans la référence de retrieve.
Nettoyage
Transmettezdelete_media_on_completion: true à retrieve et les médias stockés sont supprimés dans le même appel qui vous renvoie l’audio. Tout appel ultérieur à retrieve pour cet ID renvoie une erreur 404. Si vous souhaitez télécharger le fichier plusieurs fois, omettez ce paramètre et appelez complete lorsque vous avez terminé. Complete renvoie {"success": true} et peut être appelé plusieurs fois sans risque.
Exemple complet
Tout ce qui précède, de bout en bout : vérifier que la voix existe, obtenir un devis, téléverser, interroger jusqu’à l’arrivée de l’audio, l’enregistrer. Le délai maximal est de 12 minutes afin qu’un échec de transmission se traduise par un remboursement plutôt que par un dépassement de délai.delete_media_on_completion et appelez complete vous-même si vous avez besoin du fichier plusieurs fois.