

/image/background-remove와는 다릅니다. 어차피 자산을 생성하거나 편집할 예정이라면 네이티브 투명도를 사용하고, 불투명 이미지만 가지고 있다면 배경 제거를 사용하세요.
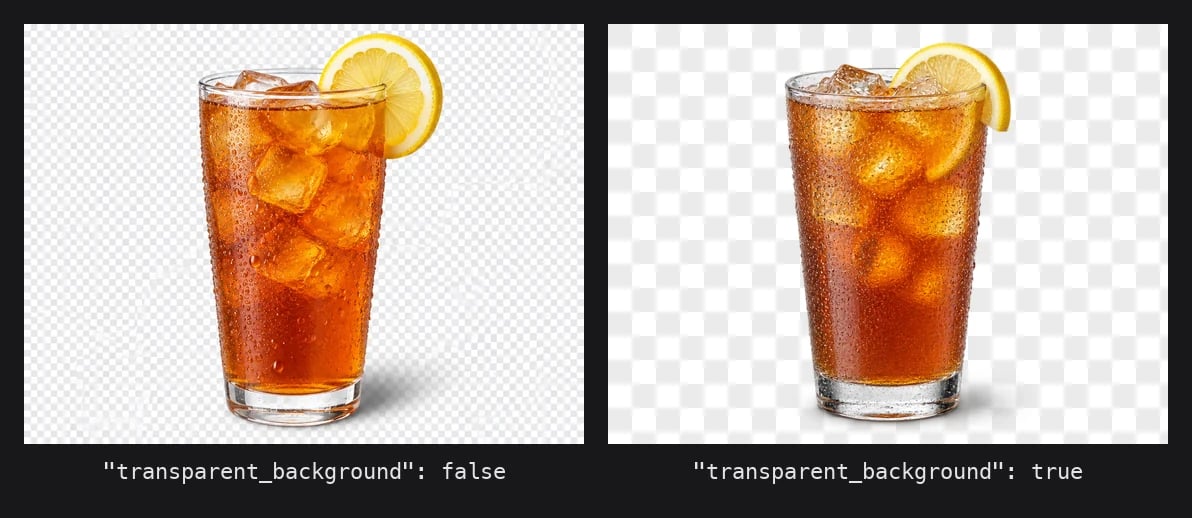
gpt-image-2-5-flare에서 동일한 prompt와 seed를 사용한 결과. 왼쪽: 기본 출력. 오른쪽: transparent_background: true, 체커보드 위에 표시. 드롭 섀도가 부분 알파로 보존됩니다.
필요한 것
그 외의 경우에는 추론이 실행되기 전에
400이 반환되므로, 거부된 요청에는 비용이 청구되지 않습니다.
1단계: 투명 이미지 생성
/image/generate는 네이티브 endpoint입니다. format을 png 또는 webp로, transparent_background를 true로 설정하세요.
content-type: image/png입니다. return_binary를 사용하지 않으면 images[0]에 base64 문자열이 담긴 일반 JSON 응답을 받습니다.
format의 기본값은 webp이며 이 역시 알파를 지원하므로, format을 생략해도 동작합니다. 명시적으로 "format": "jpeg"를 지정한 경우에만 실패합니다.
2단계: 알파 채널 확인
파일 확장자를 믿지 마세요. 픽셀 모드를 확인하고 알파 분포를 살펴서, 배경이 평탄화된 흰색 채움이 아니라 실제로 투명한지 확인하세요.0(배경)이고, 가장자리를 따라 부분 값의 띠(안티앨리어싱과 부드러운 그림자)가 있으며, 피사체의 경계 상자가 캔버스보다 작습니다. im.mode가 RGB이거나 투명 비율이 0%라면 파이프라인 어딘가에서 알파 채널이 손실된 것이며, 대개 알파를 버리는 리사이즈 또는 재인코딩 단계가 원인입니다.
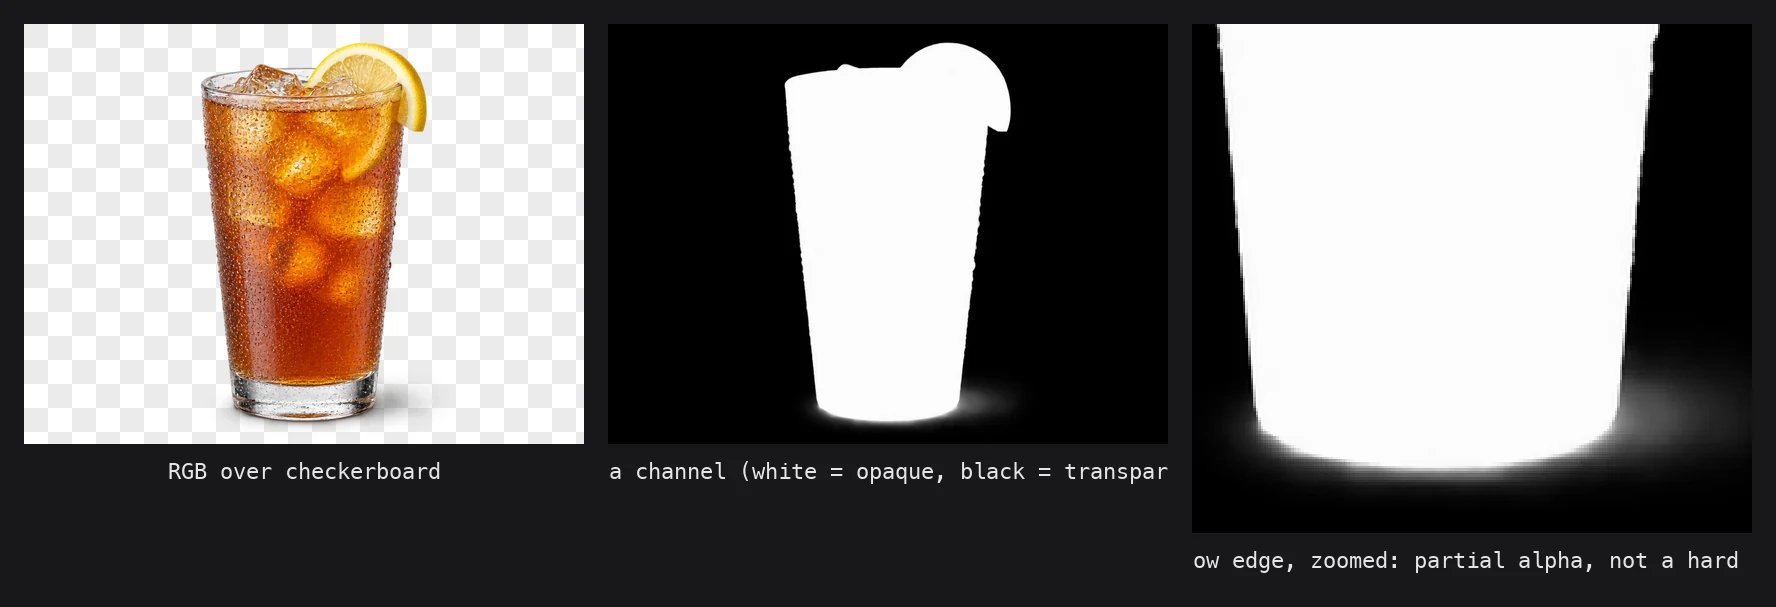
위 이미지의 알파 채널만 분리한 모습. 잔 아래의 그림자가 흰색에서 검은색으로 급격히 바뀌지 않고 수십 단계의 회색으로 서서히 사라지며, 이는 임의의 배경 위에 합성할 때 바람직한 형태입니다.
GPT Image 모델은 현재 불투명 영역을
255가 아닌 알파 252–254로 반환합니다. 시각적으로는 구별할 수 없지만, 피사체를 찾기 위해 == 255로 임계값을 설정하면 빈 마스크가 나옵니다. 대신 > 0 또는 >= 250으로 임계값을 설정하세요.3단계: OpenAI 호환 endpoint 사용
이미 OpenAI SDK를 사용 중이라면,/images/generations는 OpenAI가 사용하는 것과 동일한 background 파라미터를 받습니다. 이를 "transparent"로 설정하고 output_format으로 png 또는 webp를 선택하세요.
background는 transparent, opaque, auto를 받습니다. opaque, auto, null은 모두 모델의 기본 동작을 유지하므로, 실제로 변화를 주는 값은 transparent뿐입니다. 이 endpoint에서 output_format의 기본값은 png이므로 생략할 수 있습니다.
4단계: 투명도를 유지하며 편집
/image/edit와 /image/multi-edit 모두 transparent_background를 받습니다. 원본 이미지가 투명할 필요는 없으며, 불투명한 사진을 전달하고 편집하면서 피사체를 분리하도록 모델에 요청할 수 있습니다.
output_format을 생략하면 자동으로 추론됩니다. 일반적으로 1K 편집은 PNG, 2K/4K는 JPEG이지만, transparent_background가 true이면 모든 해상도에서 PNG로 추론됩니다. 따라서 WebP를 원할 때만 output_format을 명시적으로 보내면 됩니다.
multi-edit 형식도 동일하며, image 대신 images[]를 사용합니다. 제품 사진을 새로운 장면에 합성하고, 그 합성 결과를 자체 레이아웃에 배치할 수 있는 컷아웃으로 받아야 할 때 자연스럽게 활용할 수 있습니다.
가격
투명도에는 추가 요금이 없습니다. 모델의 일반 이미지당 가격을 지불하며, GPT Image 2.5의 경우resolution과 quality에 따라 달라집니다. gpt-image-2-5-flare에서 1K low 생성은 high 또는 4K에 비용을 쓰기 전에 스티커나 아이콘을 반복 작업하는 가장 저렴한 방법입니다. 실시간 가격표는 이미지 모델을 참조하세요.
에러
검증은 모델이 호출되기 전에 실행됩니다. 두 메시지 모두 해결 방법을 알려줍니다.jpeg와 함께 transparent_background: false를 사용하는 것은 문제없으며, 일반적인 불투명 JPEG를 반환합니다.
런타임에 지원 모델 확인하기
모델 ID는 바뀝니다. 위 목록을 하드코딩하는 대신 constraint 플래그로GET /models를 필터링하세요. 이 키는 지원하는 모델에만 true 값으로 존재합니다.
type=inpaint를 사용하면 -edit 모델 ID가 반환됩니다.
언제 이것을 사용하고 언제 /image/background-remove를 사용하나요
어차피 자산을 생성할 예정이라면 처음부터 투명도를 요청하고 두 번째 호출을 생략하세요. 불투명 이미지가 이미 있고 다시 생성하고 싶지 않을 때는
/image/background-remove를 사용하세요.
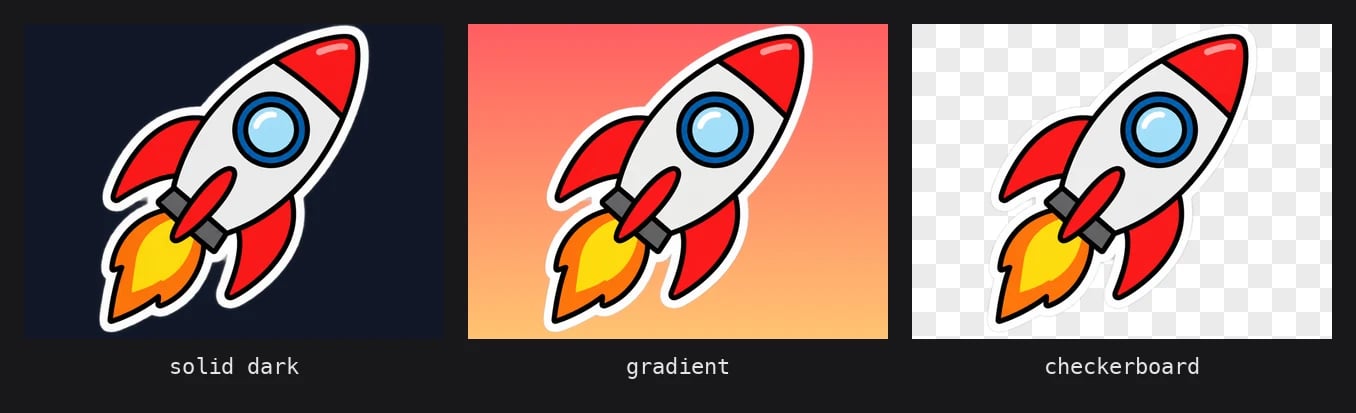
1단계 요청으로 만든 투명 스티커 하나를 추가 처리 없이 세 가지 배경 위에 배치한 모습.