

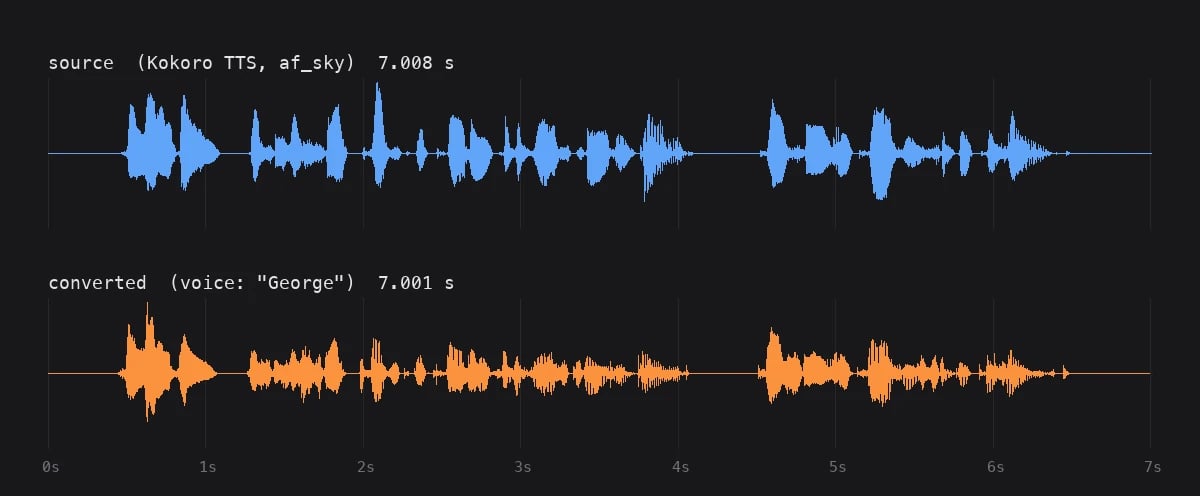
/audio/speech 生成的 7 秒片段,以及将其转换为 George 声音后的结果。两条波形位于同一时间轴上,短语之间的间隙出现在相同的位置。
/audio/voice-changer/ 下的四个端点异步执行:quote 对指定时长进行报价,queue 提交录音并扣费,retrieve 轮询直到 MP3 就绪,complete 在您拿到文件后删除存储的媒体。其流程与音乐端点相同,但路径不同,且两者互不接受对方的模型。
示例假定已设置 VENICE_API_KEY:
选择模型
语音转换模型位于GET /models?type=music 之下,其 model_spec.voice_changer 为 true;目前没有专门的类型过滤器。现在只有一个模型 elevenlabs-voice-changer:它接受 mp3、wav、ogg、mp4 或 aac 格式、最长 300 秒的源音频,提供 20 个具名声音(默认为 Aria),可以用原始的 ElevenLabs Voice ID 代替声音名称,并支持 remove_background_noise 和 seed。这些细节可能会变化,因此请从 API 读取。以下查询会返回本指南后续内容所依赖的全部信息:
400。长于 max_source_audio_duration_seconds 的录音会在扣费前返回 422,消息中会给出该上限。
有一项内容 API 在入队时不会检查,那就是声音名称。如果您入队了模型没有的 voice,仍会得到 200 和一个 queue_id;拒绝会在第一次 retrieve 时返回,并退还费用。钱虽然退回来了,但白白浪费了一次往返,所以请在入队前先检查 voices。
1. 获取价格报价
计费依据源录音的时长,向上取整到下一个整分钟。对于elevenlabs-voice-changer,60 秒以内为 $0.35,120 秒以内为 $0.69,180 秒以内为 $1.04,240 秒以内为 $1.38,300 秒以内为 $1.73。7 秒的片段与 60 秒的片段价格相同,而 60.5 秒会按两分钟计费。如果您有许多短片段,请将它们合并成一个不跨越分钟边界的文件,而不是逐个入队。价格等级来自 /models 中的 pricing.durations。
quote 接受整数秒数,且无需 API 密钥:
2. 将转换任务加入队列
您可以以 multipartfile 上传的方式发送录音,也可以在 JSON 请求体中传入 audio_url,但不能同时使用两者。URL 必须无需请求头或 cookie 即可公开访问;Venice 会自行获取字节内容,绝不会把 URL 传给供应商。Venice 检查的是字节内容而非扩展名,因此文件必须确实是受支持的容器格式之一,且包含视频轨道的文件会被拒绝。
使用 curl -F 时,请不要手动设置 Content-Type,以便 curl 设置 multipart 边界;remove_background_noise 请以 true/false 发送,seed 请以数字发送。
voice 即使用 default_voice。当 supports_custom_voice_id 为 true 时,voice 也可以是供应商的 Voice ID;对于 elevenlabs-voice-changer,这意味着您可以使用任何您有权访问的 ElevenLabs 声音,包括不在 Venice voices 列表中的声音库声音。只有当模型报告支持时,才会接受 remove_background_noise 和 seed。
响应会提供后续所有操作所需的句柄:
duration_seconds 是 Venice 测得的时长,也是您被计费所依据的等级。如果您报价时用的是 60,而这里显示 61.2,那么您支付的是两分钟的费用。请保存 model 和 queue_id;retrieve 和 complete 都需要它们,且该 ID 在 24 小时内有效。
扣费发生在此时,而不是在音频返回时,所以不要重试 queue 请求。如果您拿到了 queue_id,请用它轮询。如果响应始终没有返回,再次发送录音可能会导致重复扣费。queue 的限制为每分钟 40 次请求,retrieve 为每分钟 120 次;两者都会返回 x-ratelimit-remaining-requests。
3. 轮询并下载
使用 queue 响应中的值调用 retrieve:audio/mpeg,响应体即为 MP3。请根据 Content-Type 进行分支处理。
这两个数字的单位都是毫秒:分别表示该模型上任务通常所需的时间,以及您的任务已运行的时间。两者之差可以作为第一次等待的合理时长,但平均值只是参考。一段 148 秒的源音频耗时 24 秒,而平均值只有 7 秒,因此对于较长的输入,execution_duration 会超过 average_execution_time。出现这种情况时,请改用几秒钟的固定间隔继续轮询。短片段则相反:7 秒的示例在第一次轮询时就返回了。
完成的响应会携带 x-venice-audio-duration(秒)、x-venice-inference-time、x-venice-audio-format、x-venice-model-id 和 x-venice-model-name。无论输入是什么,输出始终是 128 kbps、44.1 kHz 的单声道 MP3。音频时长应与源音频相差不超过几毫秒;如果偏差更大,请在发布前先试听。
如果失败
供应商已接受但随后失败的任务,会返回错误状态,响应体中包含error 和 credits_refunded。true 表示费用已退还。false 且消息以 “please contact support” 结尾,表示退款本身失败,下一次轮询会再次尝试。结果会被保存,因此再次轮询会重放该结果。
从未送达供应商的任务表现不同。retrieve 会持续返回 PROCESSING 长达 10 分钟,然后返回 504 并为您退款,因此在将 PROCESSING 任务视为卡住之前,请至少等待这么长时间。完整的终态结果列表请参阅 retrieve 参考文档。
清理
在 retrieve 中传入delete_media_on_completion: true,存储的媒体会在向您返回音频的同一次调用中被删除。之后针对该 ID 的任何 retrieve 都会返回 404。如果您想多次下载,请不要设置该参数,并在完成后调用 complete。complete 返回 {"success": true},可以安全地重复调用。
完整示例
以上所有步骤的端到端示例:检查声音是否存在、报价、上传、轮询直到音频返回、保存文件。截止时间设为 12 分钟,这样分派失败会表现为退款而不是超时。delete_media_on_completion 并自行调用 complete。