

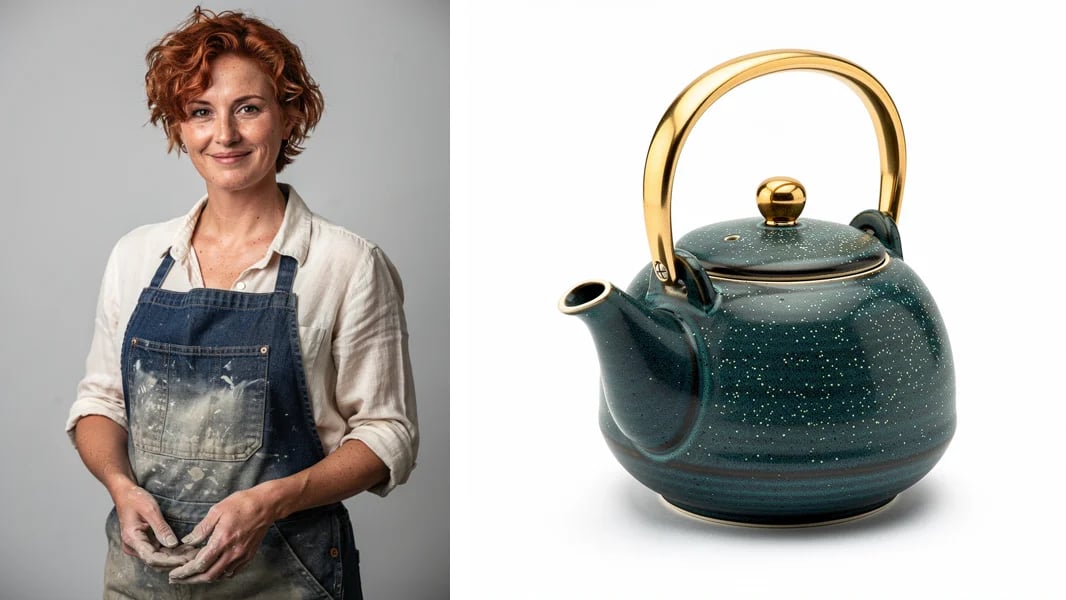
/image/generate 生成的两张图像,以及参考生视频根据它们生成的片段。陶艺师保留了她的发型、雀斑和围裙,茶壶保留了釉色和金色把手,结尾的台词由她对着镜头说出。
VENICE_API_KEY:
选择模型
每个档位都有相同的三种变体:
Prime 速度更快,价格也更高:陶艺片段在标准档位上耗时 205 秒,在 Prime 上耗时 131 秒。每个 ID 还有一种带点号的写法,例如
wan-3.0-reference-to-video。
图生视频和参考生视频都接受图像,但用途不同。图生视频严格以 image_url 作为开场,如果你传入了 end_image_url,则以它作为结尾。参考生视频把图像当作参考:图像中的内容会出现在片段中,取景方式由提示词决定。当第一个镜头已经确定时,请使用图生视频;当你需要在多个镜头中保持同一个人物或产品时,请使用参考生视频。
时长、宽高比和分辨率来自 /models。以下查询会返回这些信息:
2s、5s、10s、15s、20s、25s 和 30s 时长,16:9、9:16、1:1、4:3 和 3:4 宽高比,以及最长 20,000 个字符的提示词。图生视频和参考生视频还额外提供 adaptive,它会跟随输入的形状。这些细节可能会变化,因此请从 API 中读取。参考输入的限制不在 /models 中,而是在第 2 步中说明。
1. 获取报价
按输出秒数计费,费率由档位和分辨率决定。截至 2026 年 10 月 23 日,标准档位在 480p 下为每秒 $0.065,720p 为 $0.13,1080p 为 $0.26;Prime 分别为 $0.088、$0.182 和 $0.364。Pro 在 1080p 下为 $0.237,2K 为 $0.272,4K 为 $0.296;Prime Pro 分别为 $0.331、$0.355 和 $0.379。同一档位的三种变体价格相同,关闭audio 也不会改变价格。
参考视频另外计费,按任务的费率计算并精确到秒的小数部分,因此一段 4.2 秒的片段会增加 4.2 秒的费用。参考图像和音频免费。报价接口不需要 API 密钥;当任务包含参考视频时,请添加 reference_video_total_duration(单位为秒):
2. 将任务加入队列
以下是生成陶艺片段的请求,其中两张图像指向本文档中的副本,你可以直接运行:
参考视频与
duration 的总和也必须在 30 秒以内。视频可以是 MP4 或 MOV,音频可以是 MP3 或 WAV。短边小于 240 像素下限的图像会被放大,而不会被拒绝。
在提示词中,@Image1 指 reference_image_urls 中的第一项,@Image2 指第二项,依此类推;@Video1 和 @Audio1 在各自的数组中以相同方式计数。请在提示词中点名你发送的每一个参考输入,包括音频:在人声或声音应出现的位置写上 @Audio1。
尽管 API 参考中列出了 reference_document_urls,Wan 3.0 并不使用它。Prime、Pro 和 Prime Pro 会拒绝该字段,标准档位则会接受文档但忽略它,并照常对任务扣费。
响应会返回后续所有操作所需的标识:
queue_id,请用它进行轮询。如果始终没有收到响应,再次发送任务可能会导致重复扣费。队列接口限制为每分钟 40 次请求,检索接口为每分钟 120 次;两者都会返回 x-ratelimit-remaining-requests。
大多数错误会在这一步以 400 被拒绝且不扣费:取值不在 /models 中、变体不接受的字段、参考输入过多、只有音频而没有图像或视频,或缺少 aspect_ratio。响应体会在 issues[].message 中说明问题所在。片段长度在扣费之后才会检查,因此过长或过短的参考片段会在这一步拿到 queue_id,然后在第一次检索时失败,费用会被退还。
3. 轮询并下载
使用队列响应中的值调用检索接口:video/mp4,响应体就是视频本身。请根据 Content-Type 进行分支处理。
这两个数字的单位是毫秒:分别表示该模型上任务的通常耗时,以及你的任务已运行的时长。在我们尝试的每个模型上,平均值都在 7.5 分钟左右,而每个任务都比平均值更快。任务耗时 1 到 5 分钟:480p 下 2 秒的测试略超过一分钟,基于 5 秒参考视频的任务则需要 3 到 5 分钟。请每 10 到 15 秒轮询一次,而不是一直等到平均时长。
MP4 为 H.264 编码,每秒 30 帧,带立体声 AAC 音频;如果你传入了 audio: false,则没有音轨。720p 返回 1280×720,标准档位的 1080p 返回 1920×1080,但 Pro 和 Prime Pro 的 1080p 返回的是 1936×1088。
如果任务失败
失败的任务会保持失败状态:再次轮询会返回相同的状态和响应体。在生成开始前失败的任务,例如参考片段超出长度限制或 Venice 无法解码的图像,会在加入队列后几秒内退款。它们的响应体只包含error;错误表列出了这些错误。
清理
在检索时传入delete_media_on_completion: true,存储的视频会在返回它的同一次调用中被删除。之后对该 ID 的任何检索都会返回 404。如果你想多次下载视频,请不要设置此项。
工作流
陶艺片段属于主体工作流:输入图像,片段中出现同样的人物和物体。下面的请求是我们实际运行过的其他工作流,输入使用占位 URL。除最后一个外,其余都使用参考生视频,由提示词决定模型如何处理片段。从片段中获取运动
参考视频可以只提供镜头运动或动作,而不带入其内容。这里使用wan-3-0-text-to-video 生成的一段 5 秒环绕雕像的片段,来设定围绕陶艺师的镜头运动:
为对白指定人声
在提示词中说明台词使用@Audio1 中的人声说出。这里由 /audio/speech 生成的一段 6 秒台词提供人声:
编辑片段
描述要做的修改,点明哪些内容必须保持不变,并将duration 设置为片段的长度:
adaptive 时,854×480 的源片段返回的是 1280×718。
扩展片段
结果以你的片段(重新生成)开头,并从那里继续,因此duration 是整个结果的长度:原片段加上新画面。
"duration": "5s" 的相同请求只返回了环绕部分,没有其他内容。开头部分是重新生成的而非复制的,因此如果你需要原始画面,请从结尾截取新画面并将其拼接到你的片段上。片段的秒数会被计费两次:一次作为参考视频,一次作为结果的一部分。由于片段和 duration 共享 30 秒上限,一段 10 秒的片段最多只能延长 10 秒。
首帧与末帧
这个工作流使用图生视频。将开场画面作为image_url 发送,将结尾画面作为 end_image_url 发送,并描述两者之间发生的事情。两帧画面都来自 /image/generate,第二帧是用 /image/edit 基于第一帧制作的,以保证房间一致:
编写提示词
Wan 3.0 会紧密遵循结构化的提示词,以下习惯在我们的测试中很有帮助:- 为片段的每一段指定时间戳,例如
0-4s:和4-10s:。在陶艺片段中,拿起茶壶和推镜头的动作都出现在提示词指定的位置。 - 将对白放在双引号中,并说明角色何时应保持沉默。如果不加说明,模型会用简短的词语填补安静的时刻:陶艺片段的第一次生成在台词前加了一句 “Okay.”。第二次生成在第一个镜头中写了
She is silent.,并在台词前写了says only:,结果只有一声轻轻的 “Mm.”。 - 直白地写出镜头运动:
slow push-in、static camera、one slow orbit。 - 描述你想要的声音,包括房间底噪和环境音。Wan 3.0 没有负面提示词,因此请把
no music之类的排除项直接写进提示词中。
完整示例
这个脚本生成了陶艺片段:它为任务报价,以 data URL 形式附上两张图像将任务加入队列,轮询直到 MP4 返回,然后保存。请将陶艺师和茶壶保存到脚本旁边,分别命名为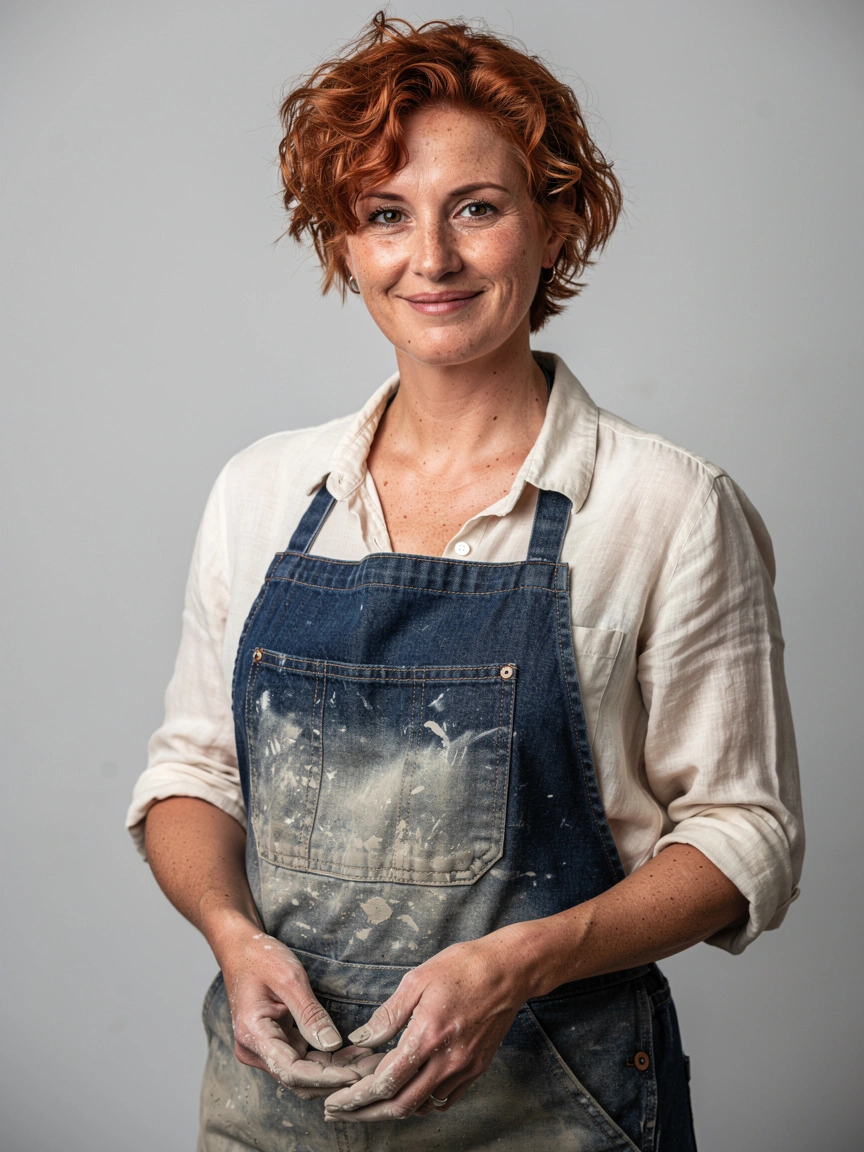
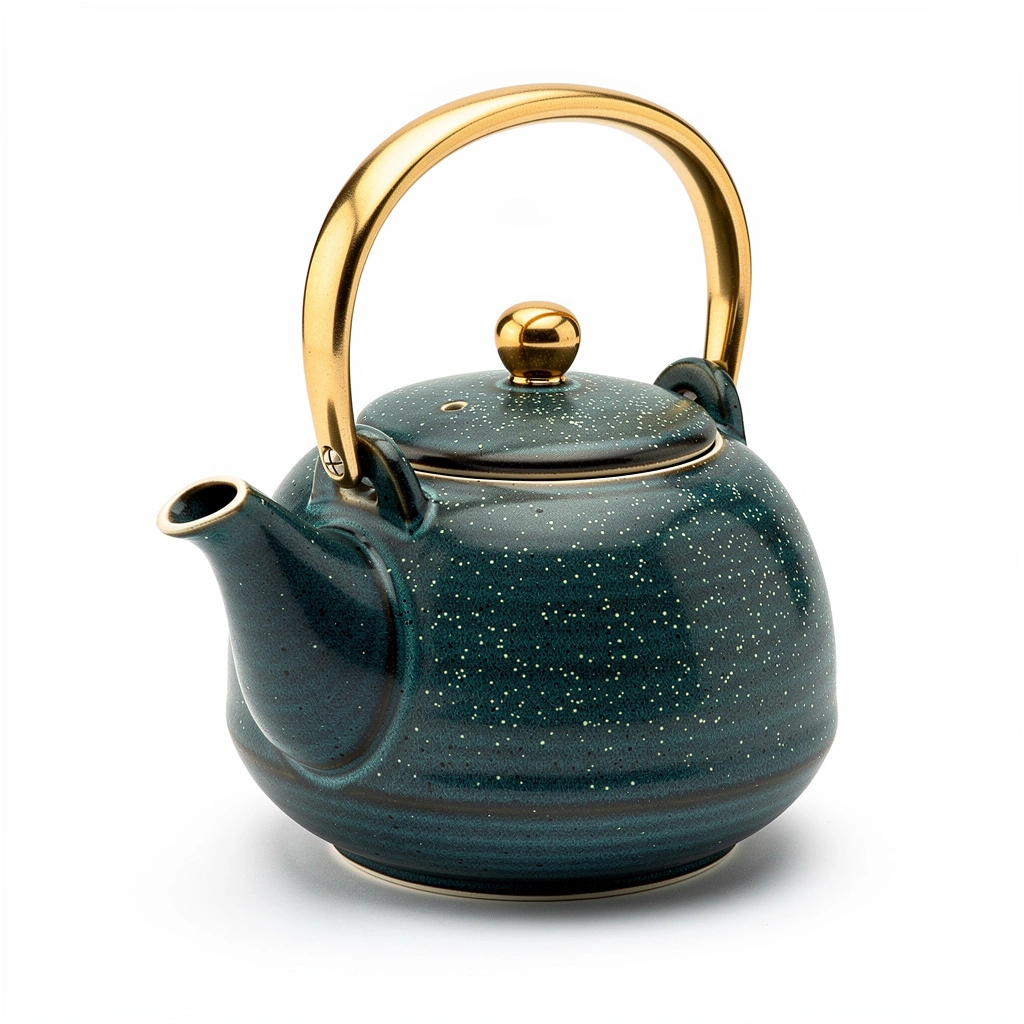
woman.webp 和 teapot.webp。20 分钟的截止时间是我们运行过的最长任务的数倍。
delete_media_on_completion。