

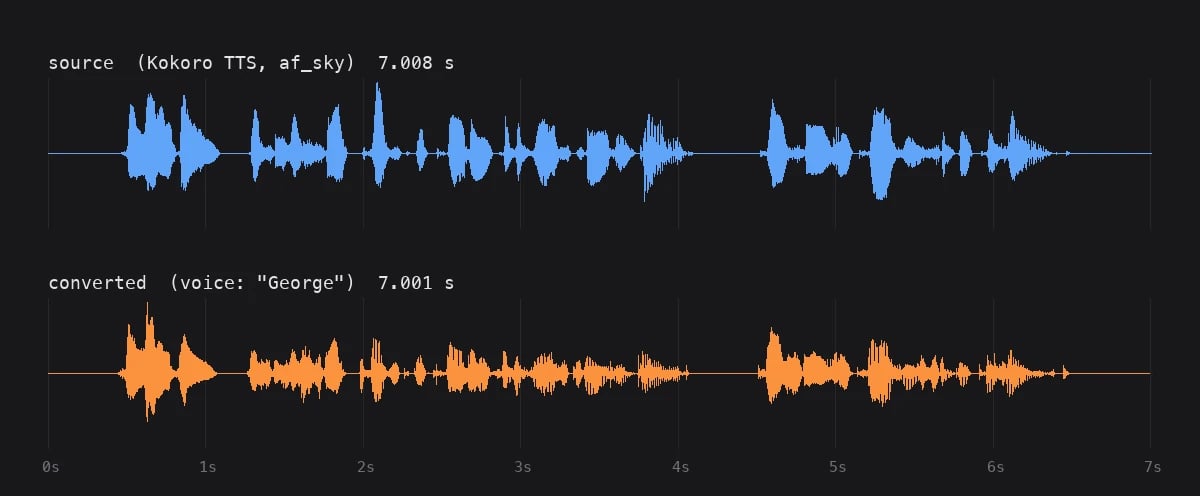
/audio/speech und das Ergebnis seiner Konvertierung in die Stimme George. Die Wellenformen liegen auf derselben Zeitachse, und die Lücken zwischen den Phrasen fallen an dieselben Stellen.
/audio/voice-changer/: Quote kalkuliert den Preis für eine Länge, Queue übermittelt die Aufnahme und berechnet sie dir, Retrieve wird abgefragt, bis die MP3 bereit ist, und Complete löscht die gespeicherten Medien, sobald du sie hast. Der Ablauf ist derselbe wie bei den Musik-Endpoints, aber der Pfad ist ein anderer, und die beiden akzeptieren die Modelle des jeweils anderen nicht.
Die Beispiele setzen voraus, dass VENICE_API_KEY gesetzt ist:
Modell auswählen
Voice-Changer-Modelle finden sich unterGET /models?type=music mit model_spec.voice_changer gleich true; einen eigenen Typfilter gibt es nicht. Derzeit gibt es eines, elevenlabs-voice-changer: Es akzeptiert Quellen in mp3, wav, ogg, mp4 oder aac mit bis zu 300 Sekunden, bietet 20 benannte Stimmen mit Aria als Standard, akzeptiert statt eines Namens auch eine rohe ElevenLabs-Voice-ID und unterstützt remove_background_noise und seed. Diese Details können sich ändern, also lies sie aus der API aus. Diese Abfrage liefert alles, worauf der Rest dieses Guides aufbaut:
400. Eine Aufnahme, die länger als max_source_audio_duration_seconds ist, liefert 422, bevor etwas berechnet wird, und die Fehlermeldung nennt das Limit.
Eine Sache prüft die API beim Einreihen in die Warteschlange nicht: den Stimmennamen. Stellst du eine voice in die Warteschlange, die das Modell nicht hat, bekommst du trotzdem 200 und eine queue_id; die Ablehnung kommt erst beim ersten Retrieve, und der berechnete Betrag wird erstattet. Du bekommst das Geld zurück, verlierst aber den Roundtrip, also prüfe voices, bevor du die Konvertierung in die Warteschlange stellst.
1. Kostenvoranschlag einholen
Abgerechnet wird nach der Länge der Quellaufnahme, aufgerundet auf die nächste volle Minute. Fürelevenlabs-voice-changer sind das 0,35 bis 120, 1,04 bis 240 und 1,73 $ bis 300. Ein 7-sekündiger Clip kostet genauso viel wie einer mit 60 Sekunden, und 60,5 Sekunden werden als zwei Minuten abgerechnet. Wenn du viele kurze Segmente hast, füge sie zu einer Datei zusammen, die unter einer Minutengrenze bleibt, statt jedes einzeln in die Warteschlange zu stellen. Die Stufen stammen aus pricing.durations in /models.
Quote erwartet eine ganze Zahl von Sekunden und benötigt keinen API-Key:
2. Konvertierung in die Warteschlange stellen
Sende die Aufnahme entweder als Multipart-file-Upload oder als audio_url in einem JSON-Body, aber nicht beides. Eine URL muss ohne Header oder Cookies öffentlich erreichbar sein; Venice ruft die Bytes selbst ab und gibt die URL niemals an den Provider weiter. Venice prüft die Bytes, nicht die Dateiendung, eine Datei muss also tatsächlich in einem der akzeptierten Container vorliegen, und Dateien mit einer Videospur werden abgelehnt.
Wenn du curl -F verwendest, setze Content-Type nicht selbst, damit curl die Multipart-Boundary setzen kann, und sende remove_background_noise als true/false und seed als Ziffern.
voice weg, um default_voice zu erhalten. Wenn supports_custom_voice_id true ist, kann voice auch eine Provider-Voice-ID sein; bei elevenlabs-voice-changer heißt das: jede ElevenLabs-Stimme, auf die du Zugriff hast, einschließlich Bibliotheksstimmen, die nicht in Venices voices-Liste stehen. remove_background_noise und seed werden nur akzeptiert, wenn das Modell Unterstützung dafür angibt.
Die Antwort liefert dir das Handle für alles Weitere:
duration_seconds ist die Länge, die Venice gemessen hat, und die Stufe, nach der abgerechnet wurde. Wenn du einen Kostenvoranschlag für 60 eingeholt hast und hier 61.2 steht, hast du zwei Minuten bezahlt. Speichere model und queue_id; Retrieve und Complete benötigen beide Werte, und die ID ist 24 Stunden lang gültig.
Berechnet wird zu diesem Zeitpunkt, nicht erst, wenn das Audio zurückkommt, also wiederhole keine Queue-Anfrage. Wenn du eine queue_id hast, frage damit den Status ab. Wenn die Antwort nie angekommen ist, kann dir ein erneutes Senden der Aufnahme ein zweites Mal berechnet werden. Queue ist auf 40 Anfragen pro Minute begrenzt und Retrieve auf 120; beide melden x-ratelimit-remaining-requests.
3. Status abfragen und herunterladen
Rufe Retrieve mit den Werten aus der Queue-Antwort auf:audio/mpeg, und der Body ist die MP3. Verzweige anhand von Content-Type.
Die beiden Zahlen sind Millisekunden: wie lange Jobs mit diesem Modell üblicherweise dauern und wie lange deiner bereits läuft. Die Differenz ist ein sinnvoller erster Wartewert, aber der Durchschnitt ist nur ein Anhaltspunkt. Eine 148-sekündige Quelle brauchte 24 Sekunden bei einem Durchschnitt von 7, bei längeren Eingaben überholt execution_duration also average_execution_time. Wenn das passiert, wechsle zu einem festen Intervall von ein paar Sekunden und frage weiter ab. Bei kurzen Clips ist es umgekehrt: Das 7-Sekunden-Beispiel kam schon bei der allerersten Abfrage zurück.
Die fertige Antwort enthält x-venice-audio-duration (Sekunden), x-venice-inference-time, x-venice-audio-format, x-venice-model-id und x-venice-model-name. Die Ausgabe ist immer eine Mono-MP3 mit 128 kbps und 44,1 kHz, unabhängig davon, was du gesendet hast. Die Audiodauer sollte bis auf wenige Millisekunden mit deiner Quelle übereinstimmen; weicht sie stärker ab, hör dir das Ergebnis an, bevor du es auslieferst.
Wenn etwas schiefgeht
Ein Job, den der Provider angenommen hat und der dann fehlgeschlagen ist, kommt mit einem Fehlerstatus underror sowie credits_refunded im Body zurück. true bedeutet, dass der berechnete Betrag storniert wurde. false mit einer Meldung, die auf “please contact support” endet, bedeutet, dass die Erstattung selbst fehlgeschlagen ist und die nächste Abfrage es erneut versucht. Das Ergebnis wird gespeichert, sodass eine erneute Abfrage es erneut liefert.
Ein Job, der den Provider nie erreicht hat, sieht anders aus. Retrieve meldet bis zu 10 Minuten lang weiterhin PROCESSING, gibt dann 504 zurück und erstattet dir den Betrag. Gib einem Job mit PROCESSING also mindestens so viel Zeit, bevor du ihn als hängengeblieben behandelst. Alle möglichen Endergebnisse findest du in der Retrieve-Referenz.
Aufräumen
Übergib bei Retrievedelete_media_on_completion: true, dann werden die gespeicherten Medien im selben Aufruf gelöscht, der dir das Audio liefert. Jedes spätere Retrieve für diese ID liefert 404. Wenn du mehr als einmal herunterladen möchtest, lass den Parameter weg und rufe Complete auf, wenn du fertig bist. Complete gibt {"success": true} zurück und kann gefahrlos mehrfach aufgerufen werden.
Vollständiges Beispiel
Alles oben Beschriebene von Anfang bis Ende: prüfen, ob die Stimme existiert, Kostenvoranschlag einholen, hochladen, Status abfragen, bis das Audio eintrifft, speichern. Die Frist beträgt 12 Minuten, damit ein Fehler bei der Weiterleitung als Erstattung statt als Timeout sichtbar wird.delete_media_on_completion weg und rufe Complete selbst auf, wenn du die Datei mehr als einmal benötigst.